

MySQL树形目录查询优化:避免函数重复调用导致的性能瓶颈

在MySQL中进行树形目录(如组织架构)查询时,如果在SQL语句中直接对结果集使用树状遍历函数进行判断,会因每行记录重复执行函数而导致查询极慢。通过先计算出所有节点ID字符串,再利用FIND_IN_SET或IN进行过滤,可显著降低查询耗时。
树形查询的性能陷阱
在处理层级数据(如部门表)时,我们通常需要获取某个节点及其所有子孙节点。为了简化代码,很多开发者会选择编写一个存储过程或函数(例如 getDeptList()),用于返回指定父ID下的所有后代ID列表。在实际测试中发现一个典型现象:
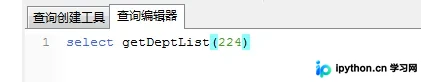
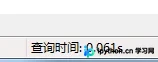
单独调用该函数并查看其执行结果时,速度非常快,能够迅速返回预期的树状列表。然而,当把这个函数放入完整的 SQL 语句中,结合主表(如 self_dept)进行条件判断时,性能却急剧下降。
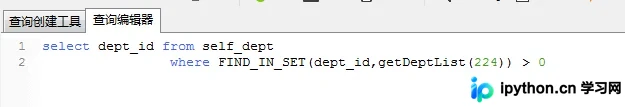
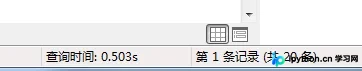
实测数据显示,仅查询出少量(如20条)符合特定条件的数据,耗时竟高达 0.5秒。按照这个线性增长推算,如果业务需要展示数百条数据,响应时间可能超过1秒甚至更久,严重影响用户体验。这种延迟并非来自网络或数据库本身的负载,而是源于SQL的执行逻辑缺陷。
深入分析:函数被重复执行的后果
问题的根源在于 SQL 引擎的处理机制。当你在 SELECT 或 WHERE 子句中直接使用类似以下逻辑的函数时:
SELECT * FROM self_dept WHERE dept_id IN (getDeptList(parent_id))
MySQL 会为结果集中的每一行记录都独立调用一次 getDeptList() 函数。这意味着,如果结果集有20行,该函数就被执行了20次。每一次函数内部都可能包含循环查询、临时表操作或字符串拼接,这些开销在主表遍历时被成倍放大,从而形成了所谓的“重复调用陷阱”。
第1步:分离函数计算与数据过滤
优化的核心思路非常明确:让树状遍历函数只执行一次,将其计算结果缓存到一个临时变量或子查询中,然后再将这个结果作为过滤条件去匹配主表数据。这样可以彻底消除重复计算。
我们可以先通过一个子查询或会话变量获取所有的层级ID集合,然后利用 FIND_IN_SET 或 IN 关键字进行关联判断。优化后的执行方式如下所示:
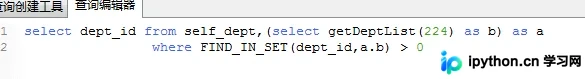
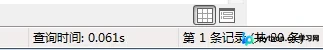
经过重构,原本需要逐行计算的查询模式变为了一次性计算后再做集合匹配。执行结果显示,相同的查询任务耗时直接从 0.5秒 骤降至 0.06秒,效率提升了接近9倍。这种方法不仅解决了性能卡顿,也使得SQL逻辑更加清晰:先生成数据范围,再从范围内筛选目标。
补充:MySQL树形结构的标准处理方法
在实际开发中,除了上述应用层的优化技巧,我们通常还需要能够在SQL层面直接获取完整的树形路径或节点列表。这里分享两种常用的实现方案,适用于不同的业务场景。
方法一:基于会话变量的动态拼接法
利用 MySQL 的会话变量(@pids)和 FIND_IN_SET,可以在单次查询中动态识别子节点。这种方法无需创建外部函数,适合简单的层级扁平化展示。
select dept_id from (
    select t1.dept_id,
    if((find_in_set(parent_id, @pids) > 0 or find_in_set(dept_id, @pids) > 0),
       @pids := concat(@pids, ',', dept_id), 0) as ischild
    from (
        select dept_id,parent_id,dept_name from basis_sys_dept order by parent_id, dept_id
         ) t1,
			(select @pids := id) t2
		) t3 where ischild != 0
注意:此方法高度依赖 order by parent_id, dept_id 的排序顺序。它假设父节点必须先于子节点被扫描到才能被加入 @pids 变量中。如果数据存在父子倒置(子节点排在父节点前面),则可能导致部分子级无法被搜索到。
方法二:基于存储函数的递归查找法
创建一个专门的存储函数,通过 WHILE 循环递归地收集子节点 ID。这种方式不依赖特定的物理排序,逻辑更为稳健,适合复杂的层级深度查询。
delimiter //
CREATE FUNCTION `getLst`(rootId INT)
 RETURNS varchar(1000)
 BEGIN
   DECLARE sTemp VARCHAR(1000);
  DECLARE sTempChd VARCHAR(1000);

  SET sTemp = '$';
  SET sTempChd =cast(rootId as CHAR);

  WHILE sTempChd is not null DO
    SET sTemp = concat(sTemp,',',sTempChd);
    SELECT group_concat(dept_id) INTO sTempChd FROM self_dept where FIND_IN_SET(parent_id,sTempChd)>0;
  END WHILE;
  RETURN sTemp;
END
//
调用此函数时,只需传入根节点ID即可得到一个逗号分隔的ID字符串(如 '$,1,2,4,8')。后续可直接用 FIND_IN_SET('你的ID', getLst(根节点ID)) 来判断某节点是否属于该树分支。
提示:在使用上述代码时,请根据实际业务的表名(如示例中的 self_dept)及字段名(如 dept_id, parent_id)进行调整。
以上就是MySQL树形目录查询中避免重复执行函数以提升性能的详细内容,更多关于MySQL层级数据高效处理的相关资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









