

Python实现高斯判别分析算法详解与代码示例

本文详细介绍高斯判别分析(GDA)算法原理及其Python实现。GDA作为典型的生成学习算法,假设条件概率服从多元正态分布。文章解析了协方差矩阵对分布形态的影响,推导了模型参数估计公式,并提供了基于NumPy和Matplotlib的完整代码示例,展示如何生成数据、计算参数及可视化分类边界。
高斯判别分析算法概述
高斯判别分析算法(Gaussian Discriminant Analysis,简称GDA)
高斯判别算法属于典型的生成学习算法范畴(关于生成式学习算法的更多细节,可参考相关技术博客)。在该算法框架下,我们假设给定类别y时,输入特征x的条件概率p(x|y)服从多元正态分布。
注:在判别学习算法中,通常假设给定特征x时类别y的条件概率p(y|x)服从某种分布。由于实际模型中输入数据X往往具有多个维度,因此在对X的条件概率进行建模时,需采用多维正态分布进行描述,这与判别学习中的假设形成类比。
多元正态分布详解
多元正态分布基础
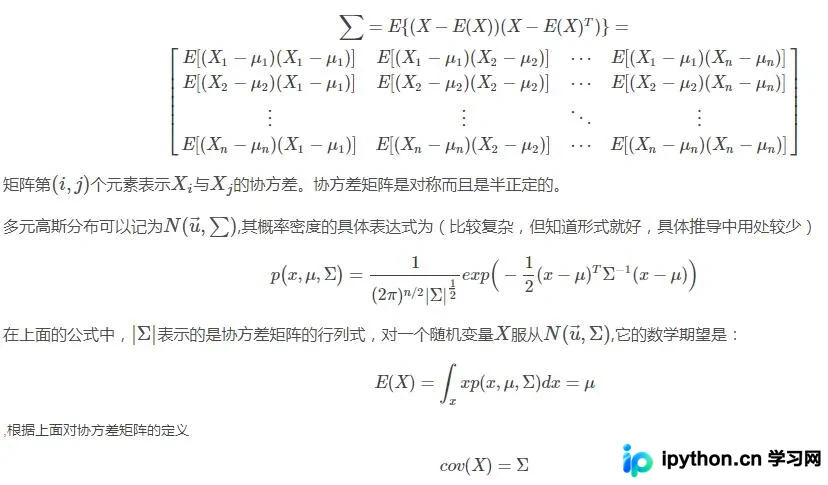
多元正态分布亦称多元高斯分布,该分布由两个关键参数定义:平均向量μ(属于n维实数空间R^n)以及协方差矩阵Σ(属于n×n维实数空间R^{n×n})。
关于协方差矩阵的定义:假设随机变量X是由n个标量随机变量组成的列向量,且μ_k表示第k个元素的期望值,即μ_k=E(X_k),那么协方差矩阵被定义为各元素偏差乘积的期望矩阵。
以下展示了一些二维高斯分布的概率密度函数图像:
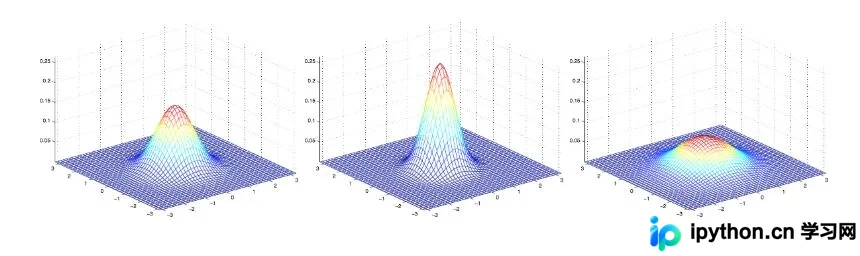
最右侧的图像展示了均值为零向量(2x1维零向量)、协方差矩阵Σ为单位矩阵I(2x2维)的二维高斯分布。此类以零向量为均值、单位阵为协方差的多维高斯分布被称为标准正态分布。中间图像同样以零向量为均值,但协方差矩阵Σ=0.6I;最右侧图像中Σ=2I。观察发现,当Σ的值越大时,高斯分布曲线越“铺开”;当Σ的值越小时,高斯分布曲线越“收缩”。
让我们通过更多示例对比以发现规律。
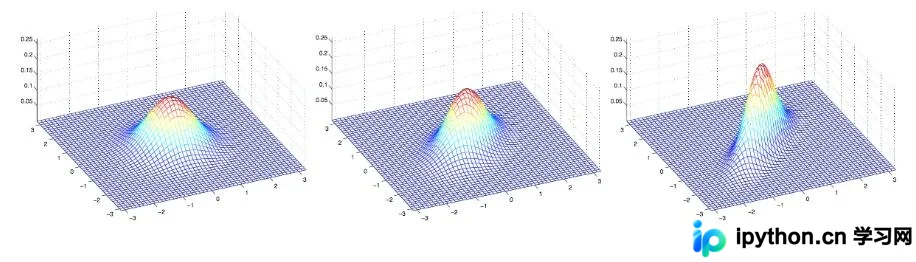
上图中展示的三个高斯分布对应的均值均为零向量,其协方差矩阵分别对应于下方列出的三种情况。
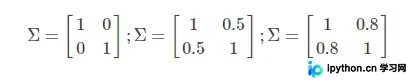
最左侧的图像是我们熟悉的标准二维正态分布。当我们增加Σ的非主对角元素时,可以观察到概率密度图像沿着45°线(即x1=x2方向)发生“收缩”,从对应的等高线轮廓图中可以更清晰地看到这一现象。
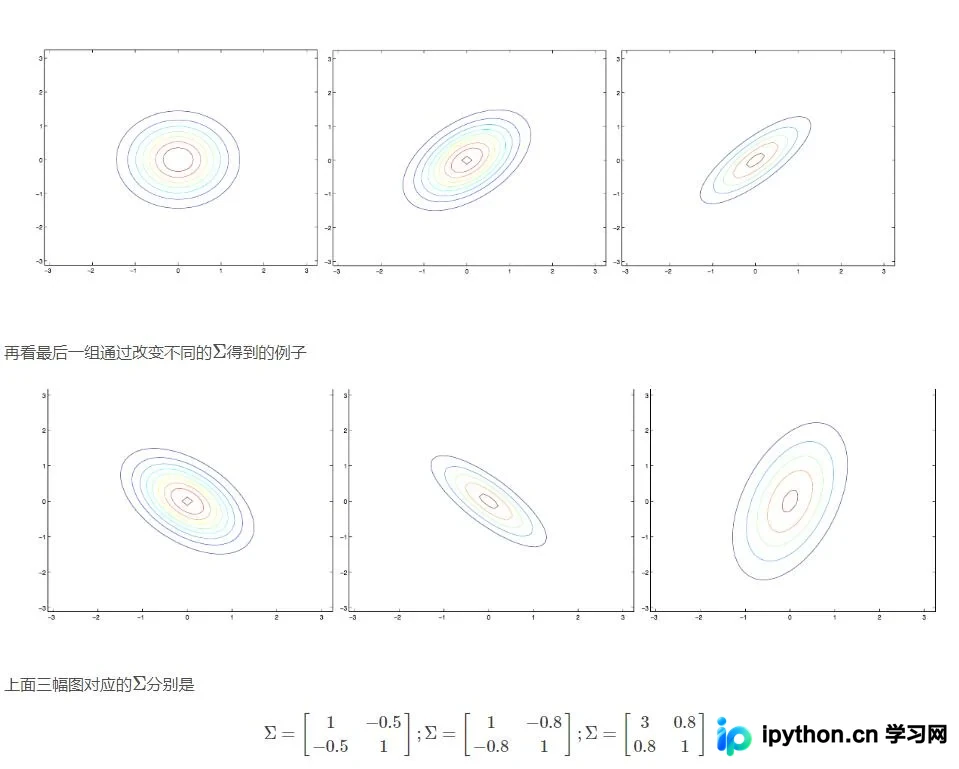
通过对比右侧和中间的两幅图发现,减少主对角元素可以让概率密度图像变得“收缩”,不过这种收缩发生在相反的方向上。
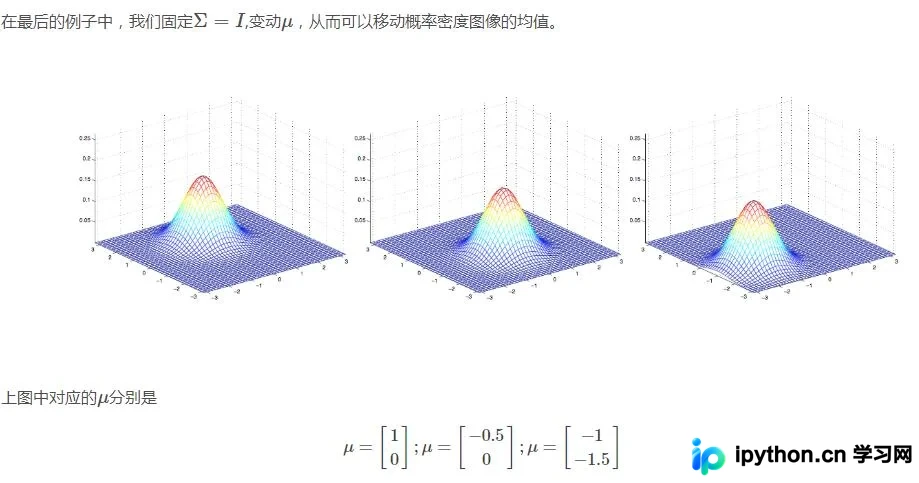
高斯判别分析模型与参数估计
高斯判别分析模型构建
当处理输入特征为连续随机变量x的分类问题时,我们可以使用高斯判别分析模型(GDA)。该模型利用多元正态分布来描述p(x|y),其具体数学表达式如下:
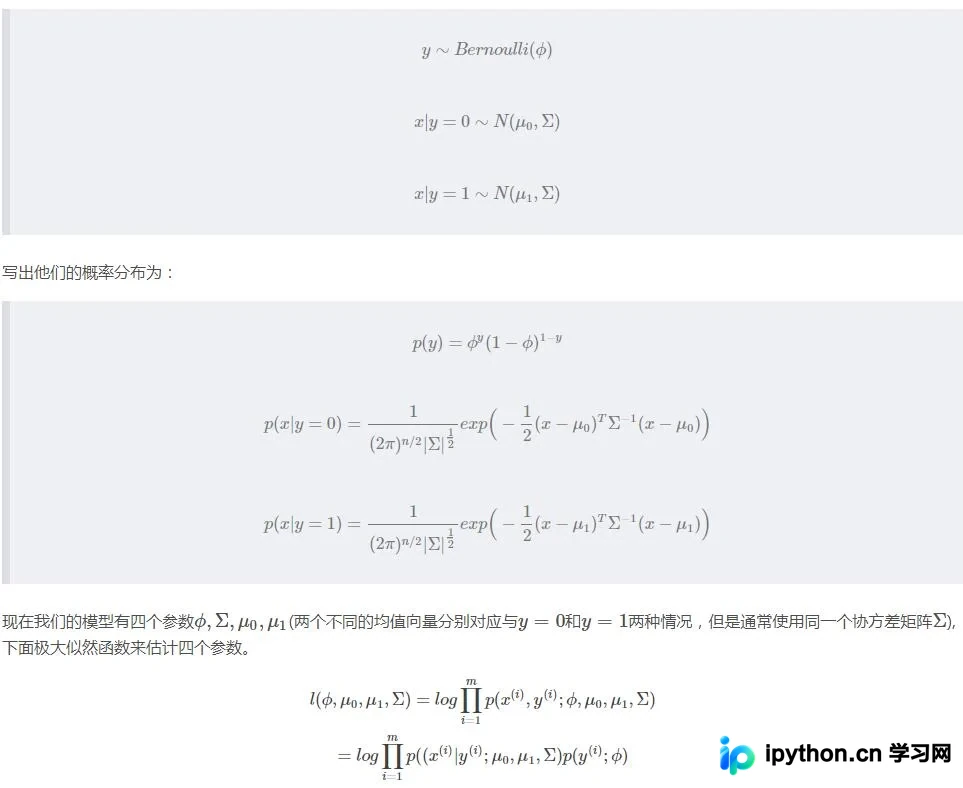
通过对似然函数l进行最大化,可以得到上述四个参数的估计值:
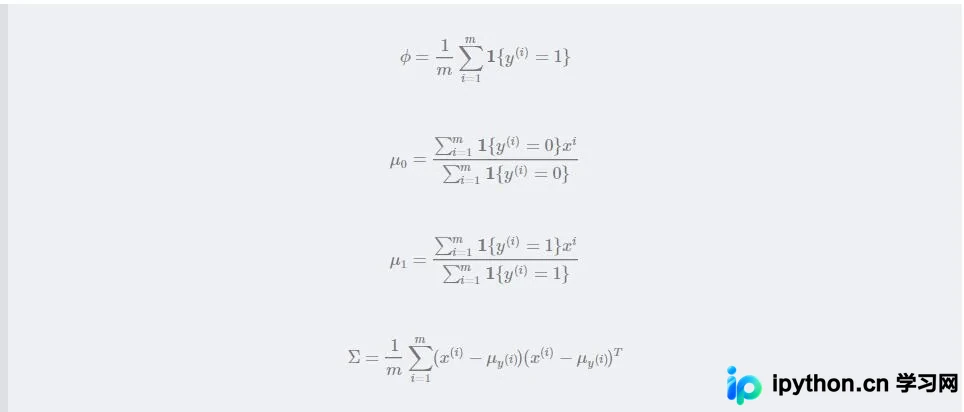
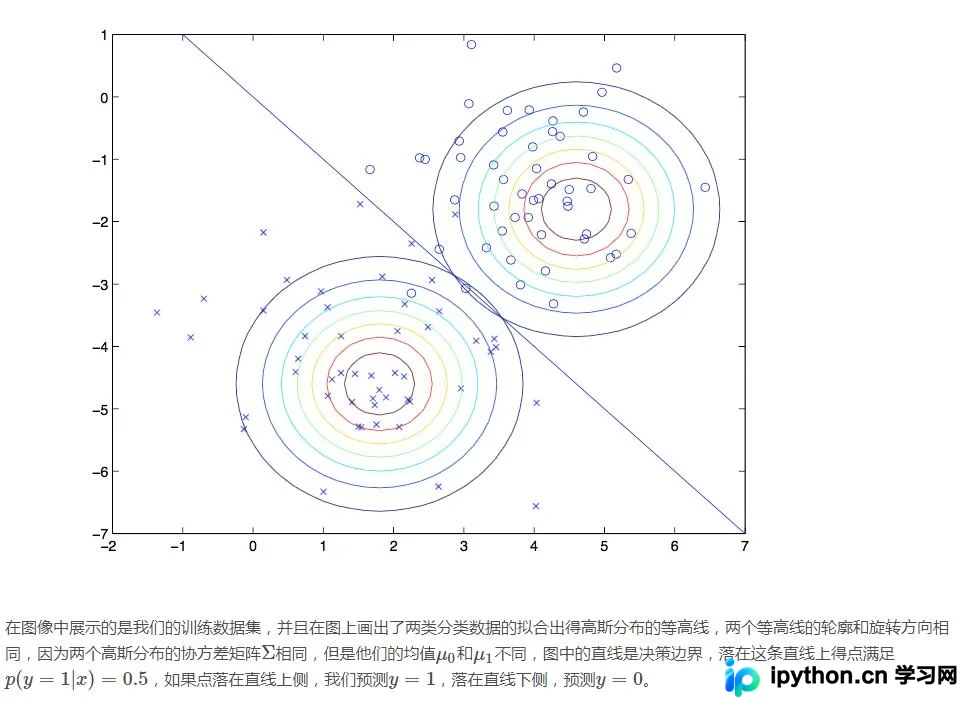
我们用图像直观地描述一下算法处理后的结果:
Python代码实现与结果可视化
以下是Python语言的实现demo代码:
第57行的高斯概率密度函数若直接使用矩阵运算编写可能存在bug导致无法运行。鉴于实验数据仅为二维,因此在纸上对上文中的矩阵运算公式进行了化简,最终结果已写入函数中。如有疑问,读者可拿出笔来演算验证。
#GDA
#author:Xiaolewen
import matplotlib.pyplot as plt
from numpy import *

#Randomly generate two cluster data of Gaussian distributions
mean0=[2,3]
cov=mat([[1,0],[0,2]])
x0=random.multivariate_normal(mean0,cov,500).T #The first class point which labael equal 0
y0=zeros(shape(x0)[1])
#print x0,y0
mean1=[7,8]
cov=mat([[1,0],[0,2]])
x1=random.multivariate_normal(mean1,cov,300).T
y1=ones(shape(x1)[1]) #The second class point which label equals 1
#print x1,y1

x=array([concatenate((x0[0],x1[0])),concatenate((x0[1],x1[1]))])
y=array([concatenate((y0,y1))])
m=shape(x)[1]
#print x,y,m
#Caculate the parameters:\phi,\u0,\u1,\Sigma
phi=(1.0/m)*len(y1)
#print phi
u0=mean(x0,axis=1)
#print u0
u1=mean(x1,axis=1)
#print u1

xplot0=x0;xplot1=x1 #save the original data to plot
x0=x0.T;x1=x1.T;x=x.T
#print x0,x1,x
x0_sub_u0=x0-u0
x1_sub_u1=x1-u1
#print x0_sub_u0
#print x1_sub_u1
x_sub_u=concatenate([x0_sub_u0,x1_sub_u1])
#print x_sub_u

x_sub_u=mat(x_sub_u)
#print x_sub_u

sigma=(1.0/m)*(x_sub_u.T*x_sub_u)
#print sigma

#plot the discriminate boundary ,use the u0_u1's midnormal
midPoint=[(u0[0]+u1[0])/2.0,(u0[1]+u1[1])/2.0]
#print midPoint
k=(u1[1]-u0[1])/(u1[0]-u0[0])
#print k
x=range(-2,11)
y=[(-1.0/k)*(i-midPoint[0])+midPoint[1] for i in x]


#plot contour for two gaussian distributions
def gaussian_2d(x, y, x0, y0, sigmaMatrix):
 return exp(-0.5*((x-x0)**2+0.5*(y-y0)**2))
delta = 0.025
xgrid0=arange(-2, 6, delta)
ygrid0=arange(-2, 6, delta)
xgrid1=arange(3,11,delta)
ygrid1=arange(3,11,delta)
X0,Y0=meshgrid(xgrid0, ygrid0) #generate the grid
X1,Y1=meshgrid(xgrid1,ygrid1)
Z0=gaussian_2d(X0,Y0,2,3,cov)
Z1=gaussian_2d(X1,Y1,7,8,cov)

#plot the figure and add comments
plt.figure(1)
plt.clf()
plt.plot(xplot0[0],xplot0[1],'ko')
plt.plot(xplot1[0],xplot1[1],'gs')
plt.plot(u0[0],u0[1],'rx',markersize=20)
plt.plot(u1[0],u1[1],'y*',markersize=20)
plt.plot(x,y)
CS0=plt.contour(X0, Y0, Z0)
plt.clabel(CS0, inline=1, fontsize=10)
CS1=plt.contour(X1,Y1,Z1)
plt.clabel(CS1, inline=1, fontsize=10)
plt.title("Gaussian discriminat analysis")
plt.xlabel('Feature Dimension (0)')
plt.ylabel('Feature Dimension (1)')
plt.show(1)
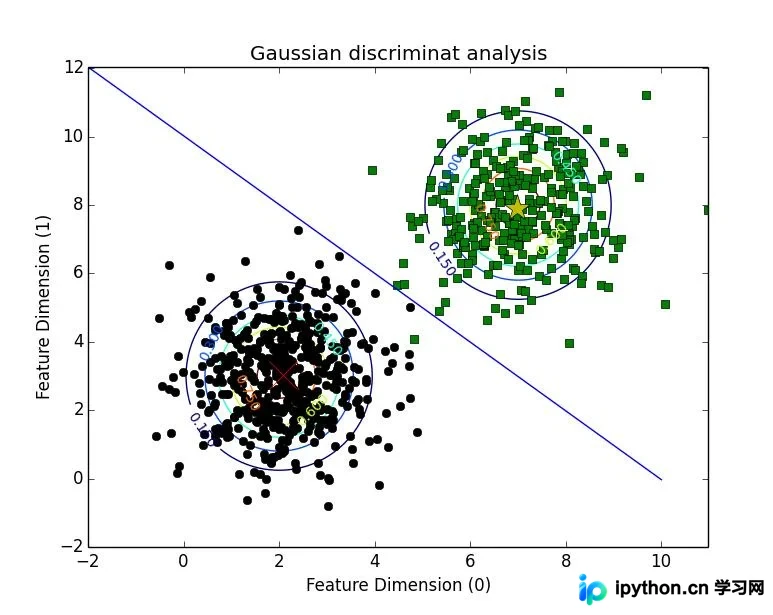
这是最终的拟合结果展示:
以上这篇关于Python实现高斯判别分析算法的例子就是小编分享给大家的全部内容了,希望能给大家提供一个参考,也希望大家多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









