

Python与Redis布隆过滤器原理、实现及缓存击穿解决方案

本文深入解析布隆过滤器这一高效概率型数据结构的原理与应用。通过Python的pybloom库及Redis的RedisBloom插件,详细演示了布隆过滤器的安装、配置及代码实现。重点探讨了其在URL去重、反垃圾邮件及缓存穿透防护中的实际应用,并提供了利用布隆过滤器解决缓存击穿问题的具体方案与代码示例。
在研究redis技术时,常会遇到缓存击穿这一挑战。文中提及的一种有效应对策略是引入布隆过滤器,因此有必要对其概念进行梳理。参考了多篇技术博客后,特此整理一份总结以供记录。
布隆过滤器简介与原理
一、布隆过滤器简介
什么是布隆过滤器?
布隆过滤器(Bloom Filter)本质上是一种数据结构,属于巧妙的概率型数据结构(probabilistic data structure)。其核心优势在于高效的插入与查询性能,主要功能是判断“某样东西一定不存在”或“可能存在”。
与传统的数据结构如 Set 或 Map 相比,布隆过滤器占用空间更少且效率更高。然而,其代价是查询结果具有概率性,而非绝对确定的。
布隆过滤器原理
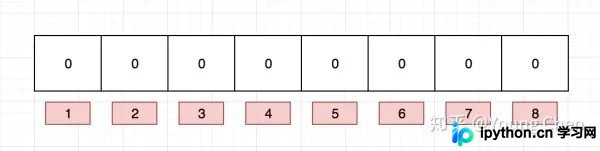
布隆过滤器内部维护一个bitArray(位数组),初始状态下所有位均置为 0。当插入一个元素时,系统通过多个哈希函数(hash1, hash2, hash3 等)计算出不同的哈希值,并定位到bitArray中对应的下标位置,将该位置的 0 修改为 1。需要注意的是,布隆过滤器存在误判率的概念:误判率越低,所需的数组长度越长,占用空间越大;反之,误判率越高,数组可越短,占用空间越小。
以下以网址为例进行说明,布隆过滤器的初始状态如下图所示:
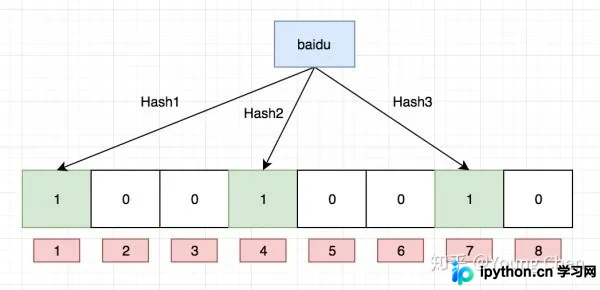
现在需要将baidu这个URL插入布隆过滤器。经过3个哈希函数的计算,得到的哈希值分别为1、4、7。因此,需要将布隆过滤器中对应的bit位置为1,效果如下图所示:
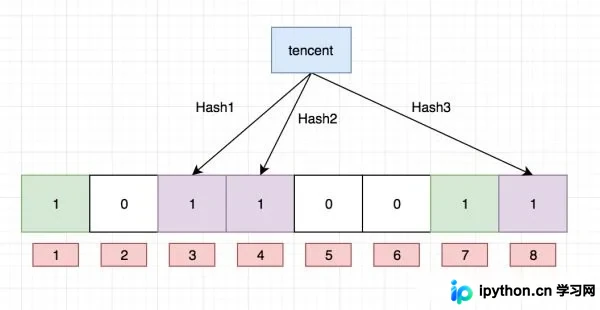
接下来,继续向布隆过滤器中添加tencent这个URL。计算得到的哈希值分别为3、4、8,并继续将对应的bit位置1。这里需要注意一个关键点:上述两个URL计算出的哈希值中,值4是重复的。这种现象正是布隆过滤器无法确认某个元素一定存在的原因。最终状态如下图所示:
布隆过滤器的查询过程同样简单。例如,我们需要查找python,只需计算其哈希值。如果计算出的值为2、4、7,由于对应bit位上存在不为1的情况,则可以断言python一定不存在。但如果计算出的哈希值是1、3、7,则只能判断python可能存在。这个例子表明,虽然我们没有存入python,但由于其他Key存储时返回的哈希值恰好占用了python计算出的哈希值对应的bit位,导致无法准确判断python是否存在。
因此,随着添加的值越来越多,被占用的bit位也随之增加,误判的可能性逐渐升高。如果布隆过滤器的所有bit位都被置为1,那么所有Key都可能被视为存在,此时布隆过滤器便失去了过滤功能。由此可见,选择合适的过滤器长度至关重要。
从布隆过滤器的实现原理可以看出,它不支持删除操作。一旦将某个Key对应的bit位置0,可能会导致同样bit位的其他Key的存在性判断出现错误。
布隆过滤器的准确性
布隆过滤器的核心思想包含两点:
使用多个Hash函数,增大随机性,减少Hash碰撞的概率;扩大数组范围,使Hash值均匀分布,进一步减少Hash碰撞的概率。
尽管布隆过滤器已尽可能减小Hash碰撞的概率,但无法彻底消除。正如上述小例子所示,布隆过滤器只能告诉我们某样东西“一定不存在”或“可能存在”。
关于布隆过滤器的数组大小及相应Hash函数个数的选择,可参考其他技术博客或维基百科对应词条的结果:Probability of false positives。
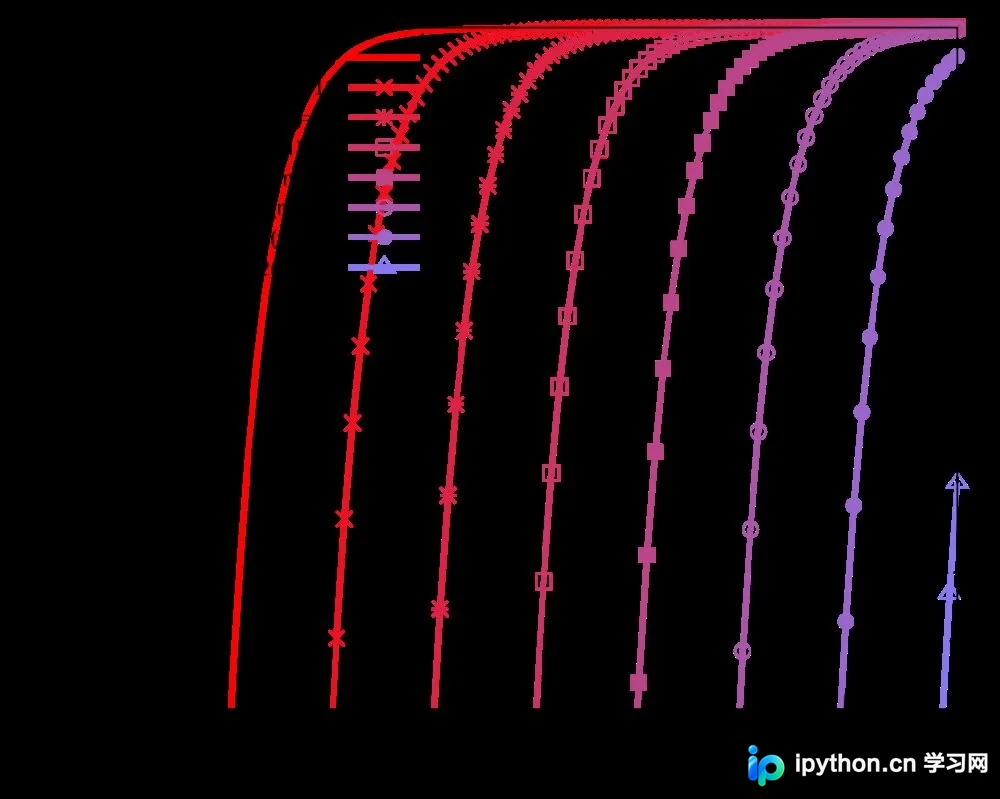
上图的纵坐标p代表误判率,横坐标n表示插入的元素个数,m表示布隆过滤器的bit长度。当然,上图结果的成立都假设Hash函数的个数k满足条件k = (m/n)ln2(忽略k是整数)。
从上述结果来看,选择合适的参数后,误判率通常较低。
布隆过滤器的应用场景
布隆过滤器的应用
- 网页爬虫对URL的去重,避免爬取相同的URL地址。
- 反垃圾邮件,从数十亿个垃圾邮件列表中判断某邮箱是否垃圾邮箱(同理适用于垃圾短信)。
- 缓存穿透,将所有可能存在的数据缓存放到布隆过滤器中。当黑客访问不存在的缓存时,迅速返回避免缓存及数据库挂掉。
- 黑名单过滤。
Python中布隆过滤器的实现
二、python中使用布隆过滤器
- 首先访问该网站下载
bitarray依赖包https://www.lfd.uci.edu/~gohlke/pythonlibs/#bitarray。 - 直接安装可能会报错
error: Microsoft Visual C++ 14.0 is required. Get it with "Build Tools for Visual Studio": https://visualstudio.microsoft.com/downloads/。 - 因此需要手动安装
wheel文件,以防止主动安装时报错pip3 install bitarray-1.1.0-cp36-cp36m-win_amd64.whl。 pip3 install pybloom_live
使用案例如下:
from pybloom_live import ScalableBloomFilter, BloomFilter

# 可自动扩容的布隆过滤器
bloom = ScalableBloomFilter(initial_capacity=100, error_rate=0.001)

url1 = 'http://www.baidu.com'
url2 = 'http://qq.com'

bloom.add(url1)
print(url1 in bloom)
print(url2 in bloom)
Copy
# BloomFilter 是定长的
from pybloom_live import BloomFilter

url1 = 'http://www.baidu.com'
url2 = 'http://qq.com'

bf = BloomFilter(capacity=1000)
bf.add(url1)
print(url1 in bf)
print(url2 in bf)
Redis中布隆过滤器的配置与使用
三、redis中使用布隆过滤器
详细文档可参考官方文档。
该模块不仅实现了布隆过滤器,还实现了CuckooFilter(布谷鸟过滤器)以及TopK功能。CuckooFilter是在BloomFilter的基础上,主要解决了BloomFilter不能删除的缺点。下文仅说明布隆过滤器的相关内容。
安装
传统的redis服务器安装RedisBloom插件,详情可参考CentOS中安装Redis插件bloom-filter的相关教程。
此处使用Docker进行安装,过程简单快捷。
docker pull redislabs/rebloom:latest
docker run -p 6379:6379 --name redis-redisbloom redislabs/rebloom:latest
docker exec -it redis-redisbloom /bin/bash
命令
命令使用非常简单。
reserve
bf.reserve {key} {error_rate} {size}创建一个空的名为key的布隆过滤器,并设置期望的错误率和初始大小。{error_rate}过滤器的错误率在0-1之间。
127.0.0.1:6379> bf.reserve black_male 0.001 1000
OK
add, madd
bf.add {key} {item}
bf.madd {key} {item} [item…]
用于往过滤器中添加元素。如果Key不存在,过滤器会自动创建。
127.0.0.1:6379> bf.add test 123
(integer) 1
127.0.0.1:6379> bf.madd urls baidu google tencent
1) (integer) 0
2) (integer) 0
3) (integer) 1
# 上面已经存在的值再次添加会返回0, 不存在则返回1
exists, mexists
bf.exists {key} {item}
bf.mexists {key} {item} [item…]
用于判断过滤器中是否存在该元素,不存在返回0,存在返回1。
127.0.0.1:6379> bf.exists test 123
(integer) 1
127.0.0.1:6379> bf.mexists urls baidu google hello
1) (integer) 1
2) (integer) 1
3) (integer) 0
Python调用Redis布隆过滤器插件
四、python程序中使用redisbloom
使用redisbloom这个模块来操作redis的布隆过滤器插件。
pip3 install redisbloom
使用方法,参考官方给出的例子即可:https://github.com/RedisBloom/redisbloom-py。
# 自己的简单使用
from redisbloom.client import Client

# 因为我使用的是虚拟机中docker的redis, 填写虚拟机的ip地址和暴露的端口
rb = Client(host='192.168.12.78', port=6379)
rb.bfAdd('urls', 'baidu')
rb.bfAdd('urls', 'google')
print(rb.bfExists('urls', 'baidu')) # out: 1
print(rb.bfExists('urls', 'tencent')) # out: 0

rb.bfMAdd('urls', 'a', 'b')
print(rb.bfMExists('urls', 'google', 'baidu', 'tencent')) # out: [1, 1, 0]
误判率的测试demo
def _test1(size, key='book'):
 """测试size个不存在的"""
 rb.delete(key) # 先清空原来的key
 insert(size, key)
 select(size, key)


def _test2(size, error=0.001, key='book'):
 """指定误差率和初始大小的布隆过滤器"""
 rb.delete(key)

 rb.bfCreate(key, error, size) # 误差率为0.1%, 初始个数为size

 insert(size, key)
 select(size, key)


if __name__ == '__main__':
 # The default error rate is 0.01 and the default initial capacity is 100.
 # 这个是默认的配置, 初始大小为100, 误差率默认为0.01
 _test1(1000)
 _test1(10000)
 _test1(100000)
 _test2(500000)
Copy
# 输出的结果

插入结束... 花费时间: 0.0409s
size: 1000, 误判元素个数: 14, 误判率1.4000%
查询结束... 花费时间: 0.0060s
******************************
插入结束... 花费时间: 0.1389s
size: 10000, 误判元素个数: 110, 误判率1.1000%
查询结束... 花费时间: 0.0628s
******************************
插入结束... 花费时间: 0.5372s
size: 100000, 误判元素个数: 1419, 误判率1.4190%
查询结束... 花费时间: 0.4318s
******************************
插入结束... 花费时间: 1.9484s
size: 500000, 误判元素个数: 152, 误判率0.0304%
查询结束... 花费时间: 2.2177s
******************************
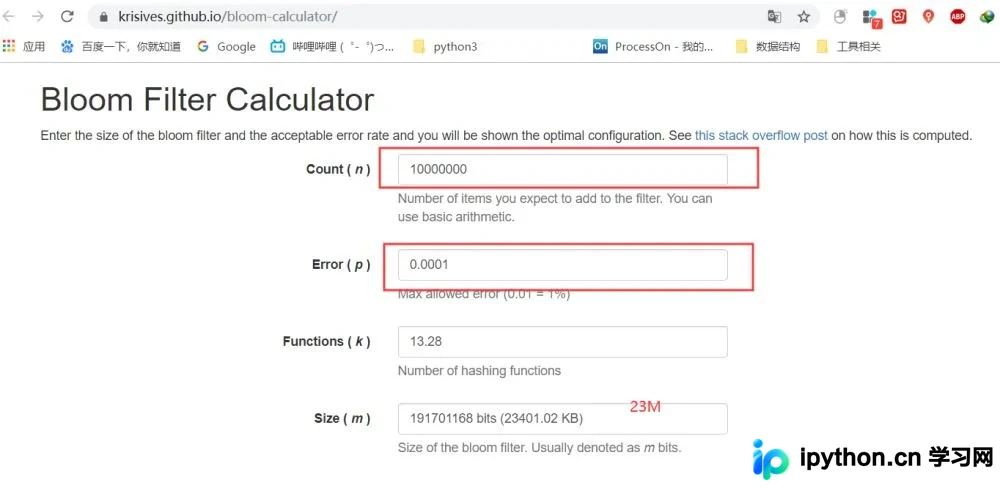
如果想要布隆过滤器知道具体的耗费内存大小以及对应的错误率的信息,可以使用查看这个布隆过滤器计算器计算出最后的结果。就如下面所示,1kw数据,误差为0.01%,只需要23M内存。
利用布隆过滤器解决缓存击穿
五、缓存击穿
现在回到开头的问题,即解决缓存击穿的问题。
什么是缓存击穿
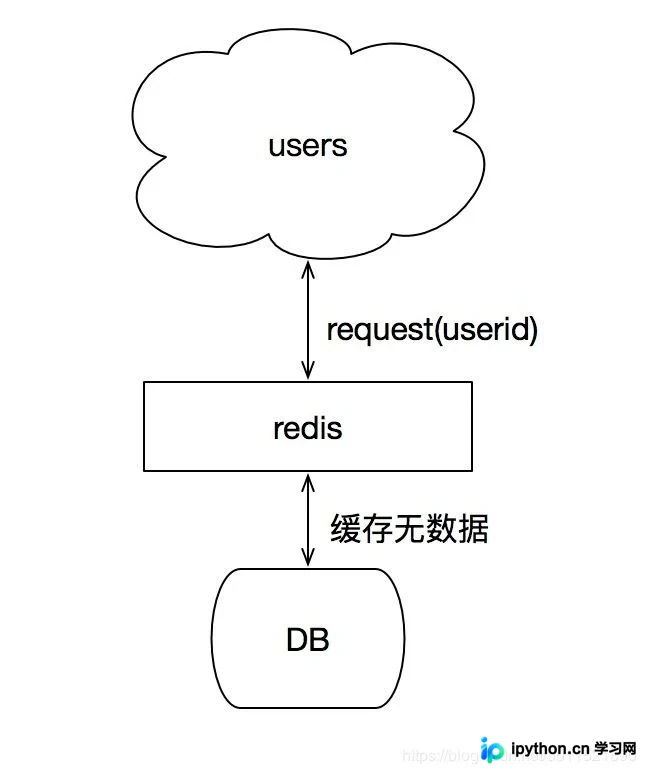
我们通常使用redis作为数据缓存。当请求进来时,先通过key去redis缓存查询,如果缓存中数据不存在,需要去查询数据库的数据。当数据库和缓存中都不存在的数据来查询时,请求都打在数据库的请求中。如果这种请求量很大,会给数据库造成更大的压力,进而影响系统的性能。
解决这类问题的方法
方法一:当DB和redis中都不存在key,在DB返回null时,在redis中插入`当key再次请求时,redis直接返回null`,而不用再次请求DB。
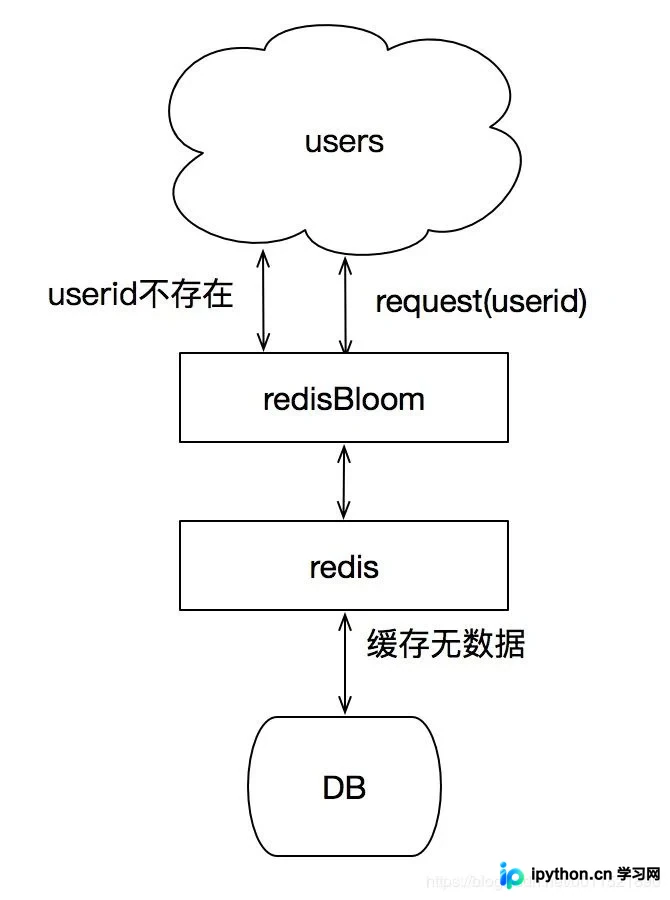
方法二:使用redis提供的redisbloom,同样是将存在的key放入到过滤器中。当请求进来时,先去过滤器中校验是否存在,如果不存在直接返回null。
黑名单的小例子
import redis
from redisbloom.client import Client

# 创建一个连接池来进行使用
pool = redis.ConnectionPool(host='192.168.12.78', port=6379, max_connections=100)


def create_key(key, error, capacity):
 rb = Client(connection_pool=pool)
 rb.bfCreate(key, errorRate=error, capacity=capacity)


def get_item(key, item):
 """判断是否存在"""
 rb = Client(connection_pool=pool)
 return rb.bfExists(key, item)


def add_item(key, item):
 """添加值"""
 rb = Client(connection_pool=pool)
 return rb.bfAdd(key, item)


if __name__ == '__main__':
 # 添加黑名单, 误差为0.001, 大小为1000
 create_key('blacklist', 0.001, 1000)
 add_item('blacklist', 'user:1')
 add_item('blacklist', 'user:2')
 add_item('blacklist', 'user:3')
 add_item('blacklist', 'user:4')
 print('user:1是否在黑名单-> ', get_item('blacklist', 'user:1'))
 print('user:2是否在黑名单-> ', get_item('blacklist', 'user:2'))
 print('user:6是否在黑名单-> ', get_item('blacklist', 'user:6'))
总结
以上所述是小编给大家介绍的python实现布隆过滤器及原理解析,希望对大家有所帮助。如果大家有任何疑问欢迎给我留言,小编会及时回复大家的!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









