

使用 Python 脚本自动化清理浏览器失效书签

本文介绍如何利用 Python 自动清理浏览器收藏夹中的失效链接。通过读取导出的 HTML 书签文件,利用正则表达式提取网址,并结合 requests 库进行 HTTP 状态码检测。脚本能自动识别 404 错误、连接超时及反爬屏蔽页面,保留有效链接并生成新的书签文件,帮助开发者高效维护浏览器收藏列表。
引言:收藏夹管理的痛点
失效的书签们
在日常浏览网页时,我们常会遇到一些有趣或实用的内容,于是习惯性地点击收藏或添加书签。然而,随着时间推移,收藏夹中堆积成百上千个链接,整理起来往往令人头疼。
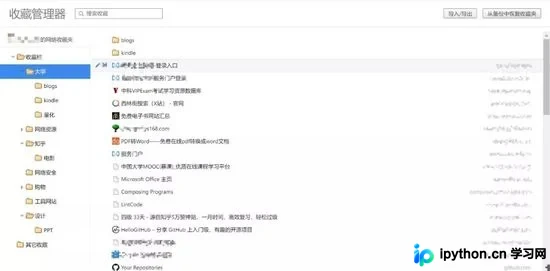
特别是那些昨天还在更新的技术博客,今天可能已经停止维护;或者是曾经热门的电影网站,如今直接显示 404 错误。面对大量失效页面,每次手动打开确认并删除不仅耗时,也不符合程序员追求效率的原则。
目前无论是 Google Chrome 还是国内主流浏览器,大多仅提供收藏夹的备份功能,缺乏自动清理失效链接的能力。因此,使用 Python 编写一个自动化脚本成为最佳解决方案。
技术原理:文件格式与解析思路
Python支持的收藏夹文件格式
由于浏览器对收藏夹的直接访问权限有限,我们通常只能手动导出为 .htm 文件进行管理。
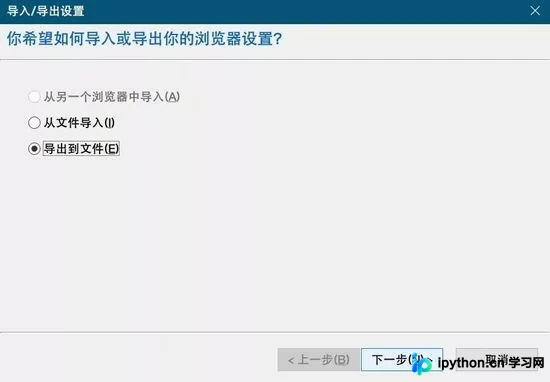
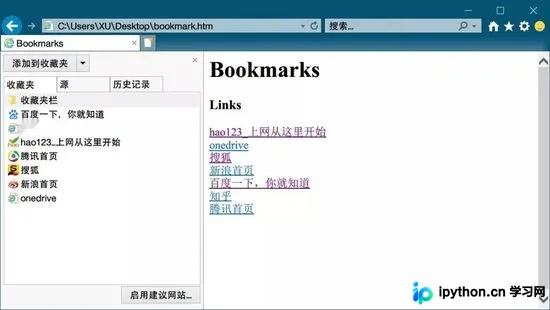
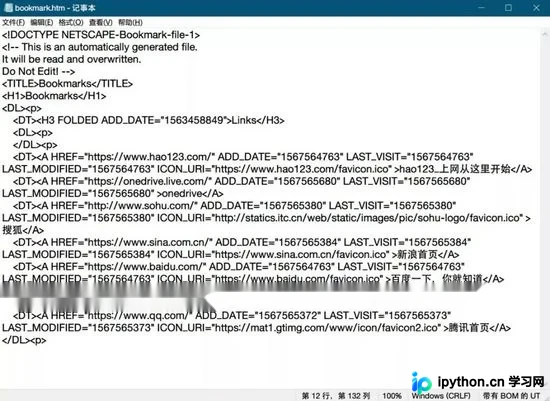
导出的 HTML 文件结构相对简单,即使对前端技术了解不深,也能清晰辨认其中的树形结构和逻辑关系。
固定格式 网址 固定格式 页面名 固定格式
基于此,我们可以利用正则表达式进行匹配。主要涉及两个子串:一个是链接地址,另一个是页面标题。提取这些内容后,逐个访问检查状态,若发现失效则删除,从而获得清理后的干净收藏夹。
读取收藏夹文件
实现步骤:文件读取与正则匹配
path = "C:\\Users\\XU\\Desktop"
fname = "bookmarks.html"
os.chdir(path)
bookmarks_f = open(fname, "r+" ,encoding='UTF-8')
booklists = bookmarks_f.readlines()
bookmarks_f.close()
由于对前端结构不熟悉,我们可以将导出的收藏夹文件抽象分为两部分进行处理。
- 结构代码
- 保存网页书签的关键代码
其中,结构代码部分必须原封不动地保留,以维持浏览器的正常导入格式;而保存网页书签的关键代码部分,则需要提取内容并进行判断,决定保留或删除。
因此,这里采用 readlines 函数逐行读取文件,并对每一行进行单独判断。
正则匹配
pattern = r'href="(.*?)" rel="external nofollow" .*?>(.*?)</A>'
while len(booklists)> 0 :
bookmark = booklists.pop( 0 )
detail = re.search(pattern, bookmark)
当匹配到关键代码时,提取出的子串分别位于 detail.group(1)(链接)和 detail.group(2)(标题)中。
若匹配结果为 detail == None,则说明该行属于结构代码,无需处理,直接保留即可。
访问页面
核心逻辑:页面访问与状态判断
import requests
r = requests. get (detail. group ( 1
),timeout=
500
)
在编写代码测试过程中,我们发现主要存在以下四种情况:
r.status_code == requests.codes.ok
r.status_code==404
r.status_code!=404 && 无法访问 (可能是屏蔽爬虫,建议保留)
requests.exceptions.ConnectionError
类似知乎、简书等网站通常具备反爬机制,简单的 GET 请求无法有效访问,且处理这些细节成本较高,因此建议直接保留。对于其他错误,直接使用 try-except 抛出异常即可,避免程序因单个链接失败而中断运行。
添加逻辑后: (代码可左右拖动)
完整代码与结果处理
while len ( booklists )>0:
= booklists.pop( 0 )
detail = re.search(pattern, bookmark)
if detail:
#print(detail.group(1) +"----"+ detail.group(2))
try :
#访问
r = requests. get (detail. group ( 1 ),timeout= 500 )
#如果可则添加
if r.status_code == requests.codes.ok:
new_lists.append(bookmark)
print( "ok------ 保留:" + detail. group ( 1 )+ "  " + detail. group ( 2 ))
else :
if (r.status_code== 404 ):
print( "不可访问 删除:" + detail. group ( 1 )+ "  " + detail. group ( 2 ) + '错误码 ' +str(r.status_code))
else :
print( "其他原因 保留:" + detail. group ( 1 )+ "  " + detail. group ( 2 ) + '错误码 ' +str(r.status_code))
new_lists.append(bookmark)
except:
print( "不可访问 删除:" + detail. group ( 1 )+ "  " + detail. group ( 2 ))
#new_lists.append(bookmark)
else : #没匹配到是结构语句
new_lists.append(bookmark)
程序执行情况
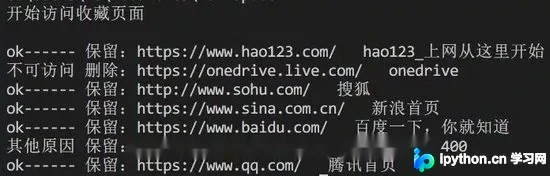
导出htm
bookmarks_f = open ( 'new_' +fname, "w+" ,encoding= 'UTF-8' )
bookmarks_f.writelines(new_lists)
bookmarks_f.
close
()
导入浏览器
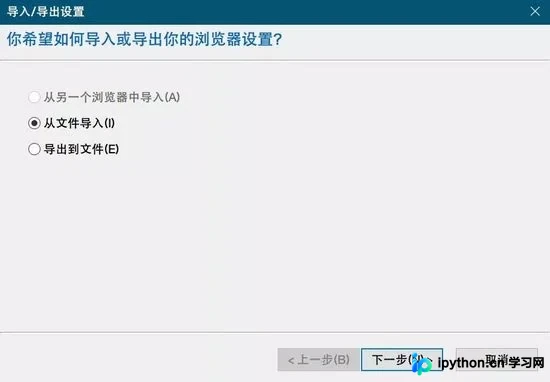
实际应用于我的浏览器
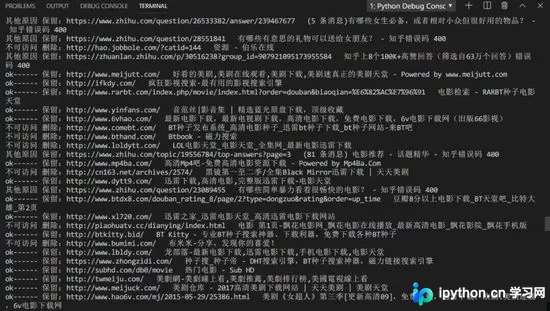
经过实际应用,确实发现许多电影网站已失效。通过 Python 脚本,可以一键清理其中无法访问的书签。正如所言,人生苦短,Python 的确能让生活更高效。
总结
总结
以上介绍了使用 Python 清理收藏夹中已失效网站的方法,希望对大家有所帮助。如有任何疑问,欢迎留言,小编会及时回复。感谢大家对本站的支持! 如果你觉得本文对你有帮助,欢迎转载,烦请注明出处,谢谢!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









