

Python递归与迭代原理深度解析:机制、限制与性能对比

本文深入解析Python中函数递归与迭代的核心原理。详细阐述递归的工作机制、边界条件及尾递归概念,重点说明Python对递归深度的限制(默认1000层)及栈内存约束。通过十进制转二进制的实例演示回溯与递推过程,并对比递归与迭代的代码结构、执行效率及适用场景,为开发者提供性能优化的实践参考。
Python递归与迭代原理深度解析:机制、限制与性能对比
本文详细解析Python中函数递归与迭代的工作机制,结合具体示例代码进行说明,旨在为相关学习与工作提供具有实际价值的参考。
一、递归机制解析
一、递归机制解析
1、递归的基本概念
什么是递归?
递归(recursion)是指程序调用自身的编程技巧,作为一种算法在程序设计语言中广泛应用。其核心思想是将一个大型复杂的问题层层转化为与原问题相似但规模更小的子问题来求解。递归策略的优势在于仅需少量代码即可描述解题过程中所需的多次重复计算,从而显著减少代码量。递归的核心能力在于使用有限的语句定义对象的无限集合。通常,递归包含边界条件、递归前进段和递归返回段三个要素。当边界条件未满足时,执行递归前进;当边界条件满足时,执行递归返回。
使用递归的关键在于必须设置明确的递归结束条件(即递归出口),无论是直接调用还是间接调用自身。若缺乏明确的出口,程序将陷入死循环。
尾递归特性
若函数中所有递归形式的调用均出现在函数末尾,则该递归函数被称为尾递归。当递归调用是函数体中最后执行的语句,且其返回值不作为表达式的一部分时,即为尾递归。尾递归在回归阶段无需执行额外操作,这一特性使得现代多数编译器能够自动生成优化代码。
Python并非函数式编程语言,原生不支持尾递归优化,且对递归深度设有严格限制。当递归深度超过1000层时,系统会抛出异常。尽管可通过sys模块调整递归深度限制,但由于Python未进行尾递归优化,仍需保留栈帧,受限于内存大小,无法实现无限递归。此外,无限制地递归调用自身在逻辑上并无实际意义。
import sys
sys.getrecursionlimit()
sys.setrecursionlimit(2000) # 修改递归深度为2000
2、递归的实际应用
2、递归的实际应用
递归过程可分为两个阶段:回溯与递推。 递推阶段:将复杂问题的求解过程推向比原问题更简单的子问题求解。
回溯阶段:在获得最简单的情况(即递归出口)后,逐步返回结果,依次还原出复杂问题的解。
以下通过具体实例分析该过程:
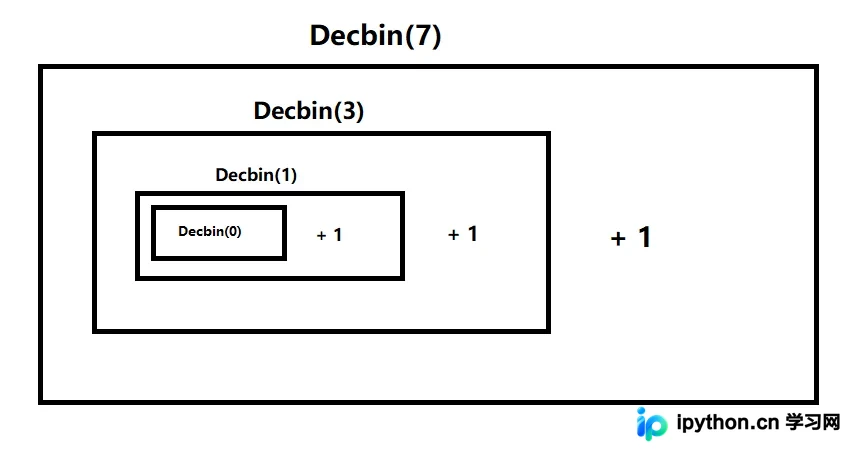
示例为将十进制数转换为二进制数的函数。转换逻辑是将十进制数不断除以2,直至商为0,最后将余数从后往前排列。
def Decbin(x):
  result = ''
  if x:
    return Decbin(x // 2) + str(x % 2)
  else:
    return result
print(Decbin(7))
当传入参数x为7时,由于x不为0,程序进入下一层调用。需注意,此时第一层函数并未结束,而是处于等待下层函数返回结果的状态。接着进入第二层函数,参数为3,同样不为0,于是进入第三层函数,第二层函数亦在等待。以此类推,此过程即为递归函数的回溯阶段。当参数为0时,执行else分支代码,函数不再继续回溯,转而开始向前递推。
二、迭代与递归的对比分析
二、迭代与递归的对比分析
1、什么是迭代?
Python中的迭代是指通过重复执行代码来处理相似数据集的过程。本次迭代处理的数据依赖于上一次的结果,上一次产生的结果构成下一次结果的初始状态。若中途出现停顿,则不构成迭代。常见的for循环遍历对象即为迭代的典型应用。
使用Python实现递归算法时,代码结构通常较为简洁,但执行效率较低。相比之下,迭代算法具有更强的可读性且执行效率极高。因此,在实际应用中运用递归算法时需格外谨慎,需权衡代码简洁性与性能损耗。
以上内容为本文的全部观点,希望能为读者的学习带来帮助,也欢迎大家继续支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









