

python截取字符串:切片语法与split方法的适用场景

先掌握Python字符串切片语法与索引规则
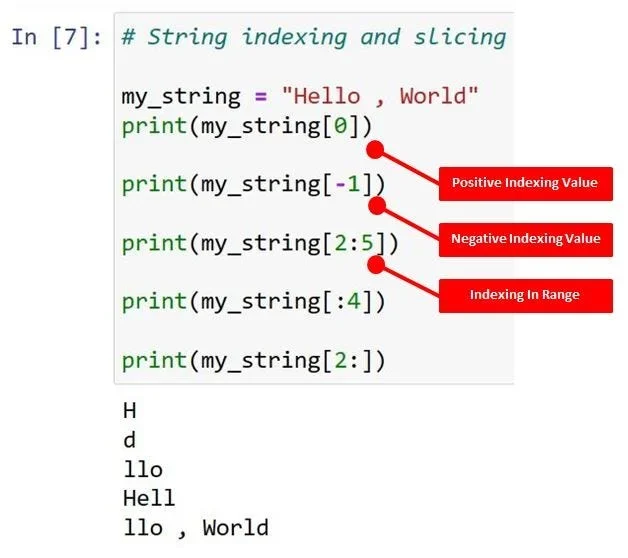
Python字符串的索引从0开始正向递增,同时支持负数索引,-1代表最后一个字符,-2代表倒数第二个,依此类推。切片的核心语法为[start:end:step],其中start为起始索引(包含),end为结束索引(不包含),step为步长(默认为1)。若省略start,默认从头开始;省略end,默认截取到末尾;省略step,默认步长为1。例如定义字符串s = "PythonString",s[0:6]返回"Python",s[:6]效果相同。截取末尾字符可使用负索引,如s[-6:]返回"String"。若要实现倒序,只需将步长设为-1,即s[::-1],结果为"gnirtSnohtyP"。切片操作天然具备边界容错性,即使end超出字符串长度也不会报错,而是自动截断至末尾,这为安全截取提供了极大便利。
根据需求使用split拆分字符串
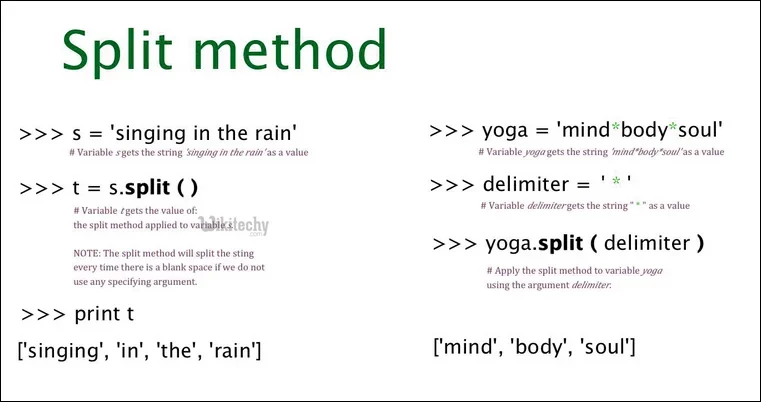
split()方法用于将字符串按指定分隔符拆分为列表,其核心逻辑是基于内容匹配而非固定位置。基本语法为str.split(sep=None, maxsplit=-1)。当不传参数或sep为None时,默认以任意空白字符(空格、制表符、换行符等)作为分隔符,并自动过滤连续空白。例如"a b\tc".split()返回['a', 'b', 'c']。若需按特定符号拆分,可传入sep参数,如"2023-10-01".split("-")得到['2023', '10', '01']。maxsplit参数用于限制拆分次数,"a,b,c,d".split(",", 2)仅执行两次拆分,结果为['a', 'b', 'c,d']。需特别注意,split并非按索引截取,而是根据分隔符的出现位置动态生成子串列表。若原字符串中不存在指定分隔符,split会返回包含原字符串的单元素列表,而非空列表或报错,这一特性在实际数据清洗中需结合条件判断使用。
切片与split怎么选:按位置截取还是按内容拆分
在实际开发中,选择切片还是split取决于数据特征与提取目标。当字符串结构固定且目标子串位置已知时,切片是最高效的选择。例如处理固定格式日志"INFO 20231001 Server started",若只需提取前4个字符的状态码,直接使用log[:4]即可,无需解析内容。反之,当数据由动态分隔符连接且字段长度不固定时,split更为合适。例如解析CSV行"张三,25,工程师",使用line.split(",")能准确提取各字段,不受字符数变化影响。两者常可组合使用以应对复杂场景:先用split按分隔符切分出目标片段,再对片段使用切片去除多余符号。例如"User: admin_01".split(":")[1].strip()[1:],先按冒号拆分取右侧,去除首尾空格后,再用切片跳过首字符。明确位置驱动选切片、内容驱动选split的原则,能显著提升代码可读性与执行效率。
运行验证并避开字符串截取常见错误
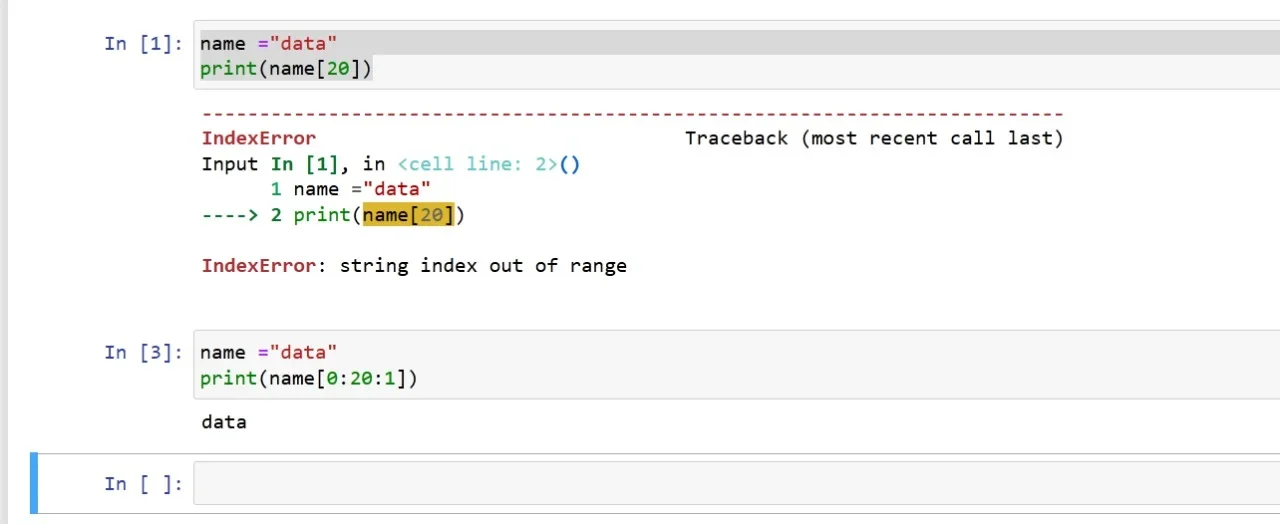
字符串截取虽简单,但边界处理不当极易引发逻辑错误。首先,切片本身不会抛出IndexError,如s = "abc",执行s[10:20]仅返回空字符串"",而非报错,开发者需通过if result:判断有效性。其次,直接通过索引访问如s[5]在越界时会触发IndexError,务必结合len()校验或使用切片替代。对于空字符串"",任何切片均返回"",而"".split()返回空列表[],在循环遍历前需判空。使用split时,若分隔符不存在,返回的是[原字符串],直接解包如a, b = text.split(",")会导致ValueError,应使用if "," in text:预判或捕获异常。此外,split始终返回列表,若只需单个结果,需通过索引提取,如parts[0]。建议在关键截取逻辑后添加print()或assert验证输出类型与长度,确保数据流转符合预期,从而构建健壮的字符串处理流程。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









