


很多团队一提到流程引擎,就会把节点函数越写越重:既依赖一堆运行配置,又混着校验、权限、风控和状态处理,最后很难替换,也很难单测。柯里化在这里的意义,不是把函数拆成好几层调用,而是先把租户、超时、规则、用户等稳定上下文固定下来,再把真正运行时才知道的业务数据留到最后一步输入,这样流程节点才更像可组装的积木。
下面按几个最常见的落点来展开:先看怎么预设节点运行环境,再看如何把校验、转换、决策拆成单职责节点,接着处理真实流程里常见的动态补参与条件跳过,最后再落到流程编排里最关键的结构化 context 传递。读完你可以据此判断,自己的流程节点到底是在“合理拆分”,还是只是把复杂度换了个写法继续堆着。
用柯里化预设节点运行环境
流程节点经常依赖一批共享上下文,比如租户 ID、请求超时、日志前缀、API 客户端实例。这些参数通常不会随着每次业务调用而变化,如果每次都显式传入,不但调用冗长,也容易让节点函数把“环境配置”和“业务输入”混在一起。
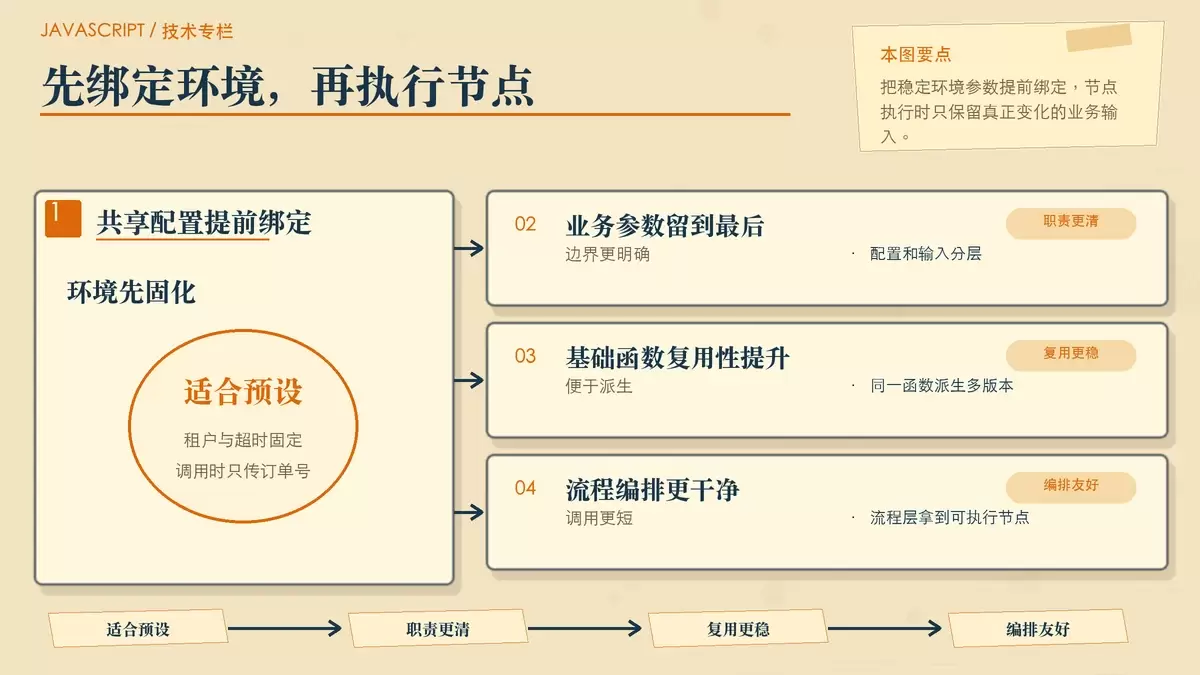
更合适的做法,是先把这类稳定配置固化成节点底座,执行阶段只再接收业务参数。原始函数可以写成这样:
const fetchOrder = (config, orderId) => fetch(`${config.base}/orders/${orderId}`, { timeout: config.timeout })再用柯里化提前固定配置:
const tenantOrderFetcher = curry(fetchOrder)({ base: 'https://api.tenant-a.com', timeout: 8000 })后续调用时,只需要提供真正变化的订单号:
tenantOrderFetcher('ORD-789')这样做有几个直接好处。第一,节点职责更清楚,fetchOrder 的环境依赖和业务输入被明确分层。第二,同一个基础函数可以快速派生出不同租户、不同超时策略的版本。第三,流程编排层拿到的已经是“可直接执行的节点”,不会被重复配置参数污染。
如果你的流程引擎里有大量“请求外部服务”“写审计日志”“查询资源状态”这类节点,这种预设方式通常比把所有参数塞进一个大对象再层层下传更容易维护。
把校验、转换、决策封装成单职责节点
审批流、订单流、风控流这类业务,最怕一个节点同时处理格式检查、权限判断、规则决策和状态更新。代码表面上像是“少了几个函数”,实际却会让复用性和测试性一起下降。柯里化适合做的,是把规则先绑定好,让节点只等待它真正要处理的数据。
例如一个审批步骤,可能包含格式检查、权限判断和风控校验:
const validateInput = curry(checkSchema)(inputSchema)const hasPermission = curry(allowAction)(currentUser, 'approve')编排时再按流程自由组合:
const approvalStep = compose(validateInput, hasPermission, runRiskCheck)这类写法的关键在于,inputSchema、currentUser、'approve' 这些规则侧参数已经提前固定,节点本身只关心当前输入对象或目标资源。于是一个流程步骤不再是不可拆解的大函数,而是一串职责清楚的处理单元。
测试也会更直接。比如你完全可以绕开整条流程,只验证某个节点的行为:
validateInput({ amount: 5000 })然后检查它返回的是 true 还是 false。这比启动完整流程、准备一堆前置状态后再测某个细节,要轻得多。
这里要注意一个判断标准:如果某个节点固定的是规则、身份、动作、配置,而运行时只接收一次明确输入,那它就很适合柯里化;如果节点天然需要同时感知多个不断变化的参数,强行拆层反而会让可读性下降。
支持运行时动态补全与条件跳过
真实业务流程很少像示例代码那样一次拿齐全部参数。模板 ID 可能来自用户选择,审批意见可能晚于节点构造,第三方回调数据也可能在后续步骤才返回。与此同时,灰度开关、租户策略、风险开关还会决定某些节点是否需要执行。
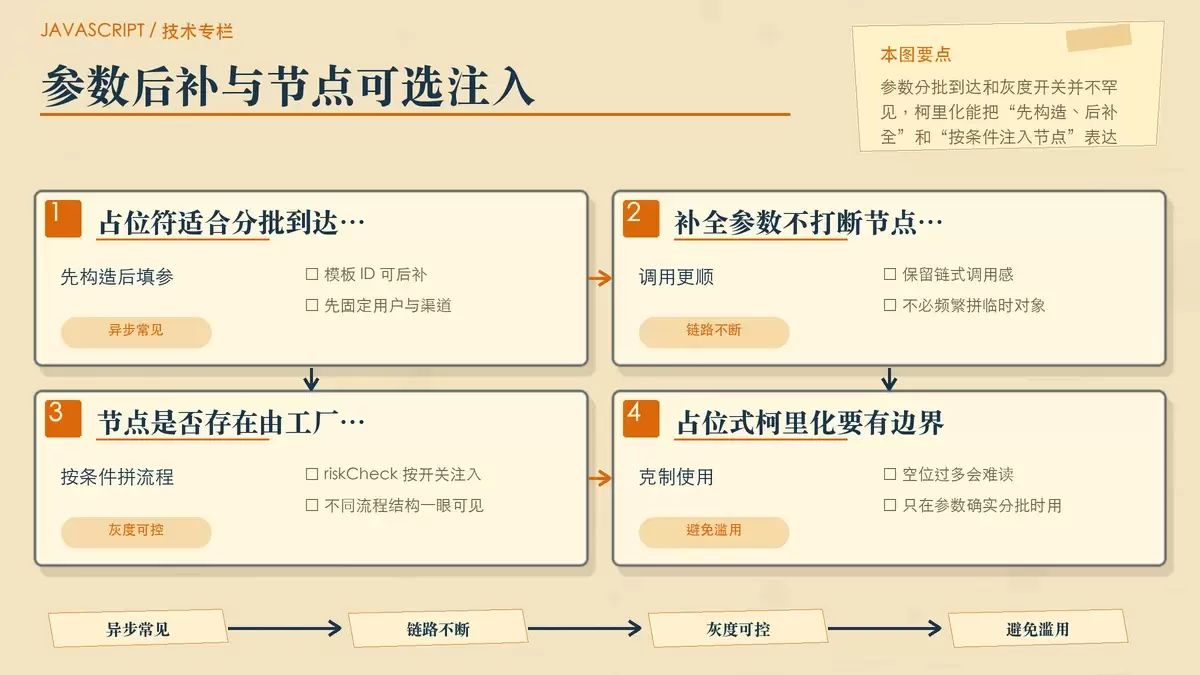
这时,柯里化配合占位符就能把“先构造节点、后补关键参数”的流程表达出来。例如:
const notifyUser = curry(sendNotification)(userId, _, 'email')这个节点先固定了用户和通知渠道,把模板 ID 留作后续补全:
notifyUser(templateId)其中 _ 作为占位,不会打断整个链式调用思路。对于需要等待异步结果的场景,这种方式往往比在流程中间不断拼装临时对象更顺手。
另一个常见需求是条件跳过。比如灰度阶段只对部分流量开启风控节点,可以直接在工厂函数里决定是否把该节点注入流程:
const flow = isRiskOn ? compose(step1, riskCheck, step2) : compose(step1, step2)这类写法的优势,不只是少写一个 if。更重要的是,流程结构本身就清楚体现了“风险开关打开时多一个节点”的差异。对于运营配置、租户分层、AB 实验这些场景,节点是否存在,通常比节点内部再去判断一次更直观。
不过也要克制使用占位符。只有当参数确实分批到达、并且这种分批对业务建模有意义时,占位式柯里化才值得上;否则过多的空位会让调用关系变得隐晦。
节点间传递结构化 context,而不是裸数据
流程引擎里另一个常见问题,是每个节点都在手动解构输入、拼回输出,最后链路里充满零散字段。相比之下,更稳妥的方式是统一传递一个结构化 context 对象,让每个节点只负责读取自己关心的数据,并返回增强后的上下文。
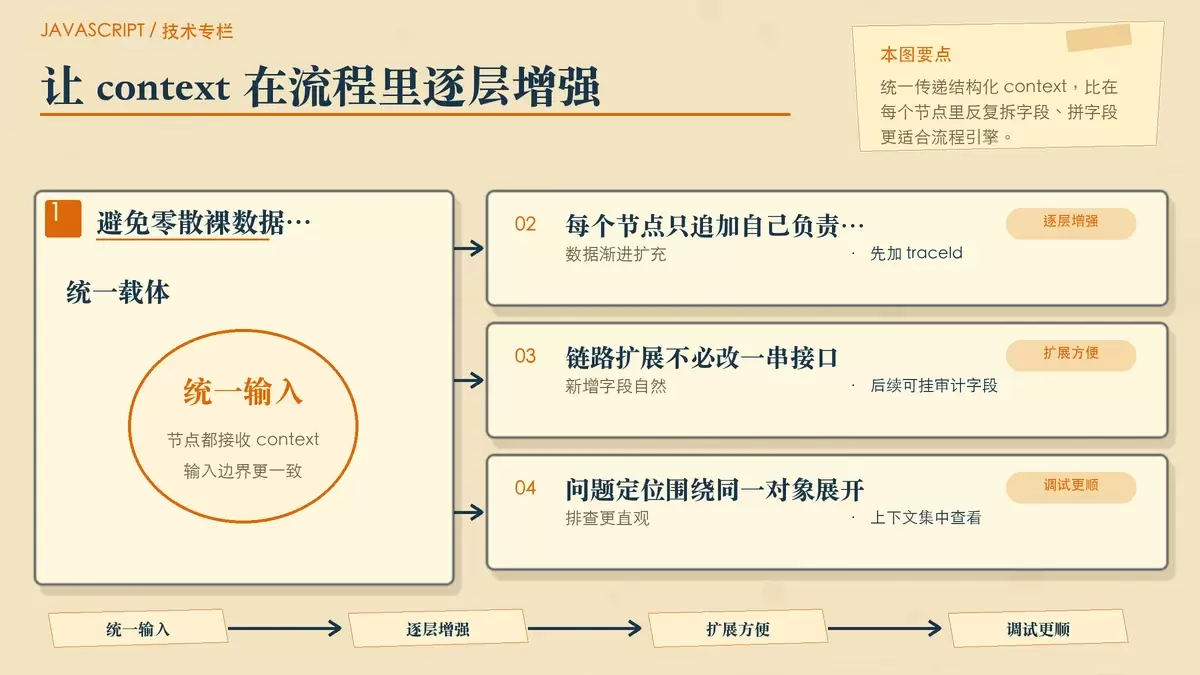
例如可以先定义一个为上下文补充追踪信息的节点:
const addTraceId = curry((traceId, ctx) => ({ ...ctx, traceId }))('TRACE-' + Date.now())再定义补充用户信息的节点:
const enrichWithUser = curry((user, ctx) => ({ ...ctx, user }))整个流程就会表现为 context 的逐层增强:
compose(addTraceId, enrichWithUser, validateInput)(initialData)这种组织方式有两个现实价值。第一,节点边界更统一,不需要每个环节都重新约定输入输出字段。第二,调试和扩展更方便,链路上的数据变化都汇集在同一个对象里,后面要加 trace、审计信息、租户标记时也更自然。
对流程引擎来说,柯里化最值得保留的,不是语法技巧,而是这种“先绑定稳定上下文,再流转结构化数据”的建模方式。只要节点能做到职责单一、组合清晰、输入边界稳定,柯里化就能真正帮你把复杂业务流程拆成可维护的执行单元。
什么时候适合用,什么时候不必硬套
把上面的几个场景合起来看,柯里化更适合这些节点:需要预设环境配置的节点、要把规则与输入分离的节点、参数会分阶段到达的节点,以及围绕统一 context 逐层增强的节点。它带来的收益主要是复用、替换、测试和编排清晰度。
但如果一个函数本身就很短,只会在单处调用,而且没有稳定上下文可提取,也没有明显的分层输入,那么直接写成普通函数往往更清楚。流程引擎里的目标从来不是“所有函数都柯里化”,而是让节点边界足够明确,组合关系足够稳定。
换句话说,判断依据可以很简单:当你发现某个节点总在重复接收同一批环境参数,或者总把规则和业务输入搅在一起时,就可以考虑用柯里化做一次结构整理;如果只是为了看起来更函数式,那大概率不会给业务代码带来真实收益。









