


在 Go 里写 switch,很多人会先带着 C、C++、Java 的经验来理解分支执行方式,结果一遇到 fallthrough 就容易产生误判。本文把 Go 的默认行为、fallthrough 的强制穿透规则、常见错误以及更稳妥的替代方案放到一起说明,读完你不仅能看懂它为什么会执行到下一个分支,也能判断它是否值得出现在自己的代码里。
Go 的 switch 为什么默认不穿透
在 C、C++、Java 等语言中,switch 的 case 默认会继续落到下一个分支,除非显式写出 break。这类写法虽然灵活,但也很容易因为漏写 break 带来隐藏 bug。
Go 的做法正好相反:一旦某个 case 匹配成功,执行完当前代码块后就会直接退出整个 switch,不会自动继续执行后面的 case。这个设计把“默认安全”放在了前面,减少了意外穿透的可能,也让分支行为更直观。
因此,理解 fallthrough 之前,先要记住一个前提:Go 的 switch 默认就是不穿透的。
`fallthrough` 是怎么工作的
如果你确实需要在命中当前分支后,继续执行下一个分支的代码,就可以使用 fallthrough。它的作用不是“继续匹配”,而是无条件进入紧邻的下一个 case。
也就是说,哪怕下一个 case 的条件根本不成立,只要写了 fallthrough,它的代码块也会执行。
基本语法
switch expression {
case value1:
    // 代码块1
    fallthrough
case value2:
    // 代码块2
    fallthrough
default:
    // 默认代码块
}
一个最容易看懂的例子
package main

import "fmt"

func main() {
    num := 2
    switch num {
    case 1:
        fmt.Println("数字是1")
    case 2:
        fmt.Println("数字是2")
        fallthrough
    case 3:
        fmt.Println("数字是3")
    case 4:
        fmt.Println("数字是4")
    default:
        fmt.Println("默认情况")
    }
}
输出结果:
数字是2
数字是3
这里 num 的值明明是 2,却仍然执行了 case 3。原因就在于 fallthrough 不会判断下一个分支是否匹配,它只负责把执行流程强制推进到下一个分支块。
使用 `fallthrough` 前必须知道的规则
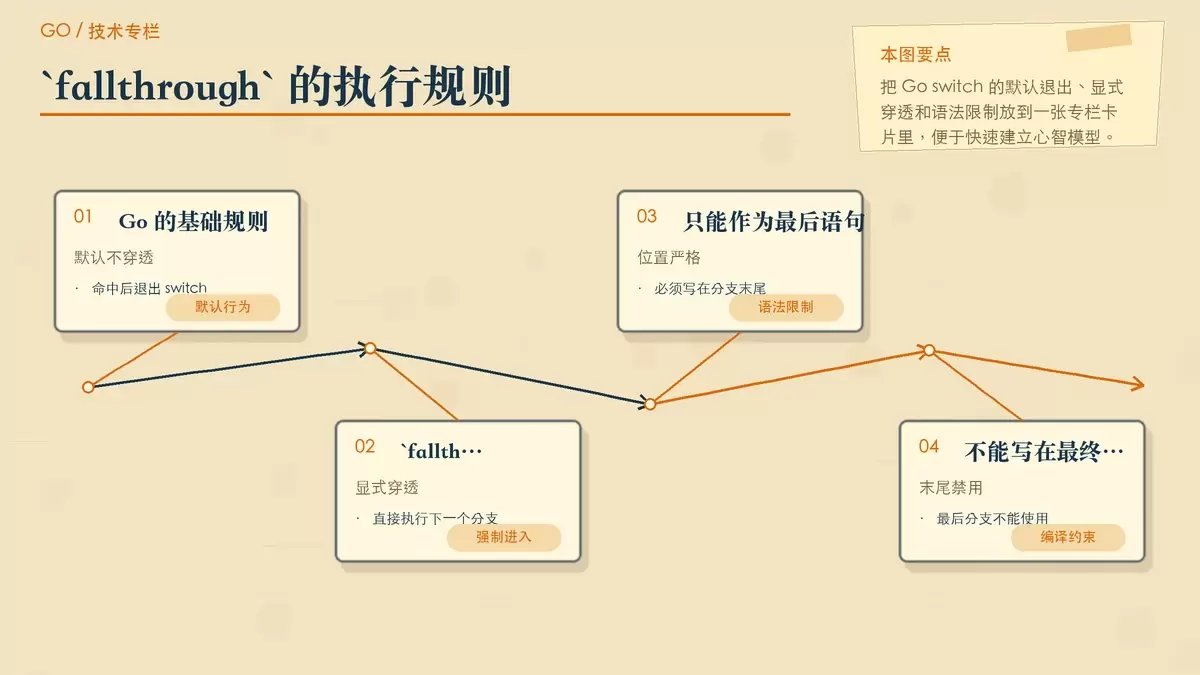
fallthrough 的行为很简单,但限制并不少,真正容易出错的地方反而集中在这些语法规则上。
1. 它是无条件穿透
写下 fallthrough 之后,下一个 case 的条件是否成立已经不重要了,程序会直接执行对应代码。这也是它最容易让人误读的地方。
2. 它必须是当前 case 的最后一条语句
fallthrough 后面不能再跟其他语句,否则会直接编译报错。
3. 不能写在最后一个 case 上
因为后面已经没有可穿透的分支,所以最后一个分支块里不能使用 fallthrough。
4. 可以用于 default,但前提是 default 不是最后一个分支块
这一点和不少人的直觉不同。default 不是绝对不能穿透,只要它后面还有分支块,就可以使用。
5. 它不会重新检查下一个 case 的条件
这一点和“继续匹配”完全不同。fallthrough 只是控制流跳转,不是再次判断表达式。
常见错误示例
// 错误示例1:fallthrough不是最后语句
switch num {
case 1:
    fallthrough
    fmt.Println("这行会编译错误")  // fallthrough statement out of place
case 2:
    // ...
}

// 错误示例2:在最后一个 case 中使用fallthrough
switch num {
case 1:
    fmt.Println("数字是1")
case 2:
    fmt.Println("数字是2")
    fallthrough    // cannot fallthrough final case in switch
}
如果你在阅读他人代码时看到这类报错,优先检查的就是这两点:它是不是出现在分支末尾,以及它后面是否真的还有下一个分支。
它和其他语言有什么不同,适合用在哪
Go 对 fallthrough 的处理方式,很能体现它“显式优于隐式”的设计思路。与 C、C++、Java 的默认穿透相比,Go 要求开发者明确表达“我就是要继续执行下一个分支”,这样虽然少了一点随手写法的自由,但换来的是更低的误用概率。
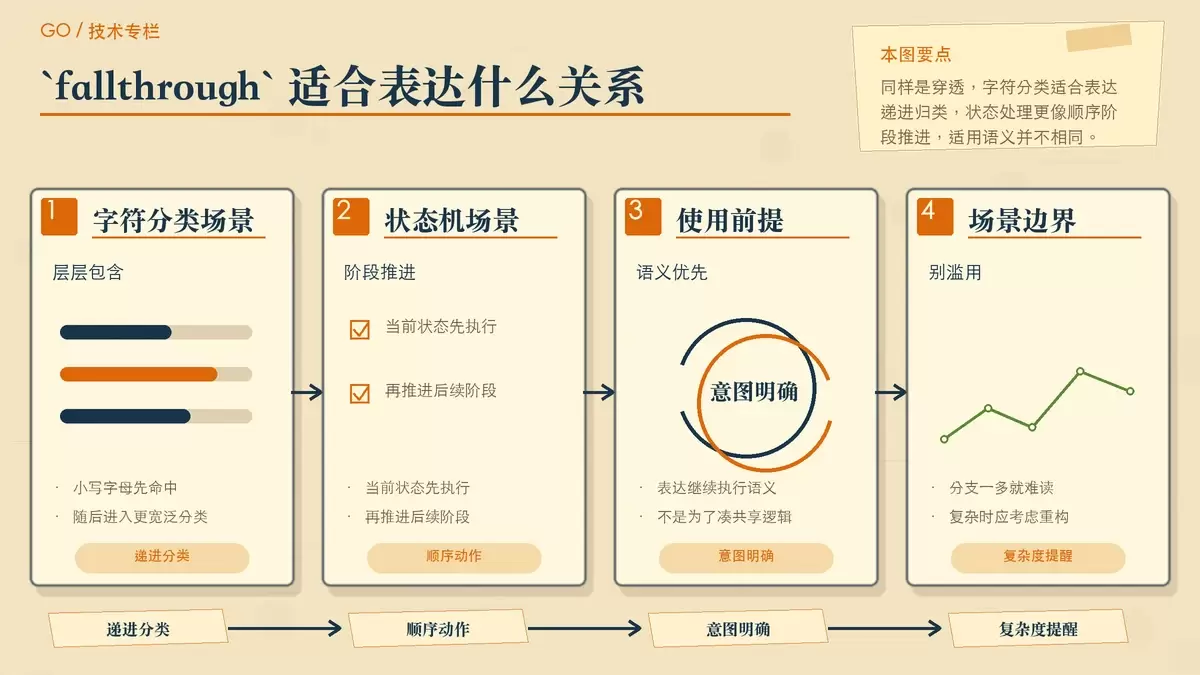
也正因为如此,fallthrough 在 Go 里不是日常高频工具,而是一个应该带着明确意图去使用的关键字。
多分支共享后续逻辑
当某个分支命中后,需要顺带执行下一层更宽泛的逻辑时,fallthrough 能减少重复代码。
func classifyChar(c rune) {
    switch {
    case c >= 'a' && c <= 'z':
        fmt.Println("小写字母")
        fallthrough
    case c >= 'A' && c <= 'Z':
        fmt.Println("字母")
        fallthrough
    case c >= '0' && c <= '9':
        fmt.Println("字母或数字")
    default:
        fmt.Println("其他字符")
    }
}
这个例子想表达的是一种“层层包含”的关系:小写字母属于字母,字母又属于更大的“字母或数字”分类。这里用 fallthrough 可以把这种递进关系直接写出来。
状态机或顺序阶段推进
当状态处理天然会进入下一个阶段时,fallthrough 也可能让代码更贴近流程本身。
switch currentState {
case initialState:
    fmt.Println("开始处理")
    fallthrough
case processingState:
    fmt.Println("处理中")
    fallthrough
case finalState:
    fmt.Println("处理完成")
}
这种写法适合表达“进入当前状态后,还要继续执行后续阶段动作”的场景。不过一旦状态逻辑变复杂,拆成独立函数或显式调用往往会更清楚。
更稳妥的写法与实践建议
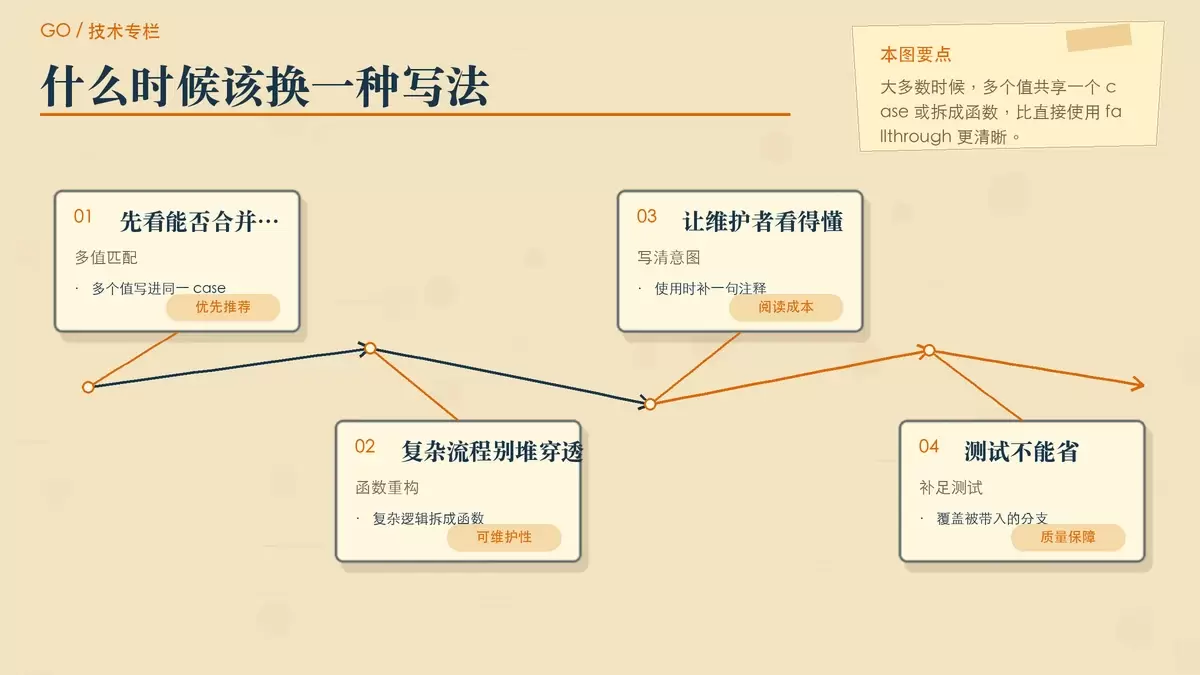
fallthrough 并不是不能用,而是应该少用、慎用。多数情况下,Go 已经提供了更直接、可读性更好的替代方式。
优先考虑多个值共用一个分支
如果你的目的只是让多个值执行同一段逻辑,通常没必要使用 fallthrough,直接把多个值写进同一个 case 更自然。
switch n {
case 0, 1:
    fmt.Println("Zero or One")
}
这种写法比“先匹配一个,再强制落到下一个”更容易理解,也更不容易让后来维护代码的人误判执行路径。
确实要用时,把意图写清楚
如果业务语义真的需要穿透,建议加上一句简短注释,说明为什么这里必须继续执行下一个分支。这样别人读代码时,不会把它当成误写。
逻辑复杂时,优先重构
一旦某个 switch 里出现多次 fallthrough,通常就说明分支职责已经开始缠在一起了。此时把重复动作抽成函数,或者改用更明确的控制结构,往往比继续堆叠穿透更可靠。
对相关分支做测试覆盖
由于 fallthrough 会让执行路径变得不那么直观,测试就更重要。尤其是涉及多个状态、分类判断或边界输入时,最好把每个会被带到的分支都覆盖到,避免“看起来只命中一个 case,实际却执行了多个分支”的问题。
什么时候该用,什么时候该避免
Go 中的 fallthrough 本质上是一个显式控制流工具:它让你可以在当前 case 结束后,强制执行下一个分支代码块。它的价值在于表达明确的顺序关系或递进关系,而不是代替普通的多值匹配。
如果只是为了复用同一段逻辑,优先使用多个值共享一个 case;如果确实存在“命中这里后必须继续执行下一步”的语义,再考虑使用 fallthrough。这样既能利用 Go 提供的能力,也能保持代码的可读性和可维护性。









