


在 Gin 服务里,panic 并不罕见:数组越界、空指针、并发场景误用上下文,都可能让请求处理中断。真正的问题不在于“会不会出错”,而在于出错时服务是否还能稳住、日志是否足够排查、客户端是否能拿到一致的响应。本文围绕 Recovery 中间件的职责边界、接入方式和生产环境常见误区展开,帮助你判断默认 Recovery 够不够用,什么时候该切到 CustomRecovery,以及哪些环节必须补上额外防线。
Recovery 到底解决了什么问题
Gin 内建的 Recovery 中间件,本质上是一个面向请求生命周期的异常兜底层。它利用 Go 语言里的 defer 和 recover 机制,在请求处理链上拦住 panic,避免异常直接把整个服务进程带崩。
如果一个 Gin 服务在处理请求时发生数组越界或空指针引用,而又没有恢复机制,结果通常不是单个接口返回失败这么简单,而是当前进程直接退出,所有用户请求一起受影响。线上环境里,这类故障的破坏性很高。
直接暴露 panic,通常会带来三个问题:
- 堆栈信息外泄:内部代码结构、调用路径可能被直接打印出来
- 服务整体崩溃:不是一个请求失败,而是整个进程失效
- 客户端体验很差:浏览器或调用方收到白页、乱码或非预期响应
Recovery 的价值,就是把“进程级事故”压缩成“请求级失败”。它捕获 panic、记录错误,并返回 500 响应,让其他请求继续执行。
这里有一个前提要记住:recover 只有在 defer 函数中调用时才有效。Gin 的 Recovery 中间件正是利用这个约束,在每次请求进入处理链时提前布置好兜底逻辑。
如何启用 Recovery,以及为什么顺序很重要
在 Gin 里启用 Recovery 很简单,但“启用了”和“用对了”不是一回事。
使用 gin.Default() 时
如果你直接使用 gin.Default() 创建路由引擎,Gin 会自动挂载 Logger 和 Recovery:
router := gin.Default()使用 gin.New() 时
如果你选择更干净的初始化方式 gin.New(),那就需要手动添加:
router := gin.New()
router.Use(gin.Recovery())
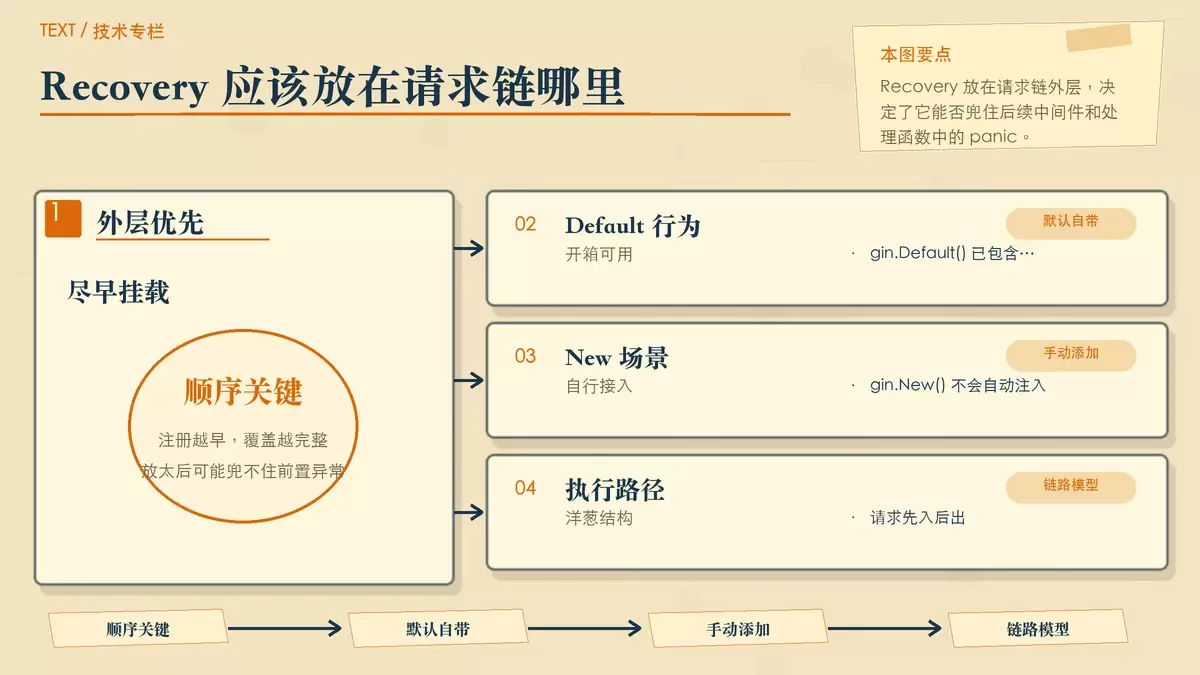
关键不只是“加上它”,还包括“尽早加上它”。Recovery 应该尽可能靠前注册,这样它才能覆盖后续中间件和业务处理函数中的 panic。
为什么中间件顺序会影响兜底范围
Gin 中间件遵循常说的“洋葱模型”。请求会先依次经过各层中间件的前置逻辑,进入业务处理函数后,再按相反方向返回,执行后置逻辑。谁在外层,谁就更有机会包住后面的执行链。
因此,Recovery 通常应该放在最外层,优先兜底。一个比较常见的注册顺序是:
- Recovery:优先保证 panic 不会把服务打挂
- Logger / Tracing:记录请求路径与执行过程
- CORS / Rate Limiter:处理跨域、限流等通用能力
- Auth:认证、授权等业务中间件
如果 Recovery 放得太靠后,它前面的某个中间件一旦 panic,就可能超出它的拦截范围。对线上系统来说,这不是理论问题,而是直接影响可用性的配置细节。
什么时候该用 CustomRecovery
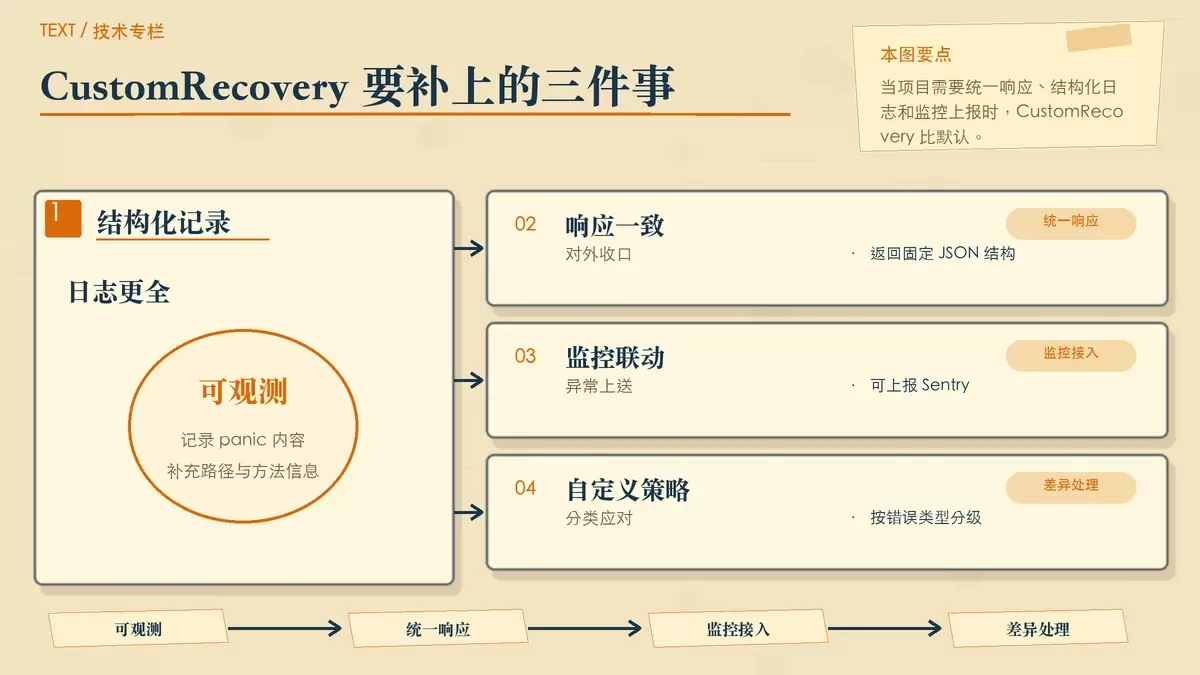
默认的 Recovery 已经能完成基础兜底,但很多项目最终都会走向 CustomRecovery。原因很简单:线上系统需要的不只是“别崩”,还要“能排查、能监控、能统一返回”。
通常在下面几类场景里,自定义 Recovery 更有价值:
- 需要把更完整的错误信息打到日志系统
- 需要把 panic 上报到 Sentry、Zipkin 等监控平台
- 需要对外返回统一格式的 JSON 错误响应
- 需要根据不同错误类型做差异化处理
一个基础的 CustomRecovery 示例
下面这段代码保留了 Recovery 的核心职责,同时补上了统一响应能力:
func CustomRecovery() gin.HandlerFunc {
    return func(c *gin.Context) {
        defer func() {
            if err := recover(); err != nil {
                // 记录错误堆栈
                log.Printf("Panic recovered: %vn", err)
                // 返回统一JSON错误响应
                c.JSON(500, gin.H{
                    "code": 500,
                    "message": "内部服务器错误,请稍后重试",
                })
                c.Abort()
            }
        }()
        c.Next()
    }
}
这类写法的意义在于,把 panic 从框架层异常转换成业务可消费的 HTTP 响应。客户端拿到的不是一段不可控的报错内容,而是稳定的结构化 JSON。
继续往前走,自定义逻辑还可以做得更细。比如把明确的业务性 panic 和未知 runtime 问题区分开,使用不同的日志等级,或者打上不同监控标签,方便后续归因。
生产环境里还要补哪些防线
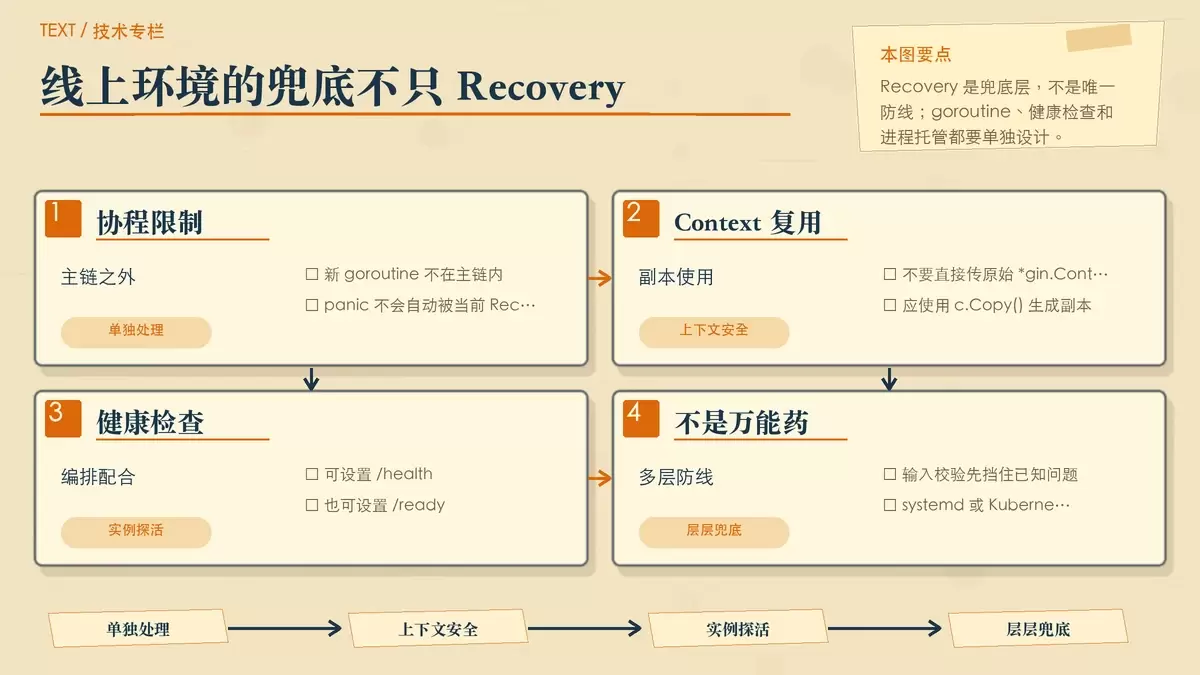
Recovery 很重要,但它只是最后一道缓冲层,不能替代完整的稳定性设计。真正上线时,至少还有几个点需要一起考虑。
结合结构化日志
panic 发生时,只记录一句“出错了”基本没有排查价值。更实用的方式是把错误内容和请求上下文一起写进日志,例如请求路径、HTTP 方法、发生时间等。
log.Printf("[panic] error=%v path=%s method=%sn", err, c.Path, c.Method)这样排查时才能知道问题发生在哪个接口、什么请求触发了它,而不是只看到一条孤立的异常信息。
注意 goroutine 里的 panic
这是很多人第一次用 Recovery 时最容易忽略的限制:它只能捕获主 goroutine 中的 panic。如果请求处理过程中你又启动了新的 goroutine,那么那个 goroutine 里的 panic,不会自动被当前请求链上的 Recovery 接住。
这意味着两件事:
- 每个新启动的 goroutine,都要自己做好 panic 处理
- 不要直接把原始
*gin.Context扔进 goroutine 里使用
更稳妥的做法,是使用 c.Copy() 生成安全副本再传入。原因在于 Gin 为了性能会通过 sync.Pool 复用 gin.Context,原始对象在请求结束后可能已经被回收或重用。
补上健康检查与优雅退出
如果服务运行在 Docker 或 Kubernetes 环境中,单靠 Recovery 还不够。你还需要配套健康检查端点,例如 /health 和 /ready,分别用于健康检查和就绪检查,帮助编排系统判断实例是否还能接流量。
这类机制和 Recovery 的关系是互补的:前者解决实例生命周期管理,后者解决请求级异常隔离。
接入错误监控系统
线上 panic 不能只停留在本地日志里。把异常上报到 Sentry、Zipkin 等监控工具后,才有可能做到自动归档、聚合、告警和趋势分析。尤其当某类 panic 高频出现时,监控平台往往比人工翻日志更快发现问题。
把 Recovery 放到多层防御里看
更稳妥的思路,是把 Recovery 放进一套分层防护体系,而不是把它当成万能补丁:
- 输入验证:业务逻辑执行前先校验参数
- Error 处理:可预期错误优先走 Go 的
error机制 - Recovery 中间件:兜住未预料到的 panic
- 进程管理:通过 systemd 或 Kubernetes 在崩溃后自动拉起
这一层层叠上去,服务的稳健性才是真正意义上的“可上线”。
一个支付接口案例,以及 Recovery 的边界
默认 Recovery 和统一错误返回之间,最典型的落地场景就是支付、订单这类对用户提示比较敏感的接口。因为这类接口即使失败,也不应该把内部异常细节直接暴露给客户端。
下面这个示例使用 gin.CustomRecovery,针对支付相关错误做了特殊响应:
router.Use(gin.CustomRecovery(func(c *gin.Context, recovered interface{}) {
    if err, ok := recovered.(string); ok {
        log.Printf("Panic recovered: %s", err)

        // 支付相关错误特殊处理
        if strings.Contains(err, "payment") {
            c.JSON(500, gin.H{
                "code": "PAYMENT_ERROR",
                "message": "支付处理异常,请联系客服",
            })
            return
        }
    }

    // 默认错误响应
    c.JSON(500, gin.H{
        "code": "INTERNAL_ERROR",
        "message": "服务暂时不可用,请稍后重试",
    })
}))
这里的重点不是“把所有 panic 都翻译成业务错误”,而是把外部可见的响应做统一收口。对于支付相关异常,客户端拿到的是更明确但仍然克制的提示;对于其他未知错误,则统一返回通用错误码和消息,避免暴露内部实现。
进一步一点,在开发环境和生产环境里,响应策略也可以不同。开发环境可以适当暴露更详细的错误信息以便调试;生产环境则更适合返回统一、模糊且可追踪的提示,把细节留给日志和监控系统。
Recovery 的局限性不能忽略
即使配置得当,Recovery 也仍然有边界:
- 捕获范围有限:其他 goroutine 中的 panic 需要单独处理
- 存在一定开销:虽然通常很小,但不是零成本
- 资源清理未必自动完成:某些数据库连接或外部资源仍可能需要手动清理
- 不能替代正常错误处理:可预期问题仍应优先走
error分支
这也是为什么很多成熟 API 服务都会把 Recovery 和统一错误处理机制一起设计。RESTful API 往往需要稳定的 JSON 响应结构,至少包含状态码、消息和数据字段;同时,再通过自定义错误类型区分数据库失败、参数校验失败、权限不足等不同场景。
说到底,Recovery 的职责是“兜底”,不是“包办”。它负责把最坏情况控制住,但前面的输入校验、业务错误处理、日志规范、监控告警,依然要靠整套工程实践来完成。
结语:把 Recovery 当成兜底层,而不是唯一解
Gin 的 Recovery 中间件,是构建稳健 Web 服务时非常实用的一层保护。它能把 panic 从进程级崩溃降级为请求级失败,这一点对线上可用性非常关键。
但真正可靠的服务,不会只停留在“加了 Recovery 就算完事”。更合理的做法是:先用 error 处理可预见问题,再用 Recovery 接住不可预见的 panic,同时配上结构化日志、监控上报、健康检查和进程托管。这样当问题真的发生时,服务不至于直接倒下,排查路径也足够清晰。









