


在 Gin 项目里,几乎所有处理函数都会接收一个 *gin.Context,但很多人最初只是把它当成“方便取参数、回 JSON 的工具”。真正理解这个对象后,你会发现它连接了请求数据、响应输出、中间件流转和性能优化,是 Gin 能同时兼顾易用性与吞吐表现的关键设计。本文会从原生 net/http 的对比出发,拆开看它为什么存在、承担了哪些职责,以及在并发和中间件场景下该怎么用才稳妥。
为什么 Gin 需要 Context
先看最常见的 Gin 代码:
func main() {
    r := gin.Default()
    r.GET("/hello", func(c *gin.Context) {
        c.JSON(200, gin.H{"message": "hello"})
    })
    r.Run(":8080")
}
这里的 *gin.Context 不是普通参数,它代表了一次 HTTP 请求处理过程中所需的大部分上下文信息。请求进入框架后,开发者读取参数、绑定数据、写入状态、返回响应,基本都围绕它展开。
如果不用 Gin 的封装,只依赖原生 net/http,同样的响应逻辑往往要自己处理响应头、状态码和编码过程:
// 原生HTTP处理
func handler(w http.ResponseWriter, req *http.Request) {
    obj := map[string]any{
        "name": "abc",
        "age": 20,
    }

    w.Header().Set("Content-Type", "application/json")
    w.WriteHeader(http.StatusOK)
    encoder := json.NewEncoder(w)
    if err := encoder.Encode(obj); err != nil {
        http.Error(w, err.Error(), 500)
    }
}
换成 Gin 之后,代码会明显收束成业务表达:
// 使用Gin Context处理
func handler(c *gin.Context) {
    c.JSON(http.StatusOK, gin.H{
        "name": "abc",
        "age": 20,
    })
}
这正是 Context 存在的第一层意义:把重复而分散的 HTTP 处理细节收进统一入口,让处理函数更接近“我想完成什么”,而不是“我要手动拼哪些底层步骤”。
从设计上看,它并不只是请求参数容器,而是一个面向单次请求的操作面板:一边连接 http.Request 与响应写入器,一边把参数读取、绑定校验、流程控制、渲染输出等能力放到同一个对象上,减少开发过程中的上下文切换。
Context 的设计核心:封装、生命周期与一体化
封装原生 HTTP 细节
Gin 对 http.Request 和 http.ResponseWriter 做了再包装。原生接口足够灵活,但粒度偏底层,很多常见操作都要自己组合;Gin 则把高频动作整理成更稳定的 API,让业务层少写样板代码。
这类封装的直接收益有两个:一是处理函数更短,二是项目里的请求处理风格更统一。无论是读参数、校验输入,还是输出 JSON、HTML、文件,团队都更容易形成一致写法。
与请求绑定的生命周期
Gin 的 Context 是典型的“单请求对象”。每到一个新请求,框架都会准备一个对应的实例;当请求处理完成,这个实例会被重置并回收,而不是长期保留。
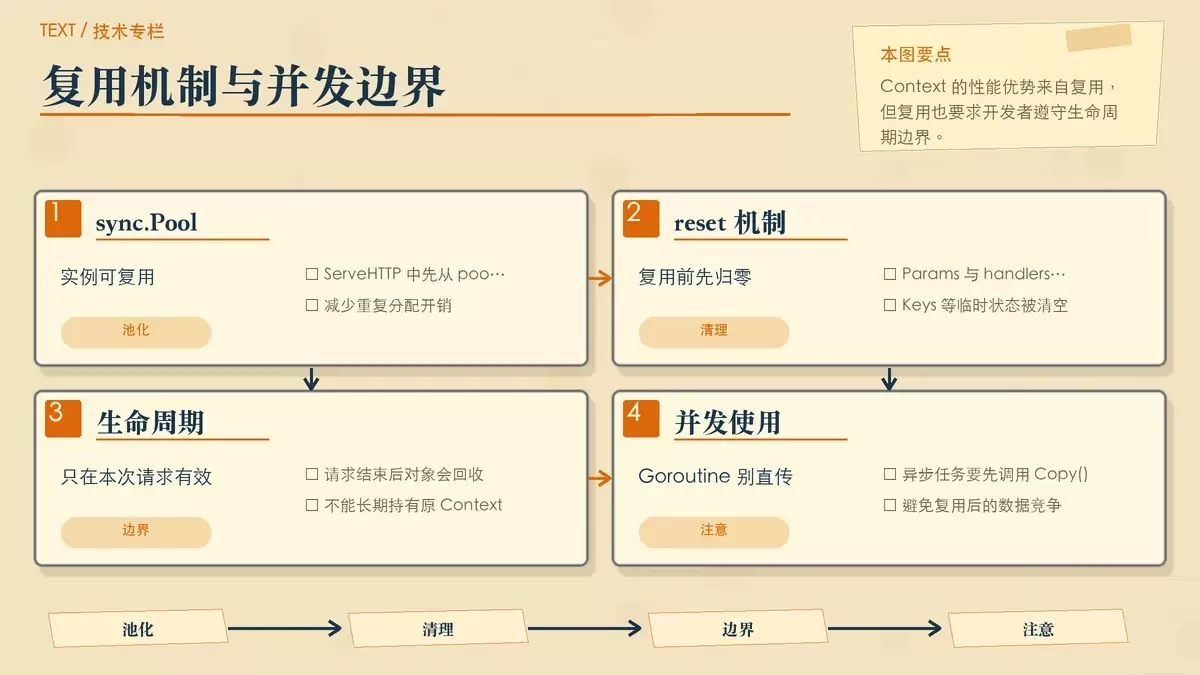
这种设计有两个关键价值。首先,数据隔离更自然,请求之间不会共享临时状态;其次,框架可以围绕这个生命周期做性能优化。Gin 通过 sync.Pool 复用 Context,避免高并发下频繁创建和销毁对象带来的分配开销。
也正因为它会被回收复用,所以开发者不能把当前请求的 Context 当作长期可持有对象随意传递,这也是后面并发使用要格外注意的原因。
把请求处理常用能力放在一个入口
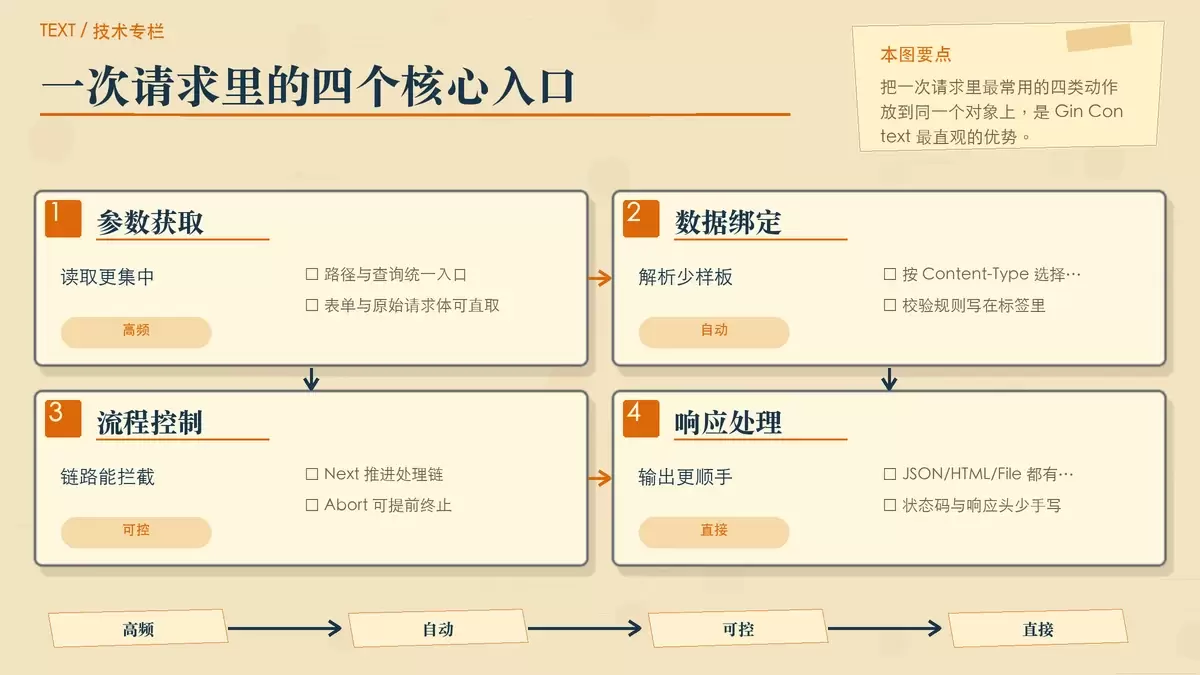
Context 的另一个特点是“一体化”。它不是只负责输入,也不是只负责输出,而是把一次请求中最常见的几类动作集中起来:
- 输入处理:路径参数、查询参数、表单、请求体读取与绑定
- 流程控制:中间件链推进、提前终止、共享数据
- 输出处理:JSON、HTML、文件、重定向、错误响应
这让它天然成为 Gin 中最重要的“单次请求协调器”。对于业务开发者来说,看到 c *gin.Context,就等于拿到了这次请求的大部分操作入口。
Context 到底强在哪:四类高频能力
统一的参数获取方式
在 Web 服务里,参数可能来自 URL 路径、查询串、表单,甚至原始请求体。Gin 把这些入口统一到 Context 上,减少了你在不同数据来源之间来回切换的成本:
func handler(c *gin.Context) {
    // 获取路径参数
    id := c.Param("id")

    // 获取查询参数
    name := c.Query("name")
    page := c.DefaultQuery("page", "1")

    // 获取表单参数
    username := c.PostForm("username")

    // 获取原始请求体
    data, _ := c.GetRawData()
}
这种统一接口的价值不只是“好记”,更在于它把常见输入方式规范化了。处理函数拿到 Context 后,不需要再关心每种数据来源的底层读取方式,直接按场景调用对应方法即可。
自动绑定与校验能力
如果请求参数需要落到结构体上,Context 的绑定能力会更有优势。它可以根据请求的 Content-Type 自动选择绑定器,把 JSON、XML、表单等格式解析到统一结构里,同时结合标签完成基本校验:
type User struct {
    Name  string `json:"name" form:"name" binding:"required"`
    Email string `json:"email" form:"email" binding:"required,email"`
    Age   int    `json:"age" form:"age" binding:"min=18"`
}

func createUser(c *gin.Context) {
    var user User
    if err := c.Bind(&user); err != nil {
        c.JSON(http.StatusBadRequest, gin.H{"error": err.Error()})
        return
    }
    // 处理用户数据...
}
这一步把“读取请求体、解析字段、检查必填项、返回错误”几段经常重复的代码收敛成了统一流程。对接口开发来说,这种设计很实用,因为输入规范和错误处理可以更早收口,不必把校验逻辑散落在业务代码里。
中间件链的流程控制
Gin 的中间件机制之所以顺手,很大程度上也依赖 Context。通过 Next() 和 Abort(),它让一个请求可以在多个处理节点之间有序流转,并在需要时被及时拦截:
func AuthMiddleware() gin.HandlerFunc {
    return func(c *gin.Context) {
        token := c.GetHeader("Authorization")
        if token == "" {
            c.AbortWithStatusJSON(401, gin.H{"error": "未授权"})
            return
        }
        // 验证token...
        c.Set("userID", userID)
        c.Next() // 调用下一个中间件/处理器
    }
}这里面有两层能力值得注意。第一,Context 提供了流程推进和中断的控制点,中间件可以决定是否继续走后续处理器;第二,它还能作为数据传递载体,把鉴权结果、链路标识、日志字段等信息带到下游处理逻辑中。
这也是为什么很多认证、限流、审计、链路追踪逻辑都适合写成 Gin 中间件。它们关注的是“跨多个接口的共同逻辑”,而不是某个具体业务接口本身。
响应输出的统一封装
输出侧同样是 Context 的强项。Gin 为常见响应形式都准备了现成方法,开发者不必再频繁手动设置状态码、响应头和序列化行为:
func handler(c *gin.Context) {
    // JSON响应
    c.JSON(200, gin.H{"message": "success"})

    // HTML响应
    c.HTML(200, "template.html", gin.H{"title": "Gin"})

    // 文件下载
    c.File("./files/report.pdf")

    // 重定向
    c.Redirect(302, "https://example.com")
}
这种统一封装的好处是,响应逻辑和业务逻辑可以保持在同一层表达。代码阅读时,你几乎一眼就能判断一个处理函数最终要返回什么,不必顺着底层写入器去推断实际响应行为。
高性能设计与使用时的关键注意点
sync.Pool 带来的复用机制
Gin 的性能表现,很大一部分来自 Context 不被频繁新建。框架内部会通过对象池拿出可用实例,处理请求后再放回池中:
func (engine *Engine) ServeHTTP(w http.ResponseWriter, req *http.Request) {
    // 从对象池获取Context
    c := engine.pool.Get().(*Context)
    c.writermem.reset(w)
    c.Request = req
    c.reset()

    // 处理请求
    engine.handleHTTPRequest(c)

    // 放回对象池
    engine.pool.Put(c)
}
这意味着在高并发场景里,Gin 不需要为每次请求都完整分配一套全新对象,从而减少 GC 压力和分配成本。对框架来说,这是非常直接的吞吐优化;对使用者来说,则要清楚它不是“每次都崭新的长期对象”,而是“每次请求期间有效的可复用对象”。
重置状态,避免脏数据串到下个请求
对象复用的前提,是每次使用前后都要把状态清干净。Gin 内部会在请求处理阶段重置关键字段,确保前一个请求留下的数据不会影响后一个请求:
func (c *Context) reset() {
    c.Params = c.Params[0:0]  // 清空路由参数
    c.handlers = nil         // 清空处理链
    c.index = -8             // 重置处理索引
    c.Keys = nil             // 清空自定义数据
    // ...其他清理操作
}
这里能看出一个重要设计思路:高性能不是只靠“复用”,还要靠“可安全复用”。只有把状态边界处理清楚,请求级对象池才不会引入隐蔽 bug。
在 Goroutine 中不要直接持有原始 Context
因为 Context 会在请求结束后被回收复用,所以在异步任务或新的 Goroutine 里直接使用原对象是有风险的。Gin 给出的正确方式是先调用 Copy() 拿到副本:
func handler(c *gin.Context) {
    // 创建上下文副本,用于Goroutine
    ctxCopy := c.Copy()

    go func() {
        // 使用副本,避免数据竞争
        time.Sleep(1 * time.Second)
        log.Printf("Request %s processed", ctxCopy.Request.URL.Path)
    }()

    c.JSON(200, gin.H{"message": "任务已提交"})
}
这是实际项目里很容易踩坑的一点。很多人以为把 c 直接丢进异步逻辑没有问题,但请求一结束,底层对象可能已经被重置并重新投入下一次请求。使用 Copy() 的本质,就是把异步逻辑与原请求生命周期拆开,避免数据竞争和脏读。
中间件之间的数据传递要有边界意识
Context 提供了 Set() 和 Get() 来做中间件之间的共享数据传递,这在链路 ID、用户信息、权限结果等场景里很常见:
func SetRequestID() gin.HandlerFunc {
    return func(c *gin.Context) {
        reqID := uuid.New().String()
        c.Set("requestID", reqID)
        c.Next()
    }
}

func handler(c *gin.Context) {
    reqID := c.MustGet("requestID").(string)
    // 使用requestID...
}
如果只是简单演示,直接用 MustGet() 没问题;但在真实项目里,仍然要注意键名约定和数据类型管理,避免多人协作时出现覆盖、误取或断言失败。Gin 也提供了 GetString()、GetInt() 等更方便的方法,可以减少样板式类型断言。
为什么它会成为 Gin 的核心体验
回头看,Gin 的 Context 之所以显得“强大”,不是因为它单独提供了某个炫目的 API,而是因为它把 Web 请求处理中最常用、最容易重复、也最需要统一的几个环节放进了同一个请求级对象里。
它向上提供简洁接口,让开发者用更少代码完成参数读取、数据绑定、流程控制和响应输出;向下又通过生命周期管理、对象池复用和状态重置保证性能与隔离性。对业务开发来说,这意味着更高的编码效率;对框架设计来说,这意味着一个既顺手又能扛并发的核心抽象。
如果把 Gin 的使用体验拆开来看,路由注册、中间件组织、响应输出看似是不同功能,但真正把它们串起来的,正是这个 *gin.Context。理解它的职责边界和复用机制,也就更容易理解 Gin 为什么能在 Go Web 框架里长期保持高普及度。









