

Python I/O操作、进程管理与多线程详解

本文深入解析Python中的I/O操作、多进程与多线程机制。涵盖with语句的上下文管理协议、文件读写模式、StringIO与BytesIO的使用,以及OS模块与序列化技术。重点讲解fork()创建进程、进程池应用、Queue通信,以及threading模块中的线程创建、锁机制、GIL限制与ThreadLocal全局变量,助力掌握Python并发编程。
Python I/O操作基础
I/O
with语句与上下文管理
使用with语句可以简化资源管理,其核心在于遵循上下文管理协议。该协议要求对象包含与两个方法。当执行as语句时,target(s)接收的是表达式调用后的返回值。随后执行代码块,并在代码块执行完毕(无论是否发生异常)后,自动调用上下文管理器的方法。这种机制有效减轻了诸如文件读写等场景中资源释放的代码负担。
with context_expression [as target(s)]:
with-bodycontext_expression返回值遵从上下文管理协议,包含__enter__()与__exit__()方法,as语句的target(s)得到的是__enter__()返回值,执行with-body后会调用上下文管理器的__exit__()方法,使用with语句,可以减轻某些代码编写负担,比如文件读写。
文件读取与模式
读文件
try:
  f = open('/path/to/file', 'r', encoding='utf8', errors='ignore')
  print(f.read(1024))
finally:
  if f:
    f.close()
# 使用with语句
with open('/path/to/file', 'r') as f:
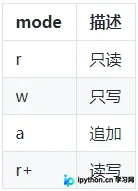
print(f.read(1024))Python中通过open()函数打开文件,默认以utf8格式读取。若需以二进制方式读取或写入,可在模式字符串后添加后缀'b'(如rb、wb)。mode参数支持多种配置,具体包括以下几种:
内存文件对象
StringIO和BytesIO
StringIO类用于在内存中以文件方式读取和写入字符串(string),而BytesIO类则用于处理字节(bytes)数据的读写操作,两者均模拟了文件对象的行为。
操作系统交互与序列化
OS
通过导入OS模块,Python程序能够与操作系统进行交互,执行创建、移动、列出文件及目录等操作,从而实现对文件系统的基本管理。
序列化
利用内置的pickle模块可以实现Python对象的序列化与反序列化操作。对于JSON格式的数据,则使用json模块来完成相应的序列化和反序列化任务,确保数据在不同系统或语言间的可交换性。
import pickle
d = dict(name = 'sha', age = 26)
# 将序列化内容写入文件
with open('dump', 'wb') as f:
  pickle.dump(d, f)
# 从文件中读取序列化内容
with open('dump', 'rb') as f:
  d = pickle.load(f)
print(d) # {'name': 'sha', 'age': 26}
Python进程管理
进程与线程
进程创建与特性
进程
在Python中调用一次fork()函数会产生两次返回结果:子进程始终返回0,而父进程中则返回子进程的ID。需要注意的是,os.fork()函数不支持Windows系统,因此跨平台的多进程开发推荐使用multiprocessing模块。
import os
pid = os.fork() # pid后的代码会在两个进程中分别执行,通过pid值不同判断父子
if pid == 0:
  print('exec in child process')
else:
  print('exec in parent process')
# exec in parent process
# exec in child process
进程池与子进程
进程池
from multiprocessing import Pool
def say(x):
  print(x)
if __name__ == '__main__':
  p = Pool(4)
  for i in range(5):
    p.apply_async(say, args=(i,))
  p.close()
  p.join()
子进程
import subprocess
print('$ nslookup amsimple.com')
r = subprocess.call(['nslookup', 'amsimple.com'])
print('Exit code:', r)
进程间通信机制
进程间通信
进程间通信主要通过Queue(队列)与Pipes(管道)来实现。通常由父进程创建Queue对象,并将其传递给子进程,以便子进程间进行数据交换。
Python多线程编程
线程
线程模块与启动
Python提供了两个线程模块:_thread和threading。其中_thread是低级模块,而threading是对其进行了封装的高级模块,提供了更丰富的功能。
启动一个线程需要将目标函数传入并创建Thread实例,随后调用start()方法开始执行:
import threading
# 新线程执行的代码:
def say():
  print('%s say hello' % threading.current_thread().name)
t = threading.Thread(target=say, name = 'SayThread')
t.start()
t.join()
线程状态与锁机制
通过threading.current_thread()可以返回当前运行线程的实例。主线程的名称通常为MainThread,而子线程的名称可以在创建Thread实例时指定。
通过threading.Lock()获取锁,某些需要线程安全的操作,先通过acquire()获取锁,通过release()释放锁。
GIL限制与ThreadLocal
由于Python解释器中存在GIL(全局解释器锁)的限制,Python中的线程无法真正利用多核CPU的优势进行并行计算。
通过ThreadLocal可以实现线程级的全局变量存储,确保不同线程间访问该变量时互不影响,各自拥有独立的副本。
import threading
th_local = threading.local() # th_local会跟线程绑定,不同线程看到的是不同对象
分布式进程与正则表达式
分布式进程
managers模块依靠网络通信,可以把多进程分布到多台机器上。
正则
通过'r'前缀定义正则字符串,通过re模块做正则匹配等操作。
import re
s = r'^[a-zA-Z0-9_-]+@[a-zA-Z0-9_-]+(\.[a-zA-Z0-9_-]+)+$'
re.match(s, 'shasharoman@gmail.com')
总结
以上就是这篇文章的全部内容了,希望本文的内容对大家的学习或者工作具有一定的参考学习价值,谢谢大家对本站的支持。如果你想了解更多相关内容请查看下面相关链接
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









