

Python实现狄克斯特拉算法:图解与代码解析

本文详细介绍如何使用Python实现狄克斯特拉算法求解有向图最短路径。通过图解展示算法从起点向外层层扩展的过程,逐步更新节点开销与父节点信息,最终计算出最小消耗路径。文章提供完整的Python代码实现,包括图的构建、开销表管理及路径回溯逻辑,适合希望深入理解该算法原理及实际应用的开发者参考。
一、简介
狄克斯特拉算法用于计算从一个指定顶点到图中其余所有顶点的最短路径,主要解决有向图中的最短路径问题。该算法的核心思想是以起始点为中心,采用贪心策略层层向外扩展,直至覆盖到目标终点。
二、步骤
(1) 找出当前未处理节点中“最便宜”的节点,即从起点到达该节点的累计开销最小。 (2) 计算并更新该节点所有邻居节点的开销,具体含义将在后续步骤中详细说明。 (3) 重复执行步骤(1)和(2),直到图中的所有节点都被处理完毕。 (4) 根据记录的路径信息,计算并输出最终的最短路径。
三、图解
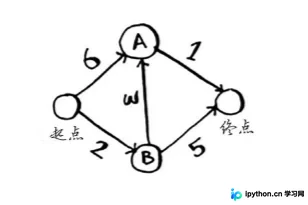
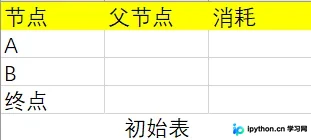
上图包含5个节点,箭头指示方向,线上的数字代表通过该边所需的消耗时间。 首先,根据上图构建一个初始状态表(父节点字段表示从哪个节点直接到达当前节点):
接着,从“起点”开始,依据图中的连接信息更新状态表。由于从“起点”无法直接到达“终点”节点,因此其初始耗时标记为∞(无穷大):
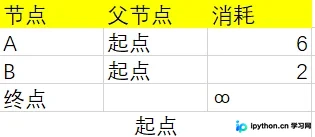
基于上述状态表,我们可以按照算法的具体步骤逐步推进。
第一步:找出当前“最便宜”的节点,即累计开销最小的节点。在本例中,该节点为B:
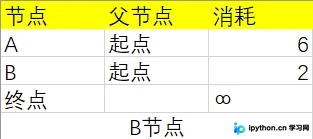
第二步:更新节点B所有邻居节点的开销。根据图示,从B出发可以到达A和“终点”节点。B当前的累计消耗为2,加上B到A的消耗3,总计5。因为5小于A原本记录的消耗6,所以更新节点A所在的行信息:
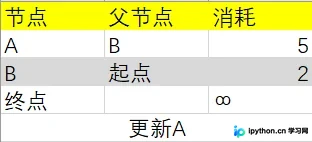
同理,B当前的累计消耗2加上B到“终点”的消耗5,总计7。因为7小于“终点”原本记录的∞,所以更新“终点”节点所在的行信息:
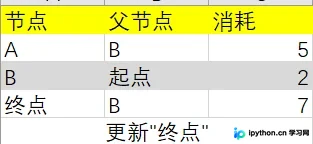
由于B节点关联的所有邻居节点开销均已更新完毕,因此在后续的步骤中,B节点不再参与更新计算:
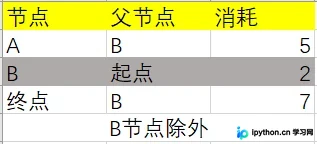
接下来,寻找下一个消耗最小的未处理节点,即节点A:
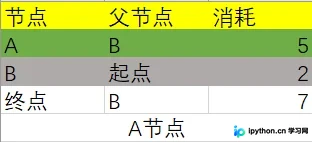
根据节点A的当前状态更新其关联节点的开销,此时仅“终点”节点所在的行被更新:
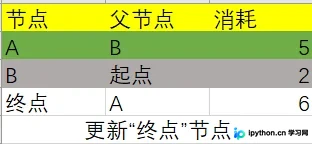
此时,节点A也已处理完毕,不再参与后续的节点更新:
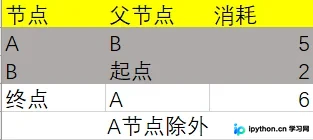
最终的状态表数据如下:
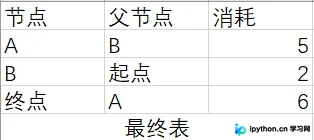
根据最终状态表,从“起点”到“终点”的最小总消耗为6,对应的路径为:起点 -> B -> A -> 终点。
四、代码实现
# -*-coding:utf-8-*-
# 用散列表实现图的关系
# 创建节点的开销表,开销是指从"起点"到该节点的权重
graph = {}
graph["start"] = {}
graph["start"]["a"] = 6
graph["start"]["b"] = 2

graph["a"] = {}
graph["a"]["end"] = 1

graph["b"] = {}
graph["b"]["a"] = 3
graph["b"]["end"] = 5
graph["end"] = {}

# 无穷大
infinity = float("inf")
costs = {}
costs["a"] = 6
costs["b"] = 2
costs["end"] = infinity

# 父节点散列表
parents = {}
parents["a"] = "start"
parents["b"] = "start"
parents["end"] = None

# 已经处理过的节点,需要记录
processed = []


# 找到开销最小的节点
def find_lowest_cost_node(costs):
 # 初始化数据
 lowest_cost = infinity
 lowest_cost_node = None
 # 遍历所有节点
 for node in costs:
 # 该节点没有被处理
 if not node in processed:
  # 如果当前节点的开销比已经存在的开销小,则更新该节点为开销最小的节点
  if costs[node] < lowest_cost:
  lowest_cost = costs[node]
  lowest_cost_node = node
 return lowest_cost_node


# 找到最短路径
def find_shortest_path():
 node = "end"
 shortest_path = ["end"]
 while parents[node] != "start":
 shortest_path.append(parents[node])
 node = parents[node]
 shortest_path.append("start")
 return shortest_path


# 寻找加权的最短路径
def dijkstra():
 # 查询到目前开销最小的节点
 node = find_lowest_cost_node(costs)
 # 只要有开销最小的节点就循环(这个while循环在所有节点都被处理过后结束)
 while node is not None:
 # 获取该节点当前开销
 cost = costs[node]
 # 获取该节点相邻的节点
 neighbors = graph[node]
 # 遍历当前节点的所有邻居
 for n in neighbors.keys():
  # 计算经过当前节点到达相邻结点的开销,即当前节点的开销加上当前节点到相邻节点的开销
  new_cost = cost + neighbors[n]
  # 如果经当前节点前往该邻居更近,就更新该邻居的开销
  if new_cost < costs[n]:
  costs[n] = new_cost
  #同时将该邻居的父节点设置为当前节点
  parents[n] = node
 # 将当前节点标记为处理过
 processed.append(node)
 # 找出接下来要处理的节点,并循环
 node = find_lowest_cost_node(costs)
 # 循环完毕说明所有节点都已经处理完毕
 shortest_path = find_shortest_path()
 shortest_path.reverse()
 print(shortest_path)
# 测试
dijkstra()
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









