


Go 并发代码常见的难点,不是会不会写 select,而是同一个 goroutine 在不同阶段要监听不同事件:还没准备好时不能收任务,队列空了不能发数据,某个输入关闭后还要把它彻底移出循环。很多人会为不同状态拆出多套 select,结果判断越来越多,代码也越来越散。
其实 Go 自带一个很轻量的办法:把某个 channel 变量暂时设为 nil,对应的 case 就会在后续 select 中失效;恢复成真实 channel,分支又能重新参与竞争。下面就按几类最常见场景拆开说明,顺手把几个最容易踩的边界也讲清楚。
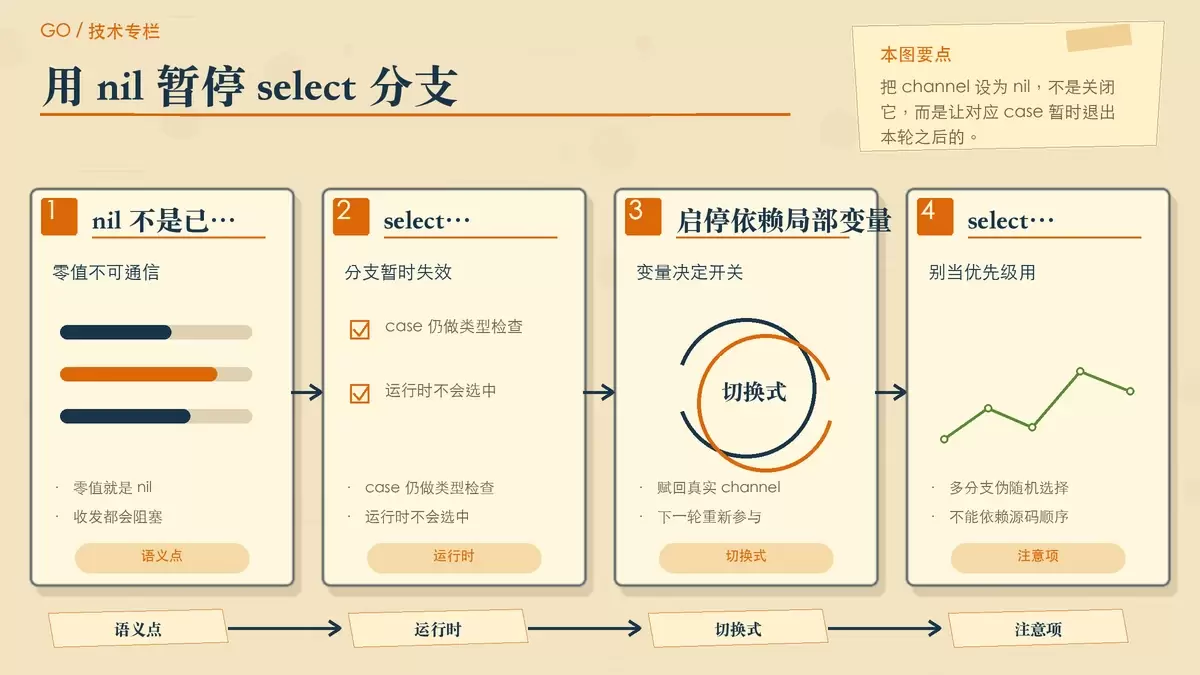
nil channel 到底是什么,为什么能控制 select
channel 和 slice、map、指针一样,零值都是 nil。如果只声明、不用 make 初始化,拿到的就是一个 nil channel:
var ch chan int
fmt.Println(ch == nil) // true
它不是“已关闭的 channel”,也不是“还没收到值的普通 channel”。根据 Go 语言规范,向 nil channel 发送会永久阻塞,从 nil channel 接收同样会永久阻塞。
var ch chan int
ch <- 1 // 永久阻塞
如果一个 goroutine 没有别的退出路径,单独执行这种收发语句,就会一直卡住。更进一步,如果程序里的所有 goroutine 都因此无法继续推进,Go 运行时通常会把它识别为死锁并终止程序。
nil channel 真正有用的地方,不是直接收发,而是配合 select 使用。因为 select 只会从当前可以执行的通信分支中挑一个执行,而 nil channel 上的通信永远不可能完成,所以对应分支天然不会被选中,相当于被临时禁用。
var ch chan int
select {
case v := <-ch:
    fmt.Println(v) // 不会执行
default:
    fmt.Println("disabled")
}
这里要注意两点。
第一,这个 case 并没有从代码里消失,编译器照样做类型检查;只是运行时不会选中它。第二,只要后面把 ch 换回一个有效 channel,这个分支就会重新参与下一轮 select。如果多个通信分支同时可执行,Go 规范要求从中进行均匀伪随机选择,不能把源码里谁写在前面当成优先级机制来依赖。
用局部变量启停分支,比写多套 select 更直接
一个很典型的场景是“服务准备好之前先别接任务”。这时没必要写两套循环,可以保留真实的任务 channel,再用一个局部变量控制它是否参与 select:
jobs := make(chan Job)
var activeJobs <-chan Job
if ready {
    activeJobs = jobs
}
这里的 activeJobs 是 <-chan Job,表示只能接收的 channel 类型,它的零值同样是 nil。双向的 jobs 类型是 chan Job,可以赋值给接收专用的 activeJobs,但反向赋值不成立。
接下来就可以在同一个 select 里动态开关这条分支:
select {
case job := <-activeJobs:
    handle(job)
case <-reload:
    activeJobs = jobs
}
当 activeJobs == nil 时,接收任务的分支处于禁用状态;一旦把它设为 jobs,后续轮次里这条分支就会重新启用。这个写法的价值,在于把“当前能不能收任务”这个状态,直接编码进 channel 变量本身,不必再围着 ready 写额外的条件分叉。
不过这里还有一个很关键、也经常被忽略的细节:进入一次 select 时,各个通信操作的 channel 操作数,以及发送语句右侧表达式,都会按源码顺序求值一次。也就是说,分支内部对变量的修改,只会影响下一轮 select,不会改变本轮已经做出的选择。
这也解释了另一个常见误区:如果某次 select 因为所有通信分支都不可执行而阻塞,仅仅在别的地方把原 channel 变量改成非 nil,并不会让这次 select 自动重新求值或醒来。通常更稳妥的做法,是由同一个 goroutine 在其他可执行分支里更新变量,然后进入下一轮循环;如果跨 goroutine 修改同一个 channel 变量,还必须先解决数据竞争问题。
本质上,这个模式切换的不是 channel 的生命周期,而是当前这轮 select 看见的引用。真实的 jobs 仍可被其他 goroutine 持有和使用,不需要关闭,也不需要重建。
多路合并时,怎么把已关闭输入真正移出循环
另一个更常见的用法,是合并多个输入流。比如同时从 left 和 right 接收数据,只要有一边关闭并且缓冲也排空了,就应该把那条分支永久停掉。
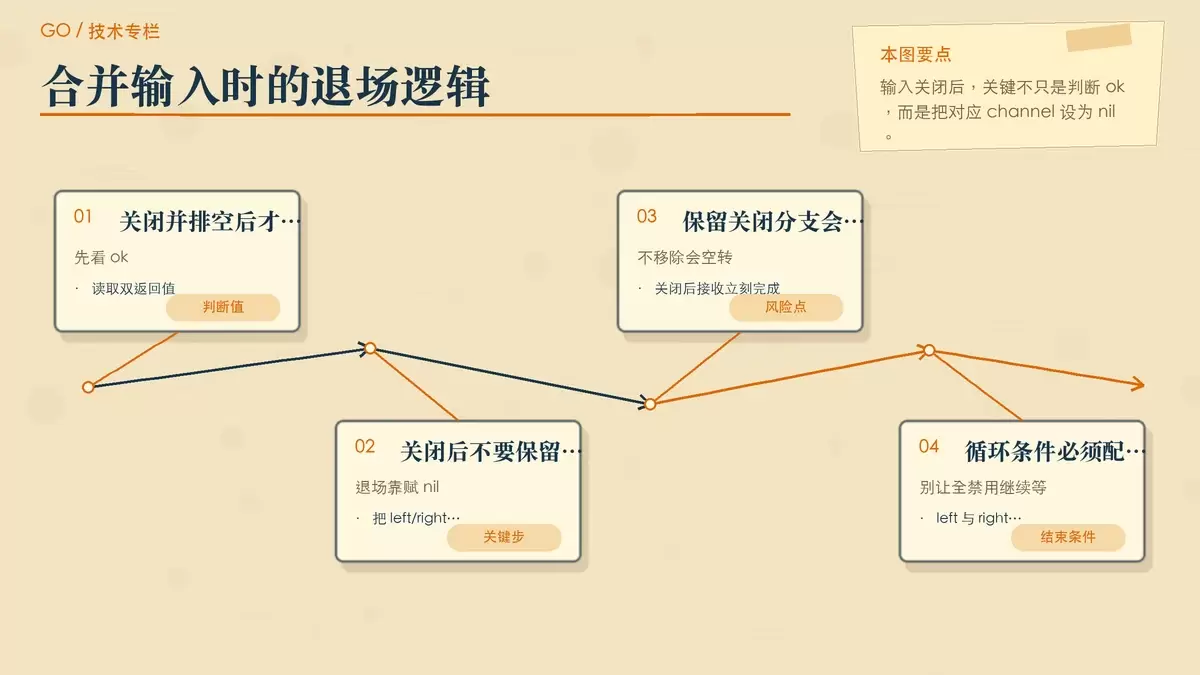
判断依据是双返回值接收里的 ok:
v, ok := <-ch
if !ok {
    ch = nil
}
只有在 channel 已关闭且缓冲区已经读空时,接收到关闭产生的零值,ok 才会是 false。把这个逻辑放进循环,就能在一个 goroutine 里完成干净的多路合并:
for left != nil || right != nil {
    select {
    case v, ok := <-left:
        if !ok { left = nil; continue }
        consume(v)
    case v, ok := <-right:
        if !ok { right = nil; continue }
        consume(v)
    }
}
这里有两个要点不能省。
第一,发现 ok == false 后,要把对应变量设为 nil,而不是继续保留原 channel。原因是:关闭且排空后的 channel,后续接收都会立刻返回元素类型的零值,并且 ok 始终为 false。如果不把它移除,这个分支会一直处于“立即可执行”状态,循环就可能不断空转,平白占用 CPU。
第二,循环条件必须和分支退场配套。上面的 for left != nil || right != nil 不是装饰;如果两个输入都已经变成 nil,你却继续执行一个没有 default 的 select,那所有通信分支都不可能执行,goroutine 就会永久阻塞。
这正是 nil channel 在多路合并里最实用的地方:它不是简单地“知道某个输入关了”,而是能把这条分支从后续竞争中彻底摘掉,让剩余逻辑继续保持干净的单循环结构。
队列为空时禁用发送,让输入和输出共用一套 select
nil channel 不只适合控制接收分支,同样适合控制发送分支。一个非常实用的模式是:goroutine 内部维护待发送队列,队列为空时不允许向下游发送,队列里有数据时再打开输出分支。
假设外层循环条件是 input != nil || len(queue) > 0。每轮开始时,先根据队列状态准备本轮要使用的输出 channel 和待发送值:
inCh := input
var outCh chan<- Event
var next Event
if len(queue) > 0 {
    outCh = output
    next = queue[0]
}
然后在同一个 select 里同时处理“接收新事件”和“发送队首事件”:
select {
case event, ok := <-inCh:
    if !ok { input = nil; continue }
    queue = append(queue, event)
case outCh <- next:
    queue = queue[1:]
}
这里的关键点很明确:
当队列为空时,outCh 保持 nil,发送分支被禁用,所以不会误把 next 的零值发出去。只有在队列非空时,outCh 才指向真实的 output,并在下游可接收时真正发生发送。
同样地,当输入关闭并且接收返回 ok == false 时,必须把 input 设为 nil。否则这条接收分支会不断读到零值,逻辑很快失真。等内部队列最终排空之后,外层循环条件才会自然变成假,整个 goroutine 才能安全退出。
这类写法的好处,不在于技巧本身,而在于状态统一。你不需要分别维护“队列为空时的一套 select”和“队列非空时的另一套 select”,而是让 channel 值直接表达“这轮能不能发”,整个状态机会更稳定,也更容易检查遗漏分支。
用 nil 做背压时,几个边界必须提前想清楚
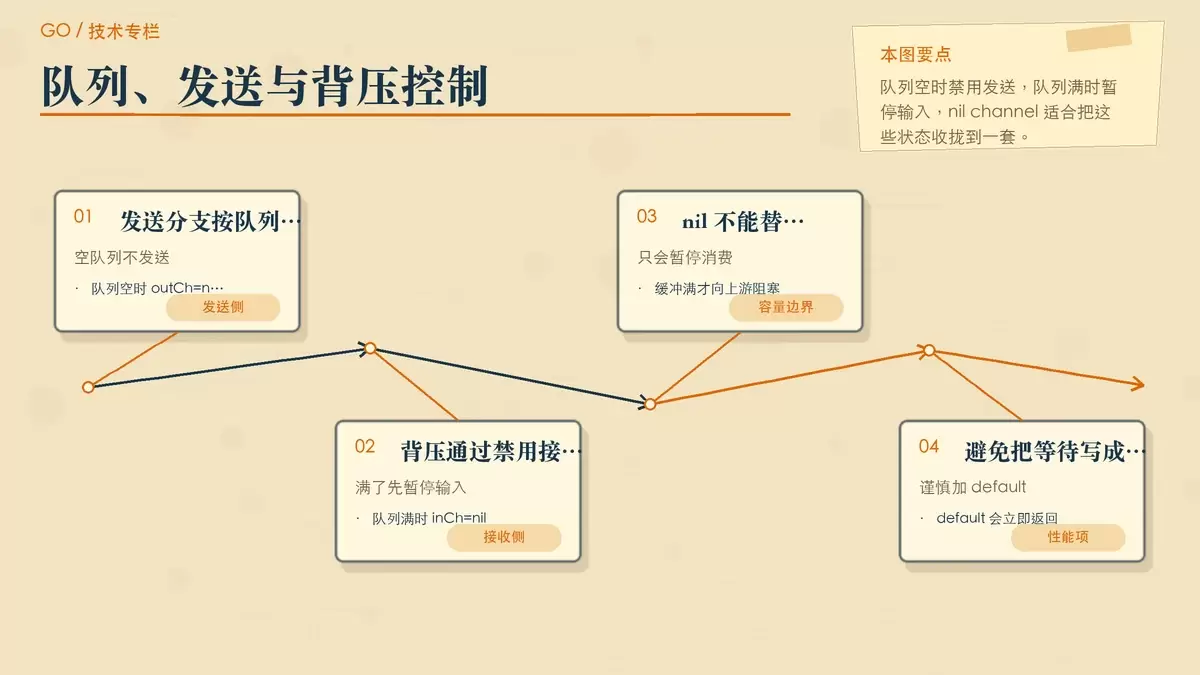
如果内部队列还要限制长度,可以把前面的模式再往前推一步:队列达到上限时,临时关闭输入分支;等队列腾出空间,再恢复接收。写法也很简单:
inCh := input
if len(queue) >= maxQueue {
    inCh = nil
}
这样一来,队列满时本轮仍然可以向下游发送,但不会继续从上游取数据;只要发送成功、队列长度下降,下一轮再把 inCh 指回 input,接收就会自动恢复。这是一种协作式背压:本地处理不过来时,先停止继续消费。
不过它能解决的是“暂停读取”,不是“凭空增加容量”。如果 input 本身带缓冲,上游还可以继续写满剩余容量;缓冲耗尽之后,阻塞才会向上游继续传播。如果业务要求上游永不等待,那就必须单独设计丢弃、落盘或者扩容策略,不能指望 nil channel 自动处理容量问题。
另外,maxQueue 需要是大于零的有效上限。否则很容易出现输入和输出都被禁用的状态,整个循环再也推进不了。
还有一个很常见的坑是给循环随手加上 default。default 会让 select 在没有任何通信可执行时立刻返回,如果外层循环里没有休眠或其他阻塞点,就会形成忙循环。很多场景里,这并不是“避免阻塞”,而是把本来正确的等待,变成持续消耗 CPU 的空转。
最后,这几个边界一定要分清:
nil channel 和已关闭 channel 不是一回事
nil channel 上的收发永远不能完成;已关闭 channel 的接收则可以立即完成,会先取走关闭前缓冲中的值,排空后持续返回零值。反过来,向已关闭的 channel 发送,或者再次关闭它,都会触发 panic。
动态禁用分支不需要 close
对于值为 nil、但类型上允许发送的 channel,调用 close 会直接 panic;而接收专用的 <-chan T 根本不能作为 close 的参数,代码连编译都过不去。要让分支失效,只需要把变量设为 nil,不需要关闭它。
共享 channel 变量仍然要做同步
如果多个 goroutine 同时读写同一个 channel 变量,本质上仍然可能发生数据竞争。更稳妥的做法,通常是让一个 goroutine 独占状态与 select 循环,其他 goroutine 通过额外的控制 channel 发送启用、暂停或退出命令。
不要把 nil channel 当普通业务值随意传播
nil 更适合做并发状态机内部的控制值。如果某个函数可能返回 nil channel,最好在 API 契约里明确说明;否则调用方很容易写出会永久等待的代码,而且问题往往不容易在第一时间看出来。
把这几点串起来看,nil channel 的核心作用其实很单纯:利用“永远无法通信”的语义,让某个 select case 暂时退出竞争。把真实 channel 赋给局部变量,是启用分支;把变量设为 nil,就是禁用分支。只要把全禁用阻塞、关闭后零值接收、default 忙循环和共享状态同步这些边界处理完整,它就会是构建状态机、多路合并和背压控制时非常可靠的一把工具。









