


很多人第一次遇到这个问题,往往是在服务下线、任务停止或协程退出时:明明已经发出了停止信号,后台 goroutine 却还在继续处理任务,甚至拖了几秒到几分钟才真正结束。问题并不一定出在业务代码本身,而是出在 Go 对 select 的默认设计。
这篇文章要解决的就是这个工程上很常见、但又容易被误判的问题:为什么控制信号会在高负载下失去“即时性”,以及怎样在不破坏 Go 并发模型的前提下,让退出通道获得更高优先级。看完后,你可以判断哪些场景适合继续使用普通 select,哪些场景应该换成双重检查模式。
为什么 Go 的 select 会故意做成随机选择
先说结论:当 select 中有多个分支同时就绪时,Go 运行时不会按你书写的顺序挑选,而是随机选择一个分支执行。
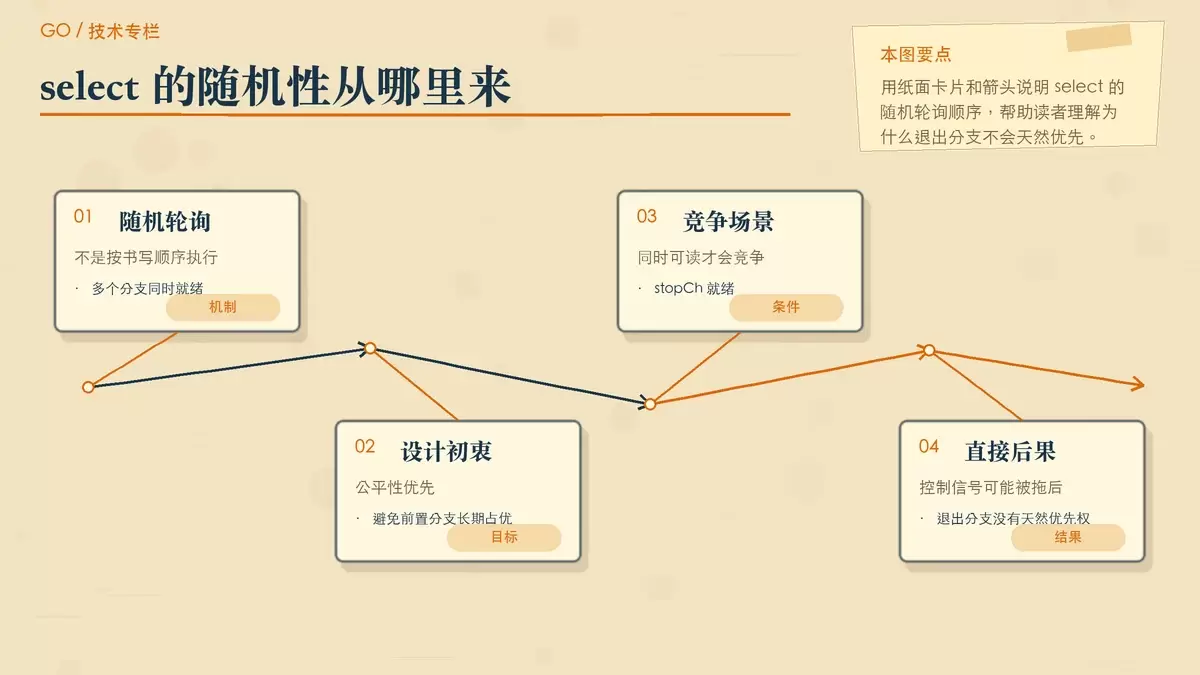
这样设计的目的不是“反直觉”,而是为了并发公平性。否则,排在前面的通道可能长期占优,后面的通道在高并发场景下更容易出现局部饥饿。
在编译阶段,select 会被转换成对运行时函数 runtime.selectgo 的调用。它的核心做法之一,就是把分支的轮询顺序打乱。原文里给出的简化逻辑如下:
// 简化后的 runtime.selectgo 轮询顺序打乱逻辑
for i := 1; i < ncases; i++ {
    j := fastrandn(uint32(i + 1))
    pollorder[i] = pollorder[j]
    pollorder[j] = uint16(i) // 随机打乱轮询顺序
}
这里的关键点在于 fastrandn。它会让 pollorder 的顺序发生变化,也就意味着:哪怕你把退出分支写在最前面,只要退出通道和数据通道同时可读,它们被选中的概率依然是近似均等的。
这正是很多“退出不及时”问题的源头。代码看起来像是在“优先监听退出”,但运行时其实没有给这个分支特殊待遇。
高负载下,随机性为什么会变成真实 Bug
下面这段代码是很常见的后台消费模型。goroutine 在循环里处理 taskCh 的任务,同时监听 stopCh,以便在收到停止信号后退出:
for {
    select {
    case <-stopCh:
        return
    case task := <-taskCh:
        process(task)
    }
}
在轻载场景下,这段代码通常没有问题,因为 taskCh 并不总是处于就绪状态,stopCh 一旦可读,退出往往也很快发生。
但一旦系统进入高负载,情况就变了。如果 taskCh 中已经积压了大量任务,或者上游持续高速投递数据,那么它几乎每次循环都会处于可读状态。此时每轮 select 都是在两个“已就绪”分支之间做随机选择。
从概率上看,stopCh 和 taskCh 各有 50% 的机会被选中。问题在于,这个 50% 并不等于“马上退出”。因为只要这轮随机选中了任务分支,goroutine 就会继续执行一次 process(task),然后再进入下一轮选择。
如果任务处理本身不轻,或者任务堆积很多,退出信号就会在一次次随机竞争中被不断推迟。落到真实生产环境里,常见后果包括:
- Kubernetes 优雅退出窗口被耗尽,进程来不及自行结束,最终被强制杀掉。
- 高优先级的暂停、撤销、终止类控制指令,响应明显滞后。
- 服务虽然“理论上支持退出”,但在流量高峰时表现得像无法及时停机。
这里最值得警惕的一点是:这不是偶发边角问题,而是 select 随机策略在特定业务目标下的自然结果。Go 追求的是公平,不是控制指令优先。
双重检查模式:给控制信号更高优先级
如果业务要求“停止、取消、退出”必须尽快生效,就需要主动打破这种随机性。一个常见且实用的做法,是把一次 select 拆成两段:先做一次非阻塞预检,再进入正常的阻塞监听。
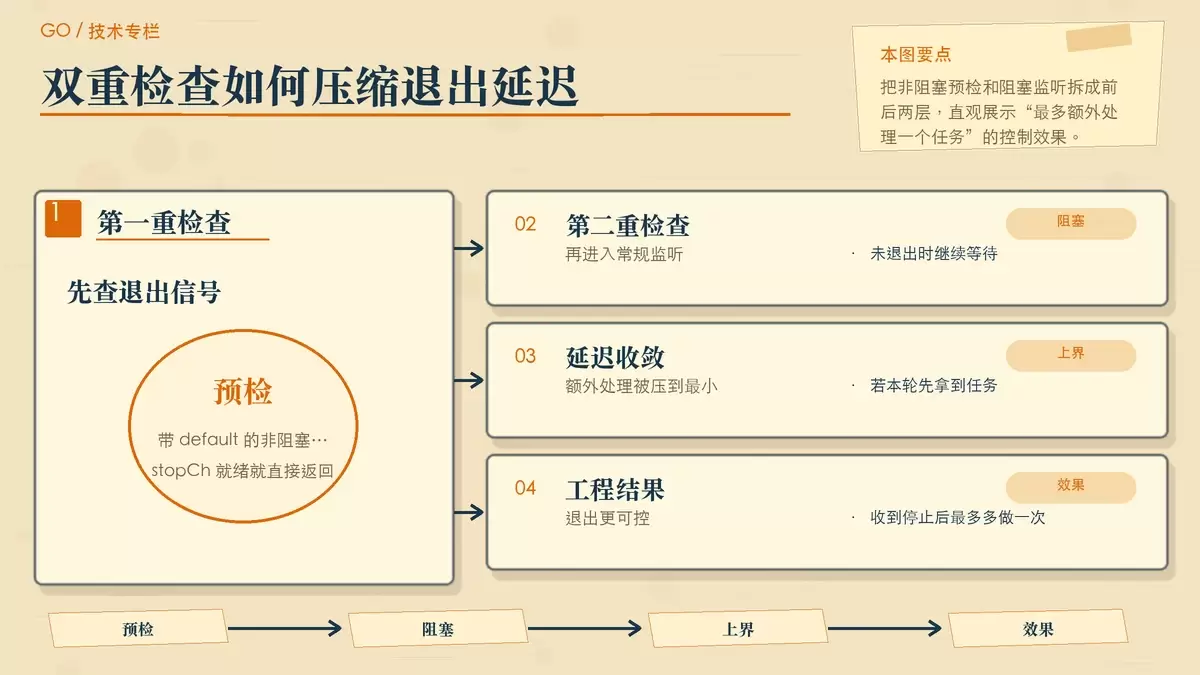
第一步是非阻塞检查退出信号:
select { // 第一重检查:非阻塞预检
case <-stopCh:
    return
default:
}
这段代码的作用很明确:只要 stopCh 已经就绪,就立刻返回;如果还没就绪,就通过 default 直接落下去,不阻塞当前循环。
接着再进入第二重检查,也就是原本常规的阻塞监听:
select { // 第二重检查:常规阻塞监听
case <-stopCh:
    return
case task := <-taskCh:
    process(task)
}
把两段合起来后,整个循环就变成了“先看控制信号,再决定是否继续处理任务”的结构。完整思路可以理解为:
- 如果退出信号已经到了,第一重检查会直接命中,立即退出。
- 如果退出信号还没到,才进入第二重阻塞
select等待新事件。 - 即便第二重检查里随机选中了
taskCh,处理完当前任务后,下一轮循环一开始又会先做一次退出预检。
这意味着,一旦 stopCh 变为就绪,goroutine 最多只会额外处理一个任务,然后就在下一轮的第一重检查中直接退出。
换句话说,这种模式并不是把 Go 的随机机制彻底取消,而是通过“循环前置预检”把退出延迟收敛到一个很小、很可控的范围内。对很多实时性要求较高的后台任务、消费者、工作池来说,这已经足够实用。
也可以把 stopCh 换成 ctx.Done()
如果你的服务已经普遍使用 context.Context 管理生命周期,那么这个模式可以直接平移过去,用 ctx.Done() 替代 stopCh。这样做的好处是,协程退出和请求取消、服务关闭、超时控制能统一到同一套上下文机制里。
思路不变,仍然是“先非阻塞预检,再常规阻塞等待”。这样既能保留上下文管理的一致性,也能避免取消信号在繁忙数据通道面前反复被随机延后。
性能开销有多大,适合在哪些场景使用
看到这里,一个很自然的问题是:每轮循环都额外多做一次 select,会不会让性能明显变差?
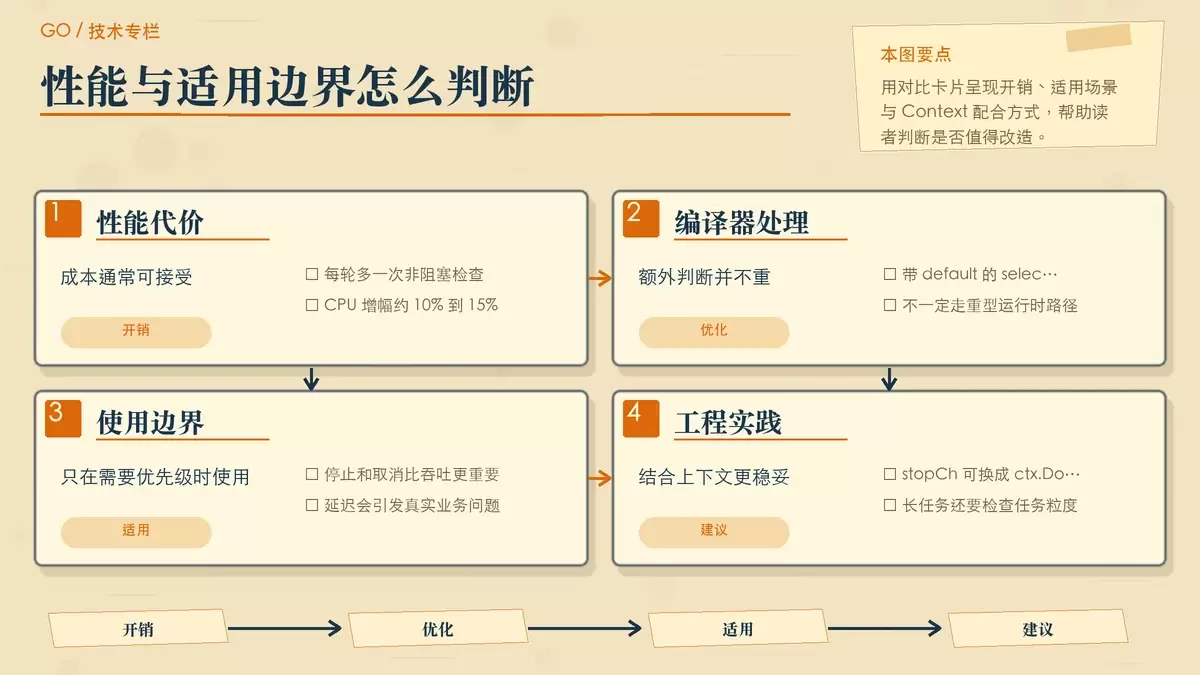
从 Go 编译器的处理方式看,带 default 的非阻塞 select 通常会触发内联优化。也就是说,它并不一定会走完整、较重的运行时路径,而是可能被编译成低成本的读取尝试或原子级判断。
原文给出的经验结论是,在高频调用场景下,双重检查模式带来的 CPU 开销大约增加 10% 到 15%。这个增幅不是零,但对绝大多数业务系统来说,通常远小于“退出延迟失控”带来的工程代价。
更实际的判断方式,不是只盯着这 10% 到 15%,而是看你的场景到底需不需要“控制优先级”。可以按下面两个标准来判断:
什么情况下值得重构
- 控制信号明显比数据处理更重要,例如停止消费、撤销任务、关闭 worker、优雅下线。
- 控制延迟会直接造成业务问题,而不只是“多处理几条数据也无所谓”。
如果你的场景只是普通生产者-消费者模型,对退出实时性没有严格要求,那么保持原始写法通常更简单,也更符合 Go 默认的公平语义。
工程上更稳妥的用法
- 按需使用:不要把双重检查当成所有
select循环的默认模板,而是放在确实存在控制优先级需求的路径上。 - 结合 Context:优先考虑把
stopCh替换成ctx.Done(),让取消、超时、服务生命周期控制保持一致。 - 关注任务粒度:如果
process(task)本身执行时间很长,那么即便最多只“多处理一个任务”,这个任务也可能很重。必要时还要继续细化任务拆分或在处理过程中检查上下文。
最后这一点很重要:双重检查模式解决的是 select 层面的随机延迟,不会自动缩短单个任务本身的执行时间。若单次任务耗时过长,退出速度仍会受任务粒度影响。
结语:公平不是所有场景下的最优解
Go 把 select 设计成随机选择,本质上是在为并发公平性兜底。这在大多数通道协作场景里是合理的,也避免了代码书写顺序天然带来的偏置。
但在退出、取消、停机这类控制信号面前,绝对公平往往并不是业务真正想要的行为。高负载下,数据流和控制流放在同一层随机竞争,结果就是控制响应被拉长。
双重检查模式的价值,就在于用很小的实现改动和可接受的 CPU 成本,把“收到退出后仍持续消费”的问题压缩到最多额外处理一个任务的范围内。对于需要更强控制实时性的 Go 服务来说,这是一种简单、清晰且足够工程化的处理方式。









