


Node.js 应用跑在 CentOS 上,很多人第一反应是先查代码热点,但真正影响吞吐和稳定性的,常常是系统层和运行层的基础配置没有跟上。本文按“系统参数、内存与进程、代码与数据库、Nginx 与监控”几个层面拆开讲,既保留可直接执行的命令和配置,也补出每一步适合解决什么问题,便于你判断该先动哪一层。
系统基础优化:先把底层运行环境打稳
如果 CentOS 本身的网络、文件句柄和内核队列配置偏保守,Node.js 即便代码写得不错,也可能在高并发下提前碰到瓶颈。系统层优化通常是生产环境调优的起点。
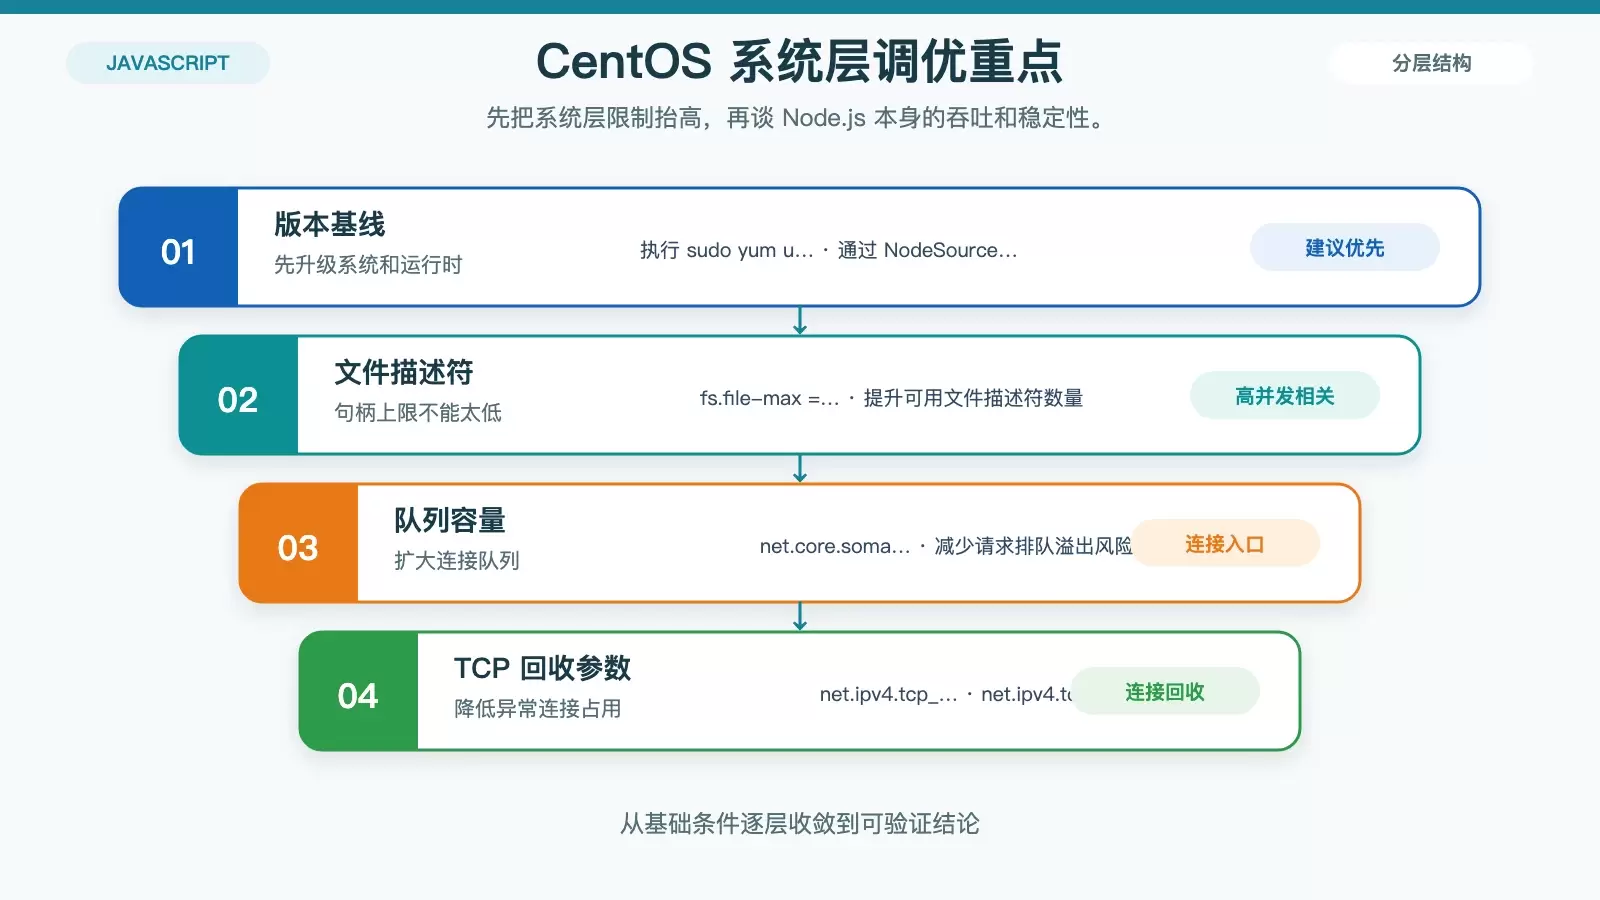
更新系统并安装较新的 Node.js LTS
第一步是把系统组件和 Node.js 运行时更新到合适版本。较新的 LTS 版本通常会带来性能改进和 bug 修复,老版本则可能在 GC、网络栈适配和依赖生态上都更吃亏。
sudo yum update -y
curl -sL https://rpm.nodesource.com/setup_16.x | sudo bash -
sudo yum install -y nodejs
这里保留了原文中的 NodeSource 安装方式和 setup_16.x 示例。如果你的业务环境已有固定版本规范,应以现网兼容性为准,但原则上不建议长期停留在过旧版本。
调整内核参数,优先处理高并发常见限制
修改 /etc/sysctl.conf 可以直接影响连接处理能力和系统资源上限。对 Node.js 服务来说,下面几个参数最常见,也最值得优先检查:
fs.file-max = 65536:提高文件描述符上限,适合连接数和并发请求较高的场景。net.ipv4.tcp_tw_reuse = 1:复用TIME-WAIT连接,减少连接建立开销。net.core.somaxconn = 4096:扩大连接队列长度,降低排队溢出的风险。net.ipv4.tcp_max_orphans = 32768:提高孤儿连接上限,避免异常连接过多时挤占资源。
配置完成后,记得让参数立即生效:
sudo sysctl -p这一层的目标不是“调得越大越好”,而是让系统默认值不要先成为业务瓶颈。参数是否合适,最终还要结合连接数、负载类型和机器规格来验证。
资源限制与进程模型:解决内存和多核利用率问题
当应用开始处理大文件、复杂计算或高并发请求时,Node.js 默认配置往往会显得保守。这个阶段重点看两件事:内存是否够用,多核 CPU 是否被真正利用起来。
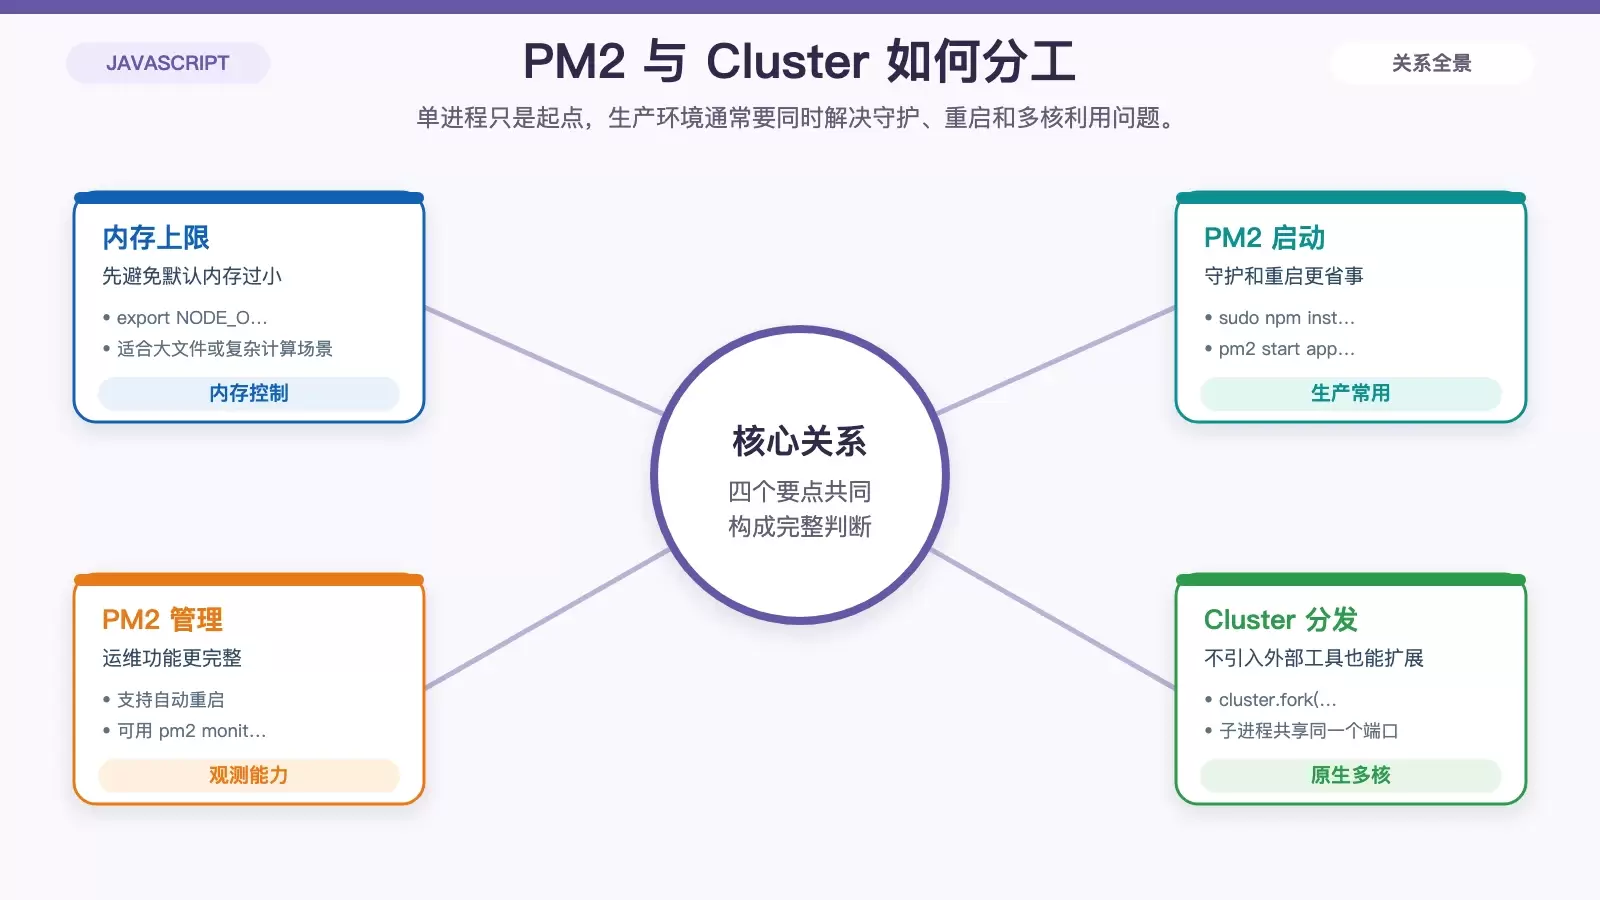
按机器规格调整 Node.js 内存上限
Node.js 默认的内存限制在某些场景下容易过早触顶,典型表现就是进程触发 OOM。可以通过 NODE_OPTIONS 调整老生代内存上限:
export NODE_OPTIONS="--max_old_space_size=4096"这里的 4096 表示 4GB。数值不应机械照搬,而应根据服务器总内存、应用实例数和是否与数据库、Nginx 等服务共机部署来决定。内存上限调大后,确实能缓解大对象和大文件处理时的崩溃风险,但也会增加单进程可占用的资源范围,因此最好配合监控一起观察。
用 PM2 或 Cluster 把多核 CPU 利用起来
Node.js 单进程模型很轻,但现代服务器普遍是多核 CPU,只开一个实例通常会浪费硬件能力。常见做法有两种。
方案一:使用 PM2 做进程守护与多实例管理。 这是生产环境里最常见的方式,部署简单,带有守护、自动重启、负载均衡和监控能力。
sudo npm install pm2 -g
pm2 start app.js --name my-app
pm2 monit
方案二:直接使用 Node.js 自带的 Cluster 模块。 如果不希望额外引入外部进程管理工具,Cluster 也可以让多个子进程共享同一个端口,把请求分发到多个 CPU 核心。
const cluster = require('cluster');
const numCPUs = require('os').cpus().length;
if (cluster.isMaster) {
  for (let i = 0; i < numCPUs; i++) cluster.fork();
} else {
  require('./app.js'); // 启动应用
}
两者的取舍很直接:如果你需要更完整的生产运维能力,PM2 更省事;如果你只想利用多核、并控制运行逻辑,Cluster 已经够用。
代码与数据访问优化:性能瓶颈常常藏在这里
系统层优化解决的是“底盘问题”,真正决定请求耗时和资源占用的,往往还是代码执行方式、I/O 模型和数据库访问路径。这一层通常比单纯加机器更能带来持续收益。
避免阻塞事件循环,优先使用异步 I/O
Node.js 的核心优势在于事件循环和非阻塞 I/O。如果数据库查询、文件读写或网络请求写成阻塞式逻辑,再好的系统参数也很难把性能拉起来。原文建议继续成立:优先使用 async/await 或 Promise 替代层层回调,在可读性更好的同时,也更容易避免把事件循环拖慢。
处理大文件时,尽量改为流式传输
大文件场景最常见的问题,是一次性把内容全部读入内存,导致进程内存迅速膨胀,严重时直接触发 OOM。更稳妥的做法是使用 Stream 模块按流处理:
const fs = require('fs');
const readStream = fs.createReadStream('large-file.txt');
const writeStream = fs.createWriteStream('output.txt');
readStream.pipe(writeStream); // 流式传输
这种方式不会把整个文件一次性压进内存,对日志处理、文件转存、批量导出这类任务尤其有效。
数据库索引、连接池与缓存要一起看
很多 Node.js 接口慢,并不是因为 JavaScript 执行慢,而是卡在数据库访问和重复计算上。这里至少要检查三件事:
- 为高频查询字段建立索引,减少全表扫描。
- 使用连接池,例如
mysql2的pool配置,避免频繁创建和销毁连接。 - 对热点数据增加缓存,可选
node-cache或 Redis,缓存接口结果、静态资源或重复计算结果。
这几项优化常常是叠加生效的:索引解决单次查询效率,连接池解决建连成本,缓存则直接减少访问次数。实际收益通常比单独改一处更明显。
把静态资源和入口流量交给 Nginx
Node.js 很适合做应用逻辑层,但并不擅长高并发静态资源分发。把静态文件、反向代理和部分传输优化前移到 Nginx,通常能明显减轻应用层压力。
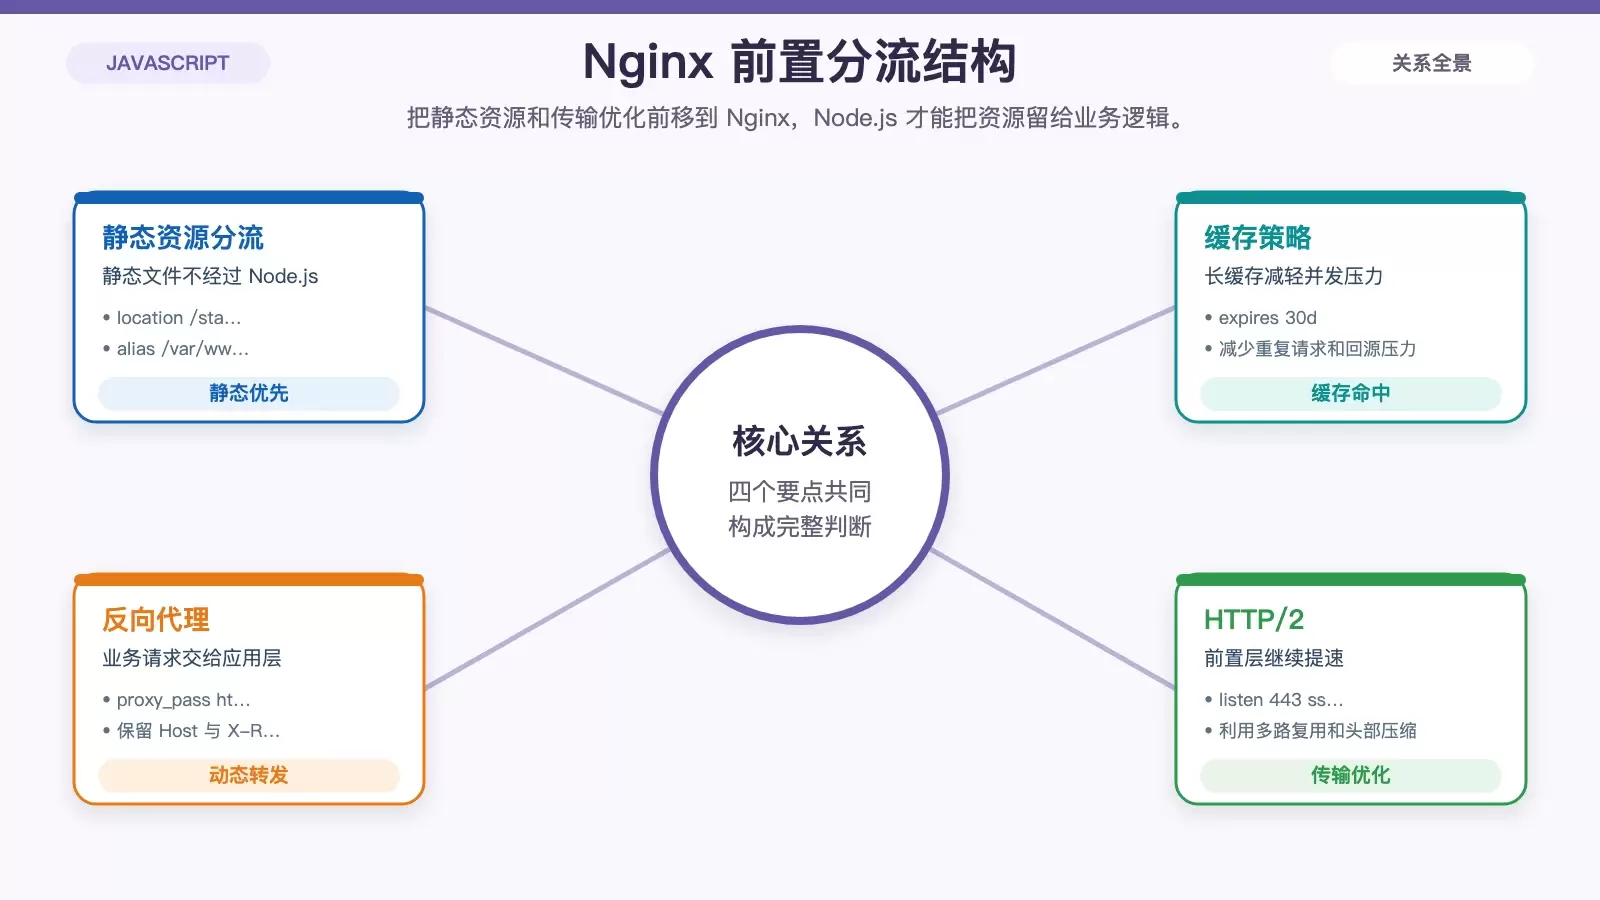
配置反向代理和静态资源缓存
原文给出的 Nginx 配置适合拿来作为基础模板:静态资源直接由 Nginx 处理,动态请求再转发给本地的 Node.js 服务。
server {
  listen 80;
  server_name example.com;
  location /static/ {
    alias /var/www/static/; # 静态资源目录
    expires 30d;            # 缓存30天
  }
  location / {
    proxy_pass http://localhost:3000; # 转发到Node.js
    proxy_set_header Host $host;
    proxy_set_header X-Real-IP $remote_addr;
  }
}
这种分工的价值很明确:静态资源请求不再占用 Node.js 事件循环,缓存策略也能减少重复回源。对于接口服务来说,应用进程可以更专注于处理业务逻辑。
启用 HTTP/2 提升传输效率
如果站点已经配置 SSL 证书,可以在 Nginx 中开启 HTTP/2:
listen 443 ssl http2;HTTP/2 的多路复用和头部压缩对资源较多的页面尤其有效,能够减少连接竞争和重复传输开销。它不是替代业务优化的“万能开关”,但作为前置层增强,通常值得启用。
监控与分析:优化是否生效,要靠数据说话
性能优化不是一次性动作。参数改了、实例加了、缓存上了,如果没有监控和分析工具,很难判断收益是否真实,也很难在回归时快速定位问题。
开发阶段先用内置分析工具定位热点
Node.js 自带的调试能力已经足够完成很多基础性能排查。可以通过下面的方式启动:
node --inspect app.js然后使用 Chrome DevTools 查看 CPU 使用、内存占用和调用栈。对于开发环境来说,这种方式足够直接,适合先定位函数热点、阻塞逻辑和明显的内存异常。
生产环境建议补齐完整监控链路
线上环境更适合使用完整监控方案,例如 New Relic、AppDynamics,或者 Prometheus + Grafana。重点不是工具本身,而是要能持续看到这些指标:
- QPS
- 响应时间
- 错误率
只有把这些指标和系统参数、进程实例数、数据库负载一起看,才能判断这次优化究竟是在提升吞吐,还是只是把压力转移到了别的环节。









