

基于随机梯度下降的矩阵分解推荐算法实现(Python)

发布时间:2026-10-13| 4人浏览过
本文介绍利用随机梯度下降(SGD)优化矩阵分解的推荐系统算法。通过将用户-物品评分矩阵分解为用户特征矩阵与物品特征矩阵,利用已知评分训练模型以预测未知评分。代码基于MovieLens数据集,展示了从数据预处理、模型训练到结果评估的完整Python实现流程。
奇异值分解(SVD)是矩阵分解中的经典方法,其核心原理在于将原始矩阵M分解为三个子矩阵A、B与C的乘积。由于中间矩阵B可以与左侧矩阵A或右侧矩阵C进行合并,该过程最终可简化为两个矩阵M1与M2的乘积,从而得到原始矩阵M。
基于此原理,矩阵分解推荐算法将用户和物品的潜在特征分别表示为矩阵M1和M2。通过计算这两个矩阵的乘积来重构原始评分矩阵M。具体实现中,利用已有的用户-物品评分数据,采用随机梯度下降(SGD)方法迭代优化,求解出最能拟合现有数据的用户特征矩阵M1与物品特征矩阵M2。一旦获得这些潜在特征,即可通过特征向量的内积计算用户未评分物品的预测得分。
实验数据选用MovieLens数据集,并预先划分为训练集与测试集。鉴于数据规模较大,本次实现并未使用全部数据,而是选取了部分样本进行模型训练与验证。
具体实现代码如下:
# -*- coding: utf-8 -*-
"""
Created on Mon Oct 9 19:33:00 2017
@author: wjw
"""
import pandas as pd
import numpy as np
import os

def difference(left,right,on): #求两个dataframe的差集
 df = pd.merge(left,right,how='left',on=on) #参数on指的是用于连接的列索引名称
 left_columns = left.columns
 col_y = df.columns[-1] # 得到最后一列
 df = df[df[col_y].isnull()]#得到boolean的list
 df = df.iloc[:,0:left_columns.size]#得到的数据里面还有其他同列名的column
 df.columns = left_columns # 重新定义columns
 return df

def readfile(filepath): #读取文件,同时得到训练集和测试集

 pwd = os.getcwd()#返回当前工程的工作目录
 os.chdir(os.path.dirname(filepath))
 #os.path.dirname()获得filepath文件的目录;chdir()切换到filepath目录下
 initialData = pd.read_csv(os.path.basename(filepath))
 #basename()获取指定目录的相对路径
 os.chdir(pwd)#回到先前工作目录下
 predData = initialData.iloc[:,0:3] #将最后一列数据去掉
 newIndexData = predData.drop_duplicates()
 trainData = newIndexData.sample(axis=0,frac = 0.1) #90%的数据作为训练集
 testData = difference(newIndexData,trainData,['userId','movieId']).sample(axis=0,frac=0.1)
 return trainData,testData

def getmodel(train):
 slowRate = 0.99
 preRmse = 10000000.0
 max_iter = 100
 features = 3
 lamda = 0.2
 gama = 0.01 #随机梯度下降中加入,防止更新过度
 user = pd.DataFrame(train.userId.drop_duplicates(),columns=['userId']).reset_index(drop=True) #把在原来dataFrame中的索引重新设置,drop=True并抛弃

 movie = pd.DataFrame(train.movieId.drop_duplicates(),columns=['movieId']).reset_index(drop=True)
 userNum = user.count().loc['userId'] #671
 movieNum = movie.count().loc['movieId']
 userFeatures = np.random.rand(userNum,features) #构造user和movie的特征向量集合
 movieFeatures = np.random.rand(movieNum,features)
 #假设每个user和每个movie有3个feature
 userFeaturesFrame =user.join(pd.DataFrame(userFeatures,columns = ['f1','f2','f3']))
 movieFeaturesFrame =movie.join(pd.DataFrame(movieFeatures,columns= ['f1','f2','f3']))
 userFeaturesFrame = userFeaturesFrame.set_index('userId')
 movieFeaturesFrame = movieFeaturesFrame.set_index('movieId') #重新设置index

 for i in range(max_iter):
  rmse = 0
  n = 0
  for index,row in user.iterrows():
   uId = row.userId
   userFeature = userFeaturesFrame.loc[uId] #得到userFeatureFrame中对应uId的feature

   u_m = train[train['userId'] == uId] #找到在train中userId点评过的movieId的data
   for index,row in u_m.iterrows():
    u_mId = int(row.movieId)
    realRating = row.rating
    movieFeature = movieFeaturesFrame.loc[u_mId]

    eui = realRating-np.dot(userFeature,movieFeature)
    rmse += pow(eui,2)
    n += 1
    userFeaturesFrame.loc[uId] += gama * (eui*movieFeature-lamda*userFeature)
    movieFeaturesFrame.loc[u_mId] += gama*(eui*userFeature-lamda*movieFeature)
  nowRmse = np.sqrt(rmse*1.0/n)
  print('step:%f,rmse:%f'%((i+1),nowRmse))
  if nowRmse<preRmse:
   preRmse = nowRmse
  elif nowRmse<0.5:
   break
  elif nowRmse-preRmse<=0.001:
   break
  gama*=slowRate
 return userFeaturesFrame,movieFeaturesFrame

def evaluate(userFeaturesFrame,movieFeaturesFrame,test):
 test['predictRating']='NAN' # 新增一列

 for index,row in test.iterrows():

  print(index)
  userId = row.userId
  movieId = row.movieId
  if userId not in userFeaturesFrame.index or movieId not in movieFeaturesFrame.index:
   continue
  userFeature = userFeaturesFrame.loc[userId]
  movieFeature = movieFeaturesFrame.loc[movieId]
  test.loc[index,'predictRating'] = np.dot(userFeature,movieFeature) #不定位到不能修改值

 return test

if __name__ == "__main__":
 filepath = r"E:\学习\研究生\推荐系统\ml-latest-small\ratings.csv"
 train,test = readfile(filepath)
 userFeaturesFrame,movieFeaturesFrame = getmodel(train)
 result = evaluate(userFeaturesFrame,movieFeaturesFrame,test)
在测试集上的预测结果如下:
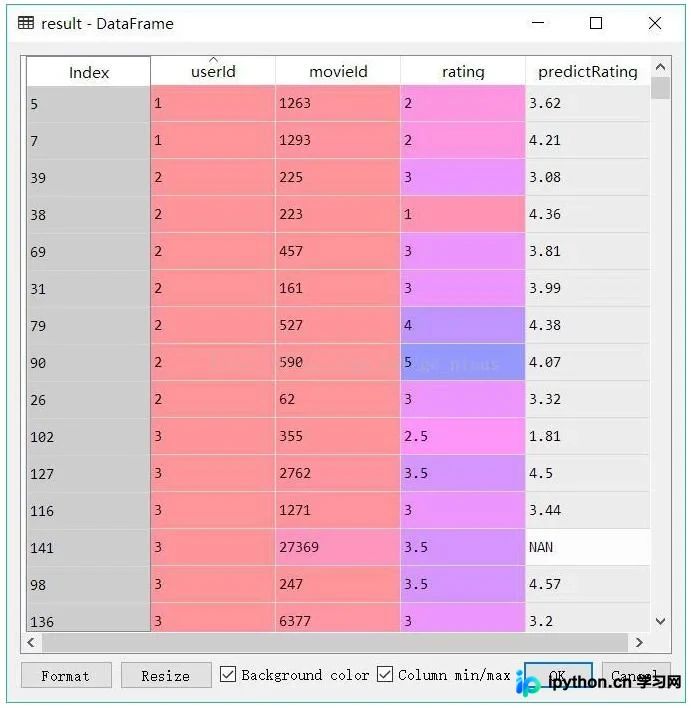
其中,NAN表示该评分在训练集中不存在,即用户未对该物品进行过评分。
以上内容涵盖了基于随机梯度下降的矩阵分解推荐算法的核心逻辑与Python实现,希望对相关学习者有所帮助,欢迎继续支持本站获取更多技术资源。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









