

MySQL超大数据表管理与优化实战
本文探讨MySQL在拥有上亿数据量时,如何通过分区存储、合理建表结构及索引策略来提升查询效率。实验表明,通过调整分区策略(如基于source ID而非主键ID)并采用先导入后建索引的方式,可显著缩短数据装载时间。结合EXPLAIN分析,针对分区字段进行查询限定可将扫描行数大幅降低,使千万级数据查询响应控制在毫秒级。
2026-10-14
6
本文探讨MySQL在拥有上亿数据量时,如何通过分区存储、合理建表结构及索引策略来提升查询效率。实验表明,通过调整分区策略(如基于source ID而非主键ID)并采用先导入后建索引的方式,可显著缩短数据装载时间。结合EXPLAIN分析,针对分区字段进行查询限定可将扫描行数大幅降低,使千万级数据查询响应控制在毫秒级。
本文详细介绍MySQL数据库通过每日定时mysqldump全量备份结合二进制日志(Binlog)增量记录的备份机制。当发生误操作或故障时,可先恢复最新的全量快照,再利用mysqlbinlog工具按时间点精确回放日志,从而最大程度减少数据丢失。该方案提供了从准备到执行的具体步骤及关键参数说明,适用于常规业务场景的数据保护。
当MySQL服务器CPU占用过高时,可通过开启慢查询日志(Slow Log)定位执行时间过长的SQL语句。本文详解如何根据不同版本配置slow_query_log参数,使用mysqldumpslow工具分析日志以找出性能瓶颈,从而通过加索引等方式进行优化。
在PHP开发中,若需对同一MySQL查询结果集进行多次遍历输出,直接再次调用mysql_fetch_array将因内部指针已到达末尾而返回空。本文介绍如何通过调用mysql_data_seek函数将结果集指针重置为第0行,从而实现结果集的多轮次正确读取与展示。
当SQL Server数据库因异常关机或磁盘错误出现“置疑”状态时,可通过紧急模式介入修复。本文介绍利用ALTER DATABASE SET EMERGENCY进入维护模式,配合DBCC CHECKDB REPAIR_ALLOW_DATA_LOSS命令重建索引页并修复逻辑错误的操作路径。若修复失败,则提供通过新建库覆盖文件或DTS导入进行的终极数据抢救方案,旨在最小化数据损失并恢复服务可用性。
本文详述如何修改 MySQL 数据库编码以支持中文。从查看当前字符集变量入手,分别介绍 Linux 下通过 my.cnf 文件全局修改、Windows 下重装或新建库时的设置方法,以及针对已有数据的字段级和会话级编码调整方案,彻底解决乱码问题。
本文深入解析 MySQL DELETE 语法,涵盖单表删除的基本结构与修饰符(LOW_PRIORITY, QUICK, IGNORE),以及基于 JOIN 的多表联合删除技巧。重点说明 AUTO_INCREMENT 处理机制、LIMIT 控制性能、索引优化策略(OPTIMIZE TABLE)及 InnoDB 外键约束下的风险规避,帮助开发者安全高效地执行数据清理任务。
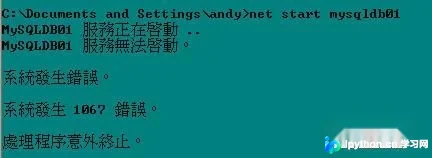
本文介绍在使用MySQL过程中遇到因断电或表结构修改失败导致的1067错误(服务意外停止)时的应急处理方法。通过手动删除日志文件和ibdata1共享表空间文件,强制MySQL重启并重新初始化InnoDB引擎,从而实现数据服务的快速恢复。操作前必须确保已备份.sql数据文件,以防数据丢失。
本文介绍如何在没有Exchange Server的情况下,利用Microsoft Outlook和Internet邮件服务器为SQL Server 2000配置邮件功能。通过配置邮件客户端、重启服务并调用xp_sendmail系统存储过程,实现数据库自动发送电子邮件的功能,适用于Windows 2000及SQL Server 2000环境。
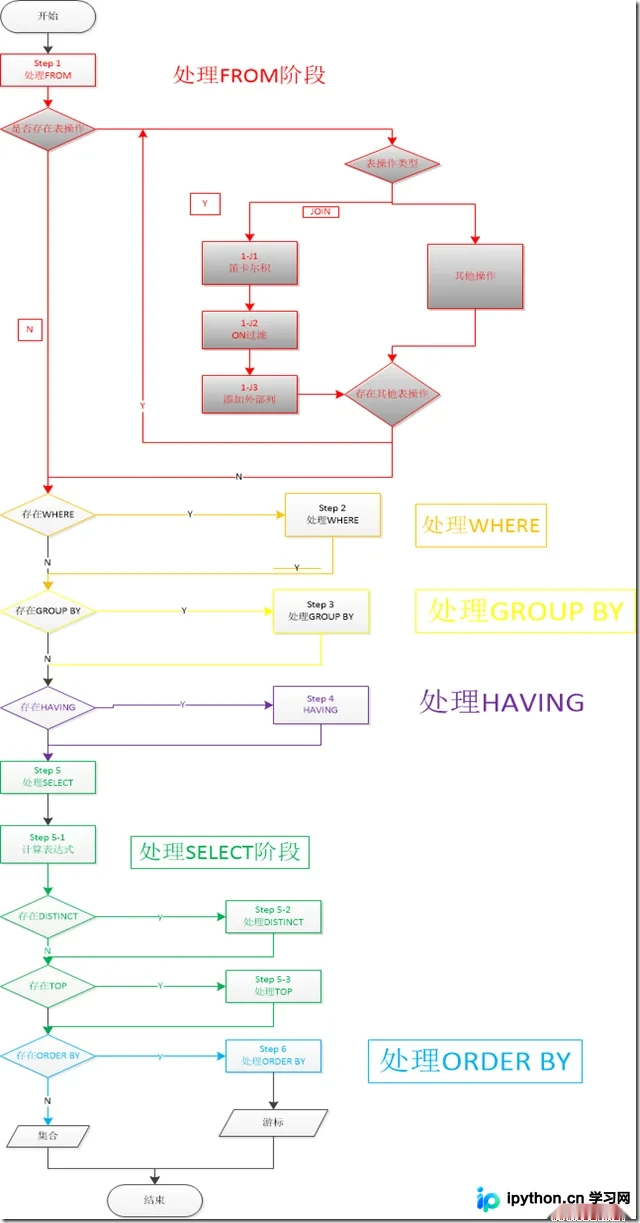
本文深入解析SQL语句的实际执行顺序,揭示其如何按FROM、WHERE、GROUP BY、HAVING、SELECT及ORDER BY的顺序处理数据。通过笛卡尔积、ON过滤、外部行添加等步骤生成中间虚拟表(VT1-VT6),厘清了ON与WHERE的区别以及为何聚合函数只能在特定阶段使用。
在使用SQL Server时,默认“生成脚本”功能往往只导出表结构。若要同时备份数据和架构,需在生成脚本向导中点击“高级”选项,将“要编写脚本的数据的类型”设置为“架构和数据”,即可生成包含完整数据的独立SQL文件。
本文详细解析SQL Server中CONVERT函数的日期时间格式化方法。通过对比不同style参数(如120、112、101等),提供从标准长日期到紧凑年月日及纯时间字符串的代码示例,帮助开发者快速获取特定格式的日期输出结果。