


Python Lambda函数核心用法与最佳实践指南
本文详解Python中Lambda匿名函数的语法结构,演示其与内置函数filter、map及Pandas库apply方法的结合使用技巧。通过实际代码对比过滤、映射与批量处理数据的完整流程,并明确不建议将Lambda赋值给变量或包裹已有内置函数的场景,帮助开发者写出更简洁高效的代码。
2026-10-12
7
本文详解Python中Lambda匿名函数的语法结构,演示其与内置函数filter、map及Pandas库apply方法的结合使用技巧。通过实际代码对比过滤、映射与批量处理数据的完整流程,并明确不建议将Lambda赋值给变量或包裹已有内置函数的场景,帮助开发者写出更简洁高效的代码。
在运行Python脚本时,经常需要通过命令行动态传入变量。本文详细介绍三种常用传参方式:基础列表解析(sys.argv)、带短长选项解析(getopt模块)以及通过外部配置文件中转。结合实际仿真计算与浏览器自动化测试场景,给出完整代码示例与参数对比,帮助开发者灵活选择适合项目需求的传参方案。
本文详细解析Python 3内置的七种算术运算符功能与严格优先级规则,深入演示加号与乘号在字符串、列表及元组等序列结构中的拼接合并与重复复制特性,并提供完整可运行代码与预期输出对照,帮助开发者准确掌握基础数学运算与类型转换逻辑。
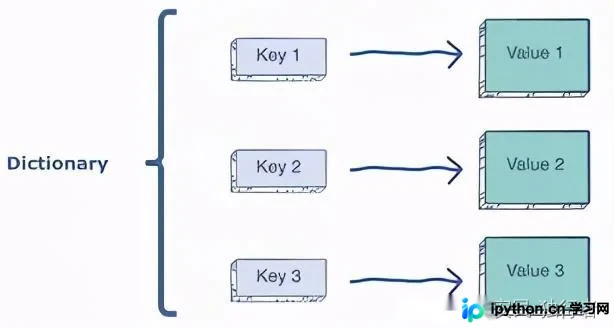
Python字典是存储键值对的可变容器,支持任意数据类型与灵活嵌套。本文系统讲解字典的初始化构造、安全读取技巧、元素动态更新删除、多模式遍历以及防引用污染的复制方法,附带标准代码示例与常见KeyError排查指南,帮助快速掌握核心操作逻辑。
面对频繁的列表处理与轻量级计算需求,手动编写循环与独立函数易导致代码冗余。本文逐一讲解Python3中六个核心内置函数的标准用法:lambda匿名运算、map批量映射、filter条件筛选、reduce序列累积、enumerate索引遍历与zip多维合并,附带可直接运行的代码片段与预期输出,帮助开发者快速掌握数据转换与清洗的最佳实践。
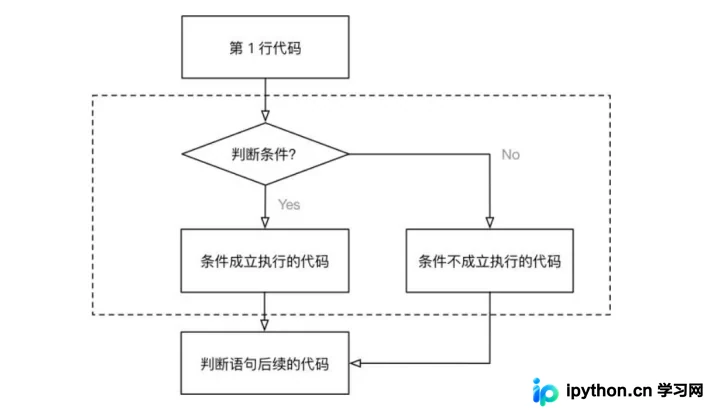
掌握 Python 条件语句的核心在于理解流程控制机制与语法规范。本文详细说明 if、elif 与 else 的执行顺序、独立判断与分支互斥的区别,以及多层嵌套的正确写法。同时补充字符串、列表等对象的真值测试与 None 检查的最佳实践,配合登录验证等实例,帮助开发者编写逻辑清晰且无缩进错误的条件代码。
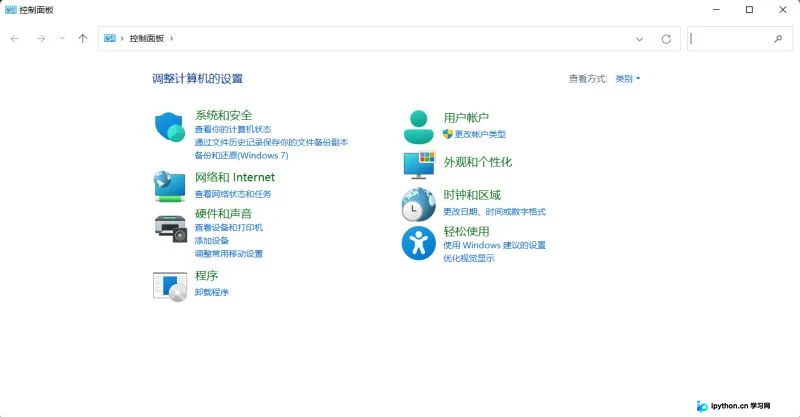
本文详细记录在 Windows 系统中为 Anaconda 配置环境变量的标准流程。通过精准修改系统 Path 参数,解决终端无法识别 conda 指令的问题,并附带路径录入规范、重启终端要求与常见报错排查指南,协助开发者快速完成本地开发环境的初始化。
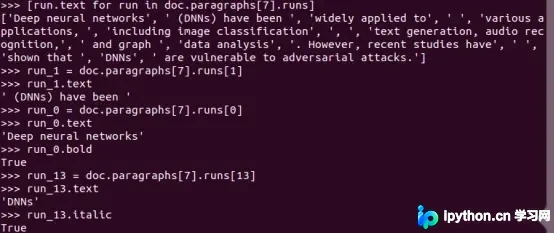
本文详细演示如何使用 Python 的 python-docx 库加载 .docx 文件,通过 core_properties 获取作者与创建日期等元数据,遍历 paragraphs 过滤空行并提取纯文本,同时利用 runs 属性精准判断粗体与斜体样式。全程提供可运行的代码示例,适用于自动化文档解析与内容抓取场景。
本文详细介绍使用 Python 的 pandas 库进行 CSV 与 Excel 文件的读取及保存方法,系统讲解空值筛选、行列删除、索引重置与缺失统计等核心清洗操作。通过明确关键参数设置与标准化代码示例,协助开发者高效完成数据预处理与质量校验流程,确保分析基础稳定可靠。
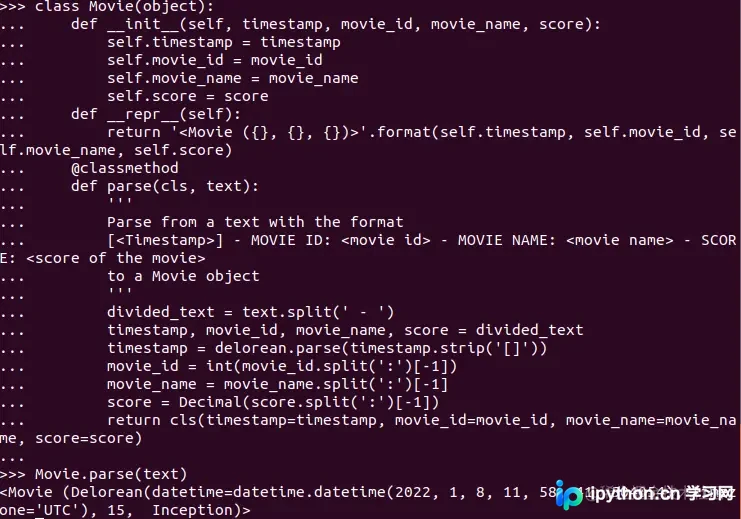
本文演示如何使用 Python 将固定格式的结构化文本逐段拆分,并将其中的时间戳、ID 及评分等字段自动转换为对应的数据类型。通过封装自定义类与 parse 方法,实现一键解析与对象化存储,为后续的数据分析与批量处理提供标准化输入。
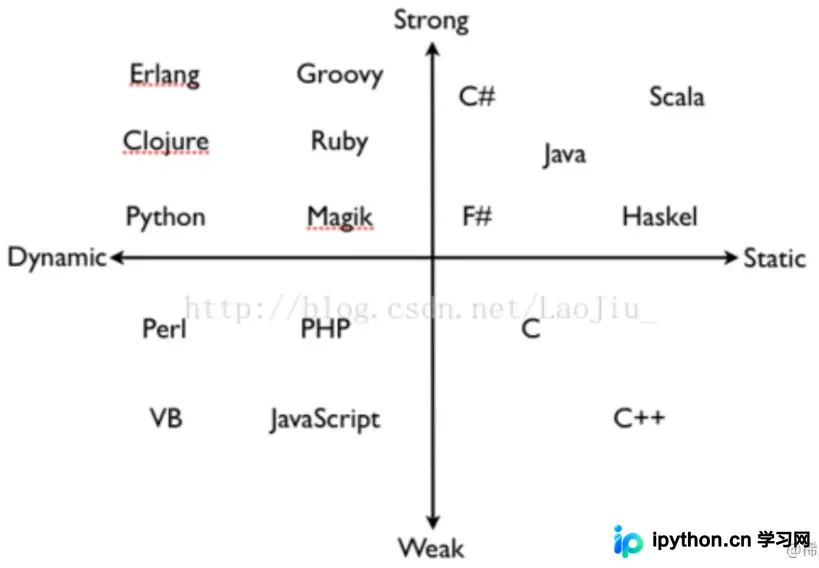
本文详细解析Python的变量引用原理、不可变与可变类型的区别,以及动态强类型语言的特性。通过代码示例梳理数值、字符串、集合等标准类型的内存行为,并说明None对象与各类内建对象的布尔值判定规则,帮助开发者准确掌握Python数据模型的基础逻辑。
本文演示如何利用 Python 的 Pandas 库快速对 Excel 数据表中的手机号进行中间四位隐藏处理。通过指定读取类型并运用字符串切片技术,可一行代码完成批量脱敏,兼顾执行效率与数据隐私安全,适用于跨系统对接前的合规数据清洗。