

Python日志记录进阶:从logging到loguru的优雅实践
本文深入解析Python中两种主流的日志记录方案。首先剖析标准logging模块的配置繁琐痛点,展示如何封装以支持多端输出;随后重点介绍loguru库,通过简洁API实现文件轮转、保留策略、压缩及异常追踪等高级功能,帮助开发者构建更优雅、高效的日志系统。
2026-10-15
0
本文深入解析Python中两种主流的日志记录方案。首先剖析标准logging模块的配置繁琐痛点,展示如何封装以支持多端输出;随后重点介绍loguru库,通过简洁API实现文件轮转、保留策略、压缩及异常追踪等高级功能,帮助开发者构建更优雅、高效的日志系统。
本文深入解析C语言中数据的底层存储机制。首先梳理C语言的基本数据类型分类,重点阐述整数在内存中以补码形式存储的原因及原码、反码、补码的转换规则。其次解释大端与小端存储模式的差异及其判断方法。最后基于IEEE 754标准,详细拆解float和double类型在内存中的符号位、指数位及有效数字位的排列规则,包括特殊值(如0、无穷大)的处理逻辑,帮助开发者理解类型转换背后的二进制真相。
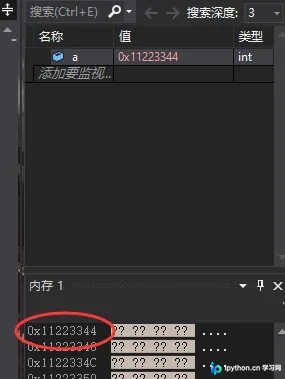
本文深入解析C++对象在内存中的实际占用空间。通过32位Linux环境下的实测代码,揭示了数组名与指针的sizeof差异、空类占1字节的原因、成员函数的零额外开销、静态变量的独立存储、虚函数引入的4字节vptr,以及继承关系中的内存累积规则,帮助开发者精准掌握C++内存布局。
本文解析C语言标准库中的qsort函数,详细讲解其头文件引入、四个核心参数(基地址、数量、宽度、比较器)及返回值含义。通过整形数组与结构体多维度排序的实例,展示回调函数的灵活应用,并深入对比冒泡排序剖析qsort基于字节交换的通用排序实现逻辑。
本文深入解析C语言中数据在内存的存储机制。通过讲解指针与地址,揭示整数采用补码存储的原因;基于IEEE 754标准剖析浮点数的符号位、指数偏移及有效数字隐藏位规则;并通过代码实例演示如何判断系统的大小端存储模式,帮助理解整形提升、类型强转等底层原理。
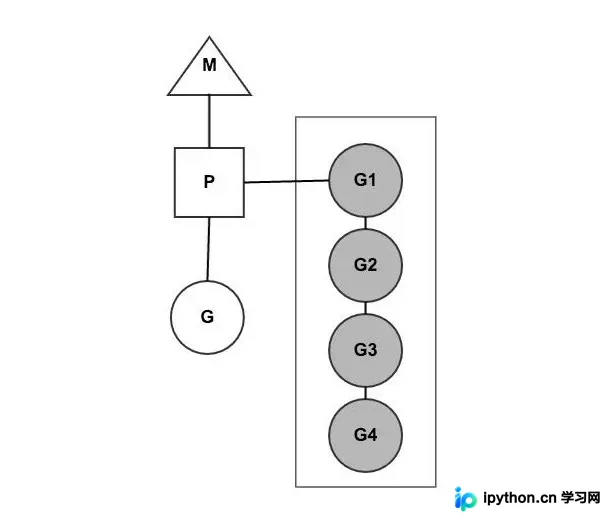
本文深入剖析 Go 语言基于 CSP(通信顺序进程)模型的并发机制,详细解释 Channel 的同步与消息传递方式,以及 Goroutine 的实际运行特性。同时揭示 M-P-G 调度器的底层工作原理,帮助用户理解 Golang 如何实现高效的轻量级并发处理。
本文解析 MySQL 中 COUNT(*)、COUNT(1) 和 COUNT(字段) 的性能差异。通过实验证明在 InnoDB 引擎下,COUNT(*) 与 COUNT(1) 效率几乎一致且最优,因为它们均会选择最小的辅助索引进行全表扫描计数;而 COUNT(主键字段) 需额外回表或判断 NULL 值,速度略慢。同时说明了 information_schema.TABLES_ROWS 仅作为估算值不可靠,并指出 InnoDB 基于 MVCC 无法像 MyISAM 那样直接存储行数。
本文详解Go语言中结构体的内存布局原理,通过TerraformResource实例展示未对齐导致88字节内存浪费的问题。深入解析字节对齐规则、填充字节计算及CPU字读取机制,演示将字段按大小降序排列后,总占用降至72字节且减少CPU读取周期。掌握这一技巧可有效提升Golang应用的性能与资源利用率。
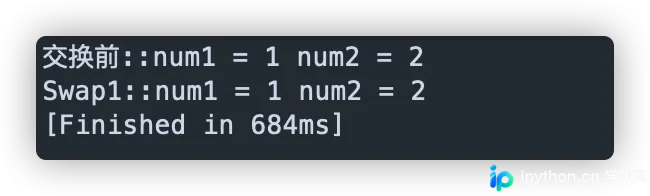
本文详解C语言中值传递与地址传递的本质区别。通过对比求最大值(无需修改实参)与交换两数内容(需修改实参)的实例,揭示形参仅为实参拷贝导致值传递失效的原因。掌握使用指针进行地址传递的正确方法,确保在需要改变外部变量状态时操作生效。
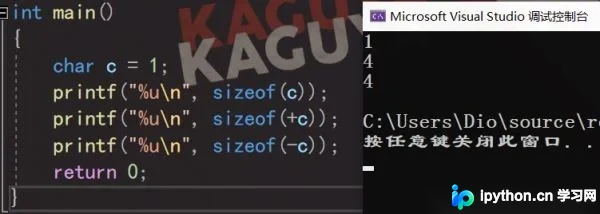
深入解析C语言中结构体的访问方式(.与->),重点阐述表达式求值中的隐式类型转换规则,包括整型提升的符号位处理机制及算术转换原则,同时结合操作符优先级与结合性,避免多路副作用带来的未定义行为。
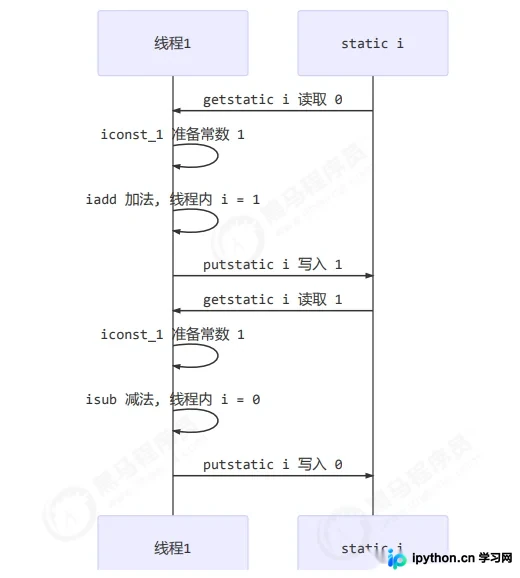
Java并发编程中,原子性、可见性和有序性是确保线程安全的三大基石。原子性指操作不可中断;可见性涉及JMM主存与工作内存的同步,可通过volatile解决;有序性则关乎指令重排序带来的隐患。本文深入解析这三大特性的原理及潜在问题,帮助开发者构建正确的多线程应用。
本文深入解析C语言printf函数的输出格式,涵盖转换说明(如%d、%f)、长度修饰符(h、l、z)及精度控制。通过具体代码示例,展示如何灵活使用对齐、宽度和填充标志来定制控制台输出,帮助开发者编写更规范的C语言代码。