Python读取XML节点与属性值实战:解析ElementTree用法
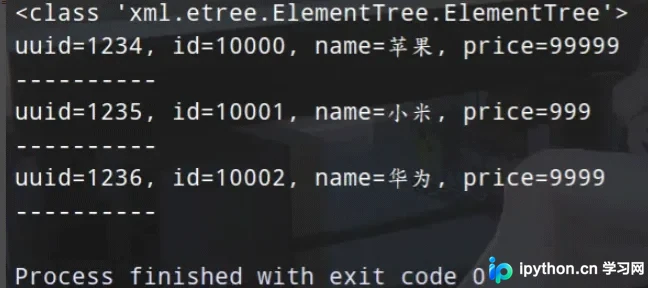
本文通过Python面试题案例,演示如何使用xml.etree.ElementTree模块读取XML文件。重点讲解parse函数加载文档及iterfind方法遍历子节点,结合findtext与get方法获取节点文本及属性值,实现数据的高效提取与分析。
2026-10-15
0
本文通过Python面试题案例,演示如何使用xml.etree.ElementTree模块读取XML文件。重点讲解parse函数加载文档及iterfind方法遍历子节点,结合findtext与get方法获取节点文本及属性值,实现数据的高效提取与分析。
本文介绍Python中控制线程运行时间的两种方法。首先分析使用eventlet库进行超时控制的局限性,指出其无法作用于子程序调用的问题。接着详细演示func-timeout库的安装与使用,通过@func_set_timeout修饰器实现函数级别的超时控制,并结合try-except处理超时异常,确保程序稳定性。
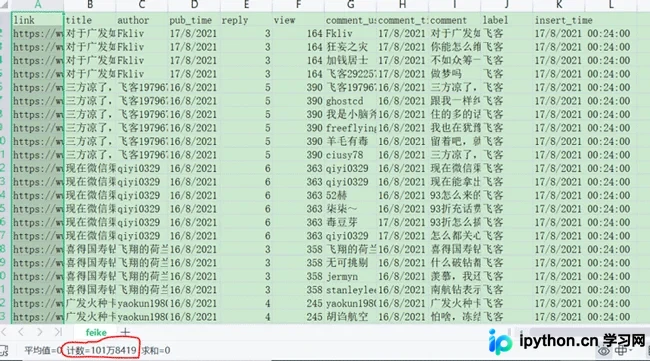
本文介绍如何使用pandarallel库实现Pandas数据的多进程并行处理,以显著提升数据清洗速度。通过对比单进程与多进程在处理100万条数据时的耗时,展示pandarallel在apply、map等操作中的加速效果,并附带完整代码示例。
在C# WinForm开发中,System.Windows.Forms.Timer无法在新线程直接使用。解决此问题需改用System.Timers.Timer配合System.Threading.Thread。针对Timer.Stop()无效的问题,需在Elapsed事件处理函数内部先执行Stop操作完成业务逻辑后再重新启动。
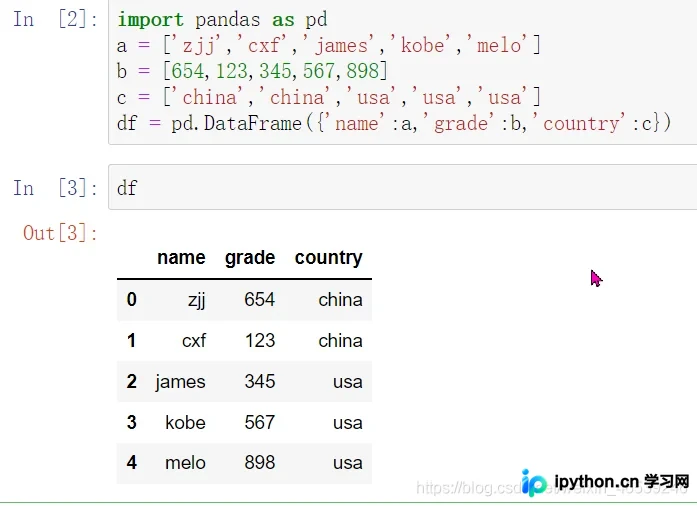
本文详细总结了Python Pandas库中增加行列数据的多种常用方法。内容涵盖使用直接赋值、eval计算、insert函数插入指定列,以及利用loc、iloc、append和concat处理行数据。此外,还介绍了通过apply函数结合自定义逻辑新增衍生列的技巧,适用于数据清洗与特征工程场景。
本文详细介绍Python中文件读取与写入的核心方法。通过open函数指定路径获取文件对象,演示了读取文本内容及使用追加模式写入数据而不覆盖原内容。此外,还讲解了利用json模块进行结构化数据存储与读取的操作,并提供了循环保存与读取多个文件的完整代码示例,帮助开发者掌握基础文件IO技能。
本文系统介绍Python中os.path模块的核心功能,涵盖路径转换、文件属性查询及路径拼接等常用方法。通过具体代码示例,详细解析abspath、dirname、basename、exists、getmtime等函数的用法与注意事项,帮助开发者高效处理文件路径相关操作。
本文详细解析Python中模块的三种主要分类:系统内置模块、开源第三方模块以及自定义模块。通过介绍os、requests、django等常见库的功能,帮助开发者理解如何有效引用和管理不同来源的代码模块,同时强调自定义模块命名需避免与内置模块冲突的注意事项。
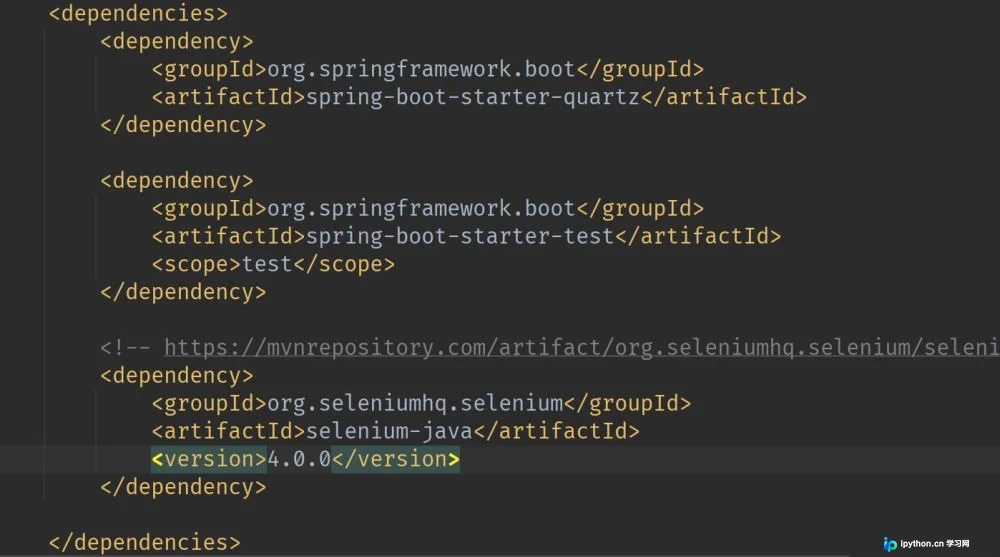
在Spring Boot项目中使用Selenium 4.0时,常因Spring Boot BOM默认引入旧版Selenium(如3.141.59)导致NoClassDefFoundError异常。本文将分析Maven依赖覆盖机制,并提供通过明确指定dependenciesManagement或排除传递性依赖来解决此问题的具体方法,确保程序正常运行。
本文详解Python中使用正则表达式re.sub匹配或替换反斜杠\\时的转义问题。由于正则语法与Python字符串解析器的双重转义机制,直接写入单个反斜杠会导致语法错误。文章通过对比分析,解释了为何需要四个反斜杠(\\\\)或使用原始字符串(r'\\')来正确匹配单个反斜杠,并提供了str.replace()作为替代方案。

本文详解Python requests库中post方法的data与json参数区别。data默认进行URL编码,Content-Type为application/x-www-form-urlencoded;json参数自动序列化字典并设置Content-Type为application/json。通过代码示例对比两种传参方式对请求头及数据格式的影响,帮助开发者正确选择参数。
本文介绍Python中正则表达式的基础概念,包括原子、元字符及模式修正符。重点讲解如何实现字符串的重叠匹配,并详细解析re模块中search、match、compile、findall及sub等常用函数的用法与参数,帮助开发者高效进行文本提取与清洗。