Pandas计算相关性系数corr()方法详解与参数对比
本文详细介绍Pandas中计算相关性系数的corr()方法。涵盖相关性的定义、正负相关判断及系数范围[-1,1]。重点解析method参数的三种选项:pearson(线性)、kendall(分类/无序)和spearman(非线性),并通过一元二次方程示例对比各系数在非线性数据下的表现差异,强调相关性与因果性的区别。
2026-10-15
0
本文详细介绍Pandas中计算相关性系数的corr()方法。涵盖相关性的定义、正负相关判断及系数范围[-1,1]。重点解析method参数的三种选项:pearson(线性)、kendall(分类/无序)和spearman(非线性),并通过一元二次方程示例对比各系数在非线性数据下的表现差异,强调相关性与因果性的区别。
本文详细介绍pytest框架中@pytest.mark.parametrize()装饰器的核心用法。通过单参数多值、多参数组合、字典数据传入等实例,展示如何实现测试用例的参数化,提升测试覆盖率与代码复用性。
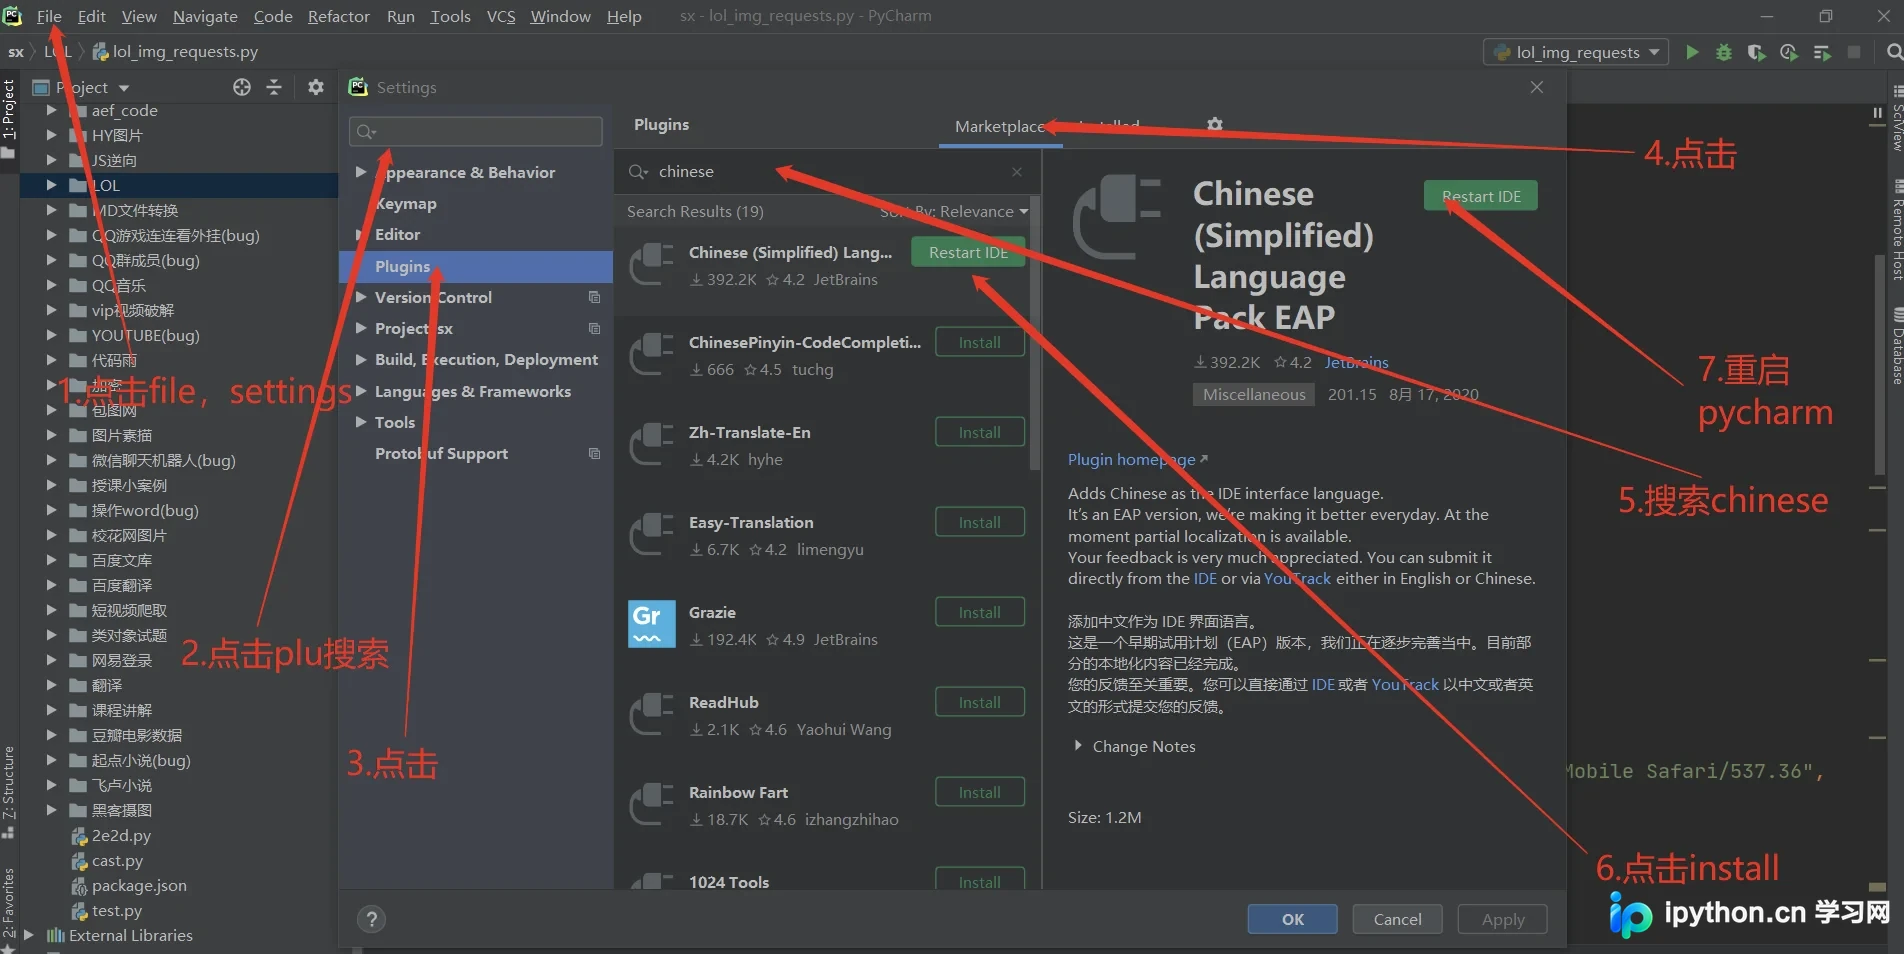
本文详细介绍在 PyCharm 2020.3 版本中安装中文语言包及解除汉化的具体步骤。通过 Settings 中的 Marketplace 搜索并安装 Chinese Language Pack,重启即可切换为中文界面;如需恢复英文,同样在插件管理中禁用该插件并重启即可。
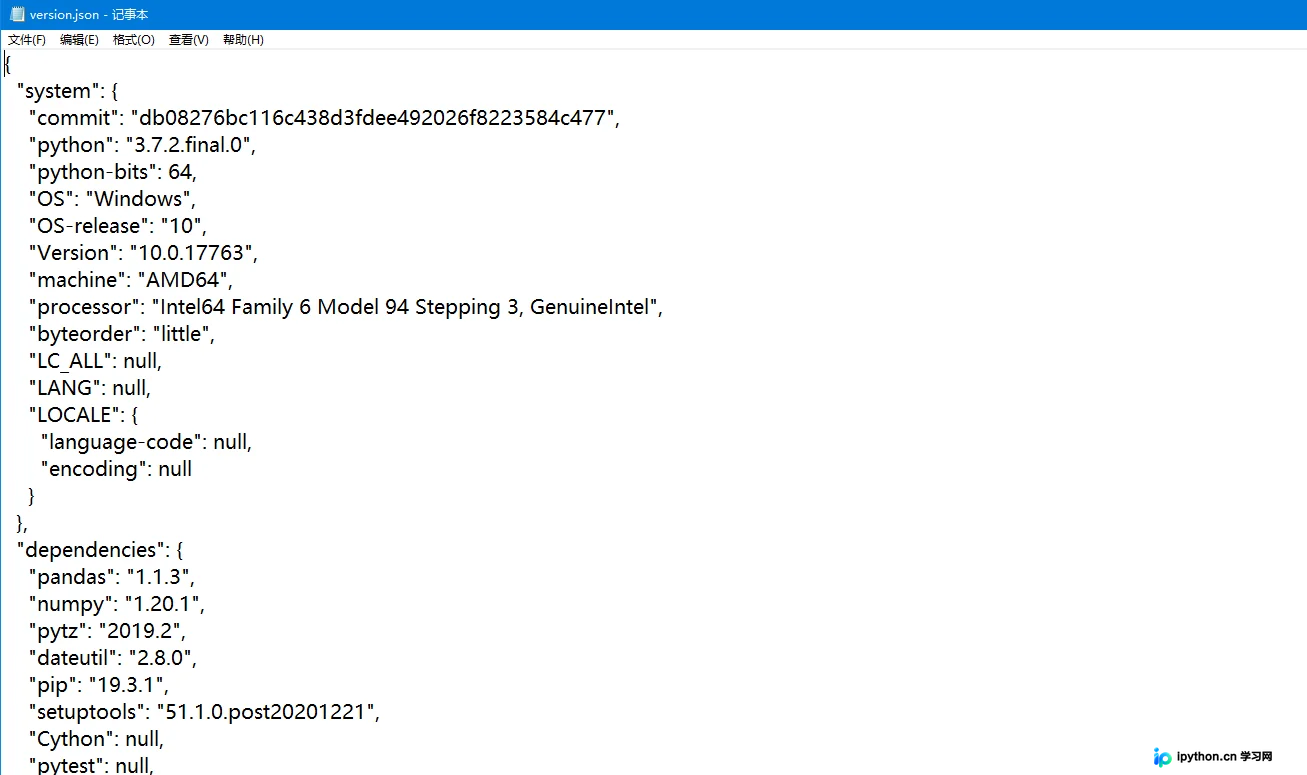
本文深入解析pandas中查看库版本及依赖信息的四个核心API:__version__、__git_version__、_version.get_versions()及show_versions()。通过剖析pandas._version模块与__init__.py源码,阐明版本信息的存储机制、命名空间重构过程及show_versions()在不同参数下的输出逻辑,帮助开发者理解版本检查背后的实现原理。
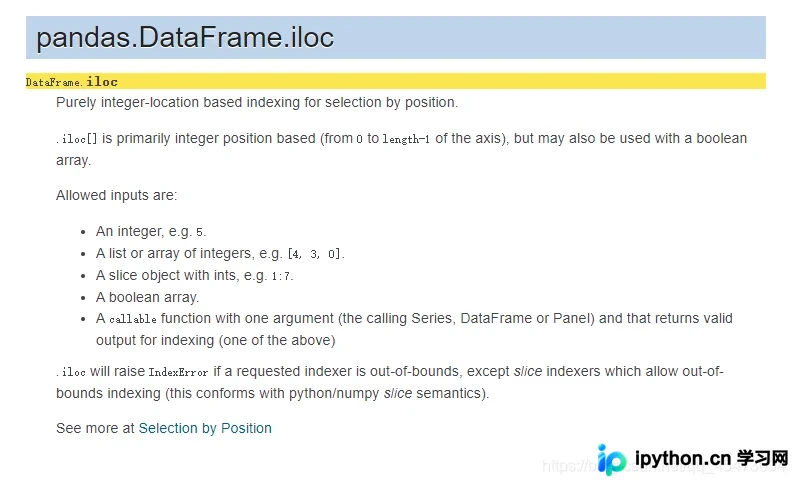
本文详细解析pandas中DataFrame.iloc方法的五种索引方式,包括整数索引、列表索引、切片索引、布尔数组索引及可调用函数索引。通过具体代码示例演示如何精准提取行、列及子集数据,帮助开发者掌握高效的数据筛选技巧。
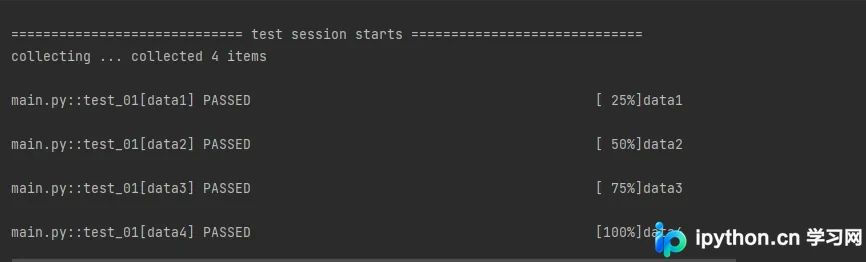
本文深入解析pytest中fixtures的teardown机制,详细对比yield和addfinalizer两种实现方式。通过具体代码示例展示yield fixtures的执行顺序及addfinalizer注册多个终结器的用法,并探讨两者在异常处理上的差异,帮助开发者编写更健壮的测试清理代码。
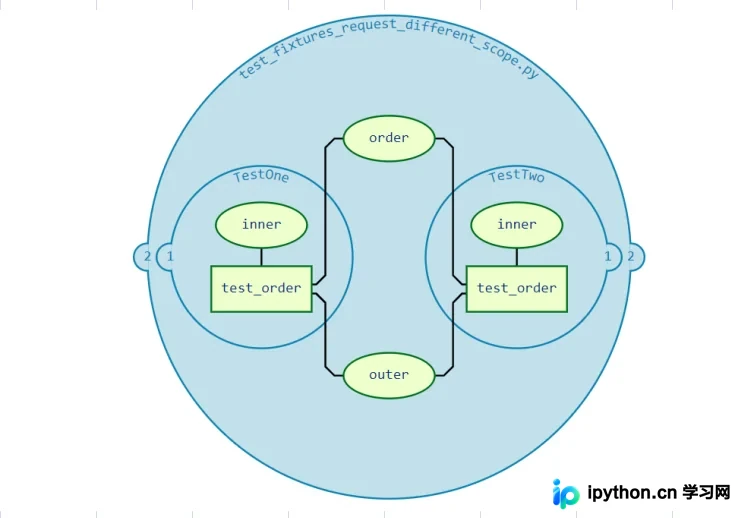
本文详细解析pytest中fixture的作用范围与请求机制,说明fixture仅在定义范围内有效,但可通过依赖链跨类访问。重点介绍利用conftest.py实现跨文件共享fixture的最佳实践,包括目录层级下的搜索规则与边界限制,帮助开发者构建可复用的测试基础设施。
本文详细介绍pandas中实现数据合并的四种核心方法:concat、merge、join和append。重点解析concat函数的axis、join、ignore_index等参数,merge的on、how、suffixes配置,以及join与merge在连接轴和数量上的差异,配合代码示例帮助快速掌握数据合并技巧。
本文探讨NumPy中强制类型转换的机制,重点分析整数数组赋值浮点数时的隐式截断风险。通过示例演示如何正确使用dtype查看类型,并利用astype方法进行显式类型转换,包括浮点转整数及字符串数组转数值型,帮助开发者避免数据精度丢失问题。
本文汇总了13个提升Pandas数据分析效率的实用技巧,涵盖计算变量缺失率、获取分组最大值所在行、多列合并、特定字符串行删除、组内排序、类型列选择、字符串转数值、内存占用优化、最大类别筛选、字符串分割、列表转DataFrame、多函数聚合及字典分组等核心场景,帮助开发者更高效地处理数据。
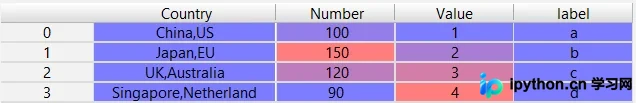
本文详解如何使用pandas将单行数据按分隔符拆分为多行,涵盖单列与多列拆分场景。同时介绍两种将多行数据合并回单行的方法,包括使用stack/join与explode结合groupby的方式,提供完整代码示例与效果展示。
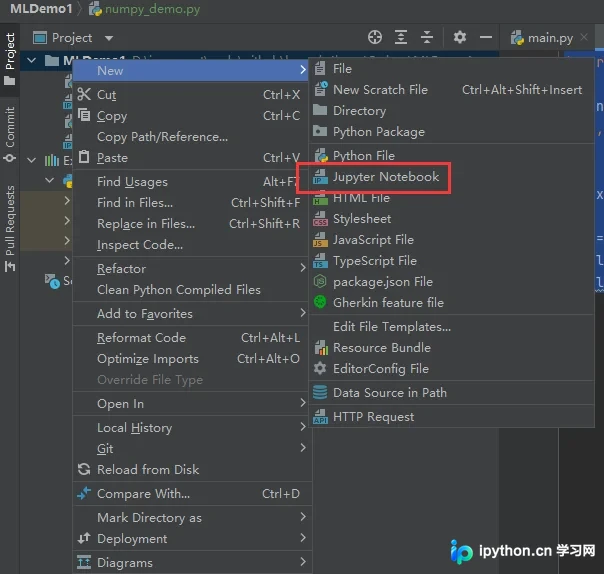
本文详细介绍如何在PyCharm中配置远程Jupyter Notebook环境。通过创建.ipynb文件并配置远程服务器URL与Token,可解决CreateProcess失败等常见报错。文章还分享了密钥拼接注意事项、后台启动命令及无Token模式的备用方案,帮助开发者高效搭建远程Python开发环境。