Python Pandas query函数详解:从基础筛选到多条件复杂查询
本文深入解析Python Pandas库中query函数的核心用法。涵盖基础值匹配、数学表达式运算、变量引用(@符号)、列表包含(in)及多条件逻辑组合(&和|)。通过具体代码示例展示如何处理含空格列名及筛选后列选取,帮助开发者实现更简洁高效的数据过滤操作。
2026-10-16
0
本文深入解析Python Pandas库中query函数的核心用法。涵盖基础值匹配、数学表达式运算、变量引用(@符号)、列表包含(in)及多条件逻辑组合(&和|)。通过具体代码示例展示如何处理含空格列名及筛选后列选取,帮助开发者实现更简洁高效的数据过滤操作。
本文详解Python中numpy.core.fromnumeric模块下的shape()函数,用于读取矩阵长度与维度信息。通过解析输入参数为一维或二维矩阵时的返回值,以及利用shape[0]和shape[1]分别获取行数和列数的具体操作,帮助开发者掌握数组维度的判断方法。同时解释了Debug场景中shape(?,2,3)里问号代表的批处理个数含义,为数据分析提供基础支持。
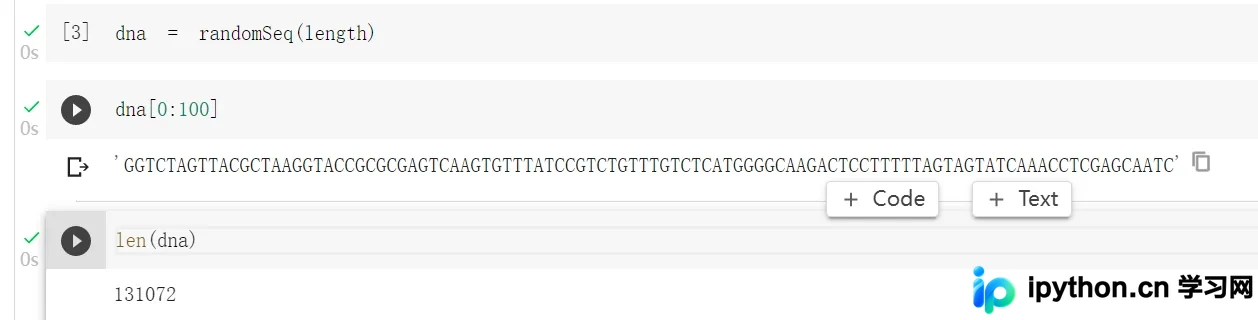
本文介绍使用Python将DNA碱基序列转换为One-Hot编码矩阵,并存储为TensorFlow专用的TFRecord格式文件的全过程。内容涵盖随机序列生成、自定义编码函数实现、字节流转换、Example构建以及数据读取与解析方法,适用于生物信息学深度学习模型训练前的数据预处理环节。
本文详解利用Python进行PDF文件自动化处理的方法。通过PyPDF2库实现PDF文件的批量合并与按页拆分,结合加密功能保护文档安全。此外,介绍使用ReportLab生成水印文件并批量添加至PDF的技术细节,提供完整代码示例与效果展示,适用于办公自动化场景。
本文详解Python中使用正则表达式re.sub匹配或替换反斜杠\\时的转义问题。由于正则语法与Python字符串解析器的双重转义机制,直接写入单个反斜杠会导致语法错误。文章通过对比分析,解释了为何需要四个反斜杠(\\\\)或使用原始字符串(r'\\')来正确匹配单个反斜杠,并提供了str.replace()作为替代方案。

本文介绍如何使用Python数值求解形如[[wp:a0]]的微分方程。详细解析了欧拉法、隐式欧拉法、三阶及四阶Runge-Kutta法的实现原理与代码逻辑,并通过具体案例对比各算法的计算结果,为数值分析提供实用的编程参考。

本文详解Python中python-dotenv库的使用,介绍如何通过.env文件安全隔离数据库密码等敏感配置,避免硬编码风险。重点解析load_dotenv函数的override参数及路径指定方法,结合Flask官方推荐实践,帮助开发者实现代码与配置的分离管理。
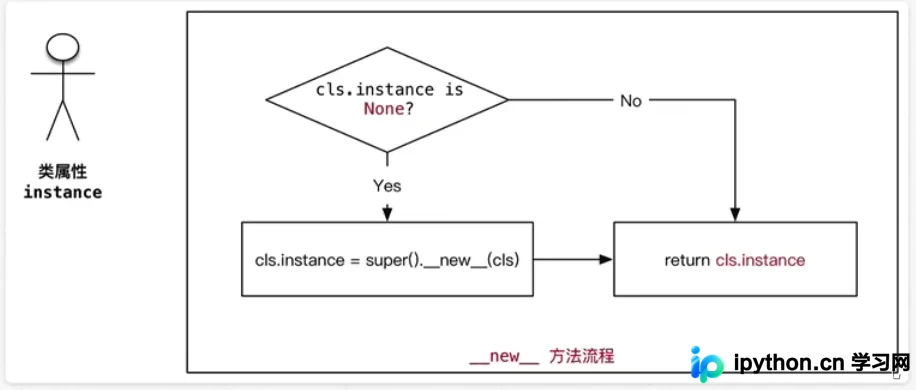
本文详细介绍 Python 中单例模式的两种核心实现方式。首先通过重写 __new__ 方法确保类仅创建唯一实例,解决对象引用问题;随后针对初始化方法重复调用的痛点,引入类属性标记机制,实现初始化逻辑仅执行一次。文章包含完整代码示例,帮助开发者掌握高效、安全的单例模式编写技巧。
本文介绍如何使用 Python 和 OpenCV 库,从 LabelMe 等工具生成的 JSON 标注文件中提取矩形坐标,并将其绘制回原始图像。通过遍历文件夹获取文件列表,解析 JSON 中的 shapes 节点获取左上角和右下角坐标,利用 cv2.rectangle 函数在图像上画出对应边框,最终保存处理后的图像。
本文详解如何在Python、C/C++、Java、JavaScript等语言中用一行代码交换两个变量。重点分析C/C++中异或链式的未定义行为风险及序列点修正,Java中求值顺序导致的错误结果及正确写法,以及Python和JavaScript的简洁语法。
本文详细介绍Python中实现列表倒序的三种常用方法:切片、reverse()方法和reversed()函数。切片通过mylist[start:end:step]语法实现,不改变原列表;reverse()方法直接在原列表上操作并返回None;reversed()返回迭代器,同样不修改原列表。文章通过具体代码示例对比了各方法的行为差异及适用场景。
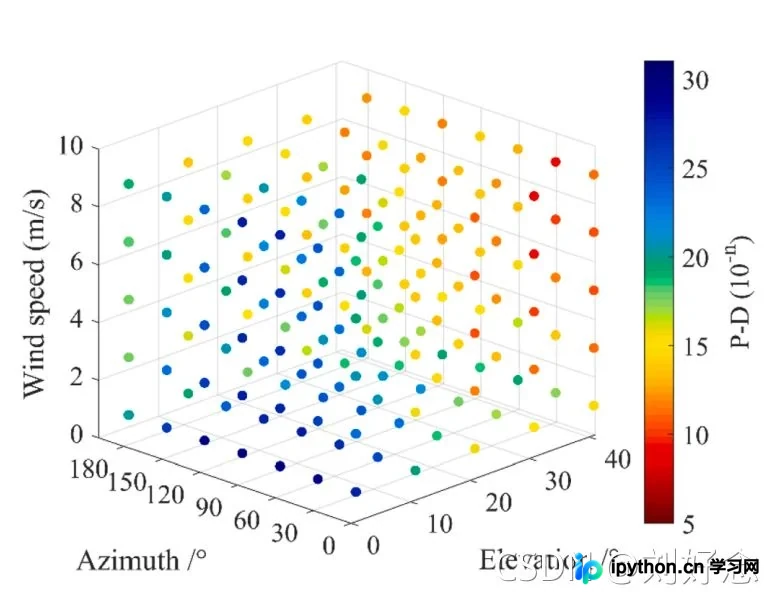
本文介绍如何利用Python的matplotlib库绘制三维散点图,并通过颜色映射(Colormap)直观展示三元函数f(x,y,z)=v的数据分布。文章详细讲解了如何配置颜色等级、自定义侧边Colorbar的数值范围及显示格式,并提供了完整的代码实现与关键参数解析,帮助开发者实现更精细的数据可视化效果。