

Python装饰器原理深度解析:从闭包到函数执行流程

发布时间:2026-10-13| 2人浏览过
本文深入解析Python装饰器的底层原理,通过对比常规嵌套函数与装饰器语法,阐明其本质是返回函数地址的高阶函数调用。文章详细拆解了参数传递、闭包捕获及执行时序,帮助开发者摆脱对装饰器调用方式的迷茫,掌握利用装饰器优化代码的核心技巧。
此前虽已接触装饰器概念,但仅停留在表面认知,对其具体调用逻辑也常感困惑。鉴于当前项目存在优化需求,决定采用装饰器方案,因此对这一机制进行了系统性深入研究。
首先观察以下代码示例:
import time


# 将函数作为参数传入到此方法....
def timeif(func):
  def wrapper(arg):
    print("in wrapper() %s" % (arg))
    start = time.clock()
    func(arg)
    end = time.clock()
    print("used: %s %s" % (end-start, arg))
  return wrapper


@timeif
def foo(arg):
  print("in foo() %s" % (arg))


if __name__ == '__main__':
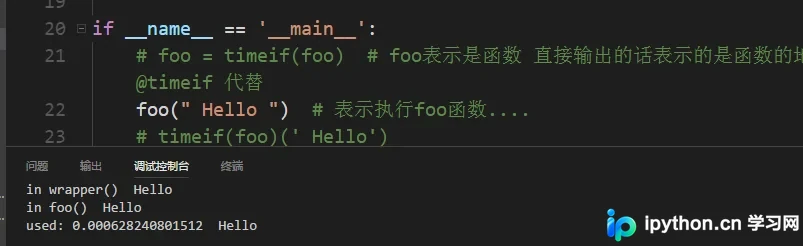
  foo(" Hello ") # 表示执行foo函数....
我的核心疑问在于:既然return语句返回的是函数名,按逻辑这应等同于返回函数的内存地址,我的理解是否存在偏差?为此查阅资料发现多涉及“闭包”概念,但我个人对此概念接受度不高。于是通过独立分析与代码重构,总结出以下程序,阅读后即可明晰其运作原因。 程序示例:
# coding=utf-8
# 带参数的函数 返回一个函数地址就行....
def funX(x):
  def funY():
    return x
  return funY


# 不带参数的函数....
def funX1():
  print("调用函数funX1")

  def funY1():
    print("调用函数funY1")
  return funY1


if __name__ == '__main__':
  # print(funX(5)()) # 调用有参数的嵌套函数...

  print(funX1()()) # 调用无参数的嵌套函数...
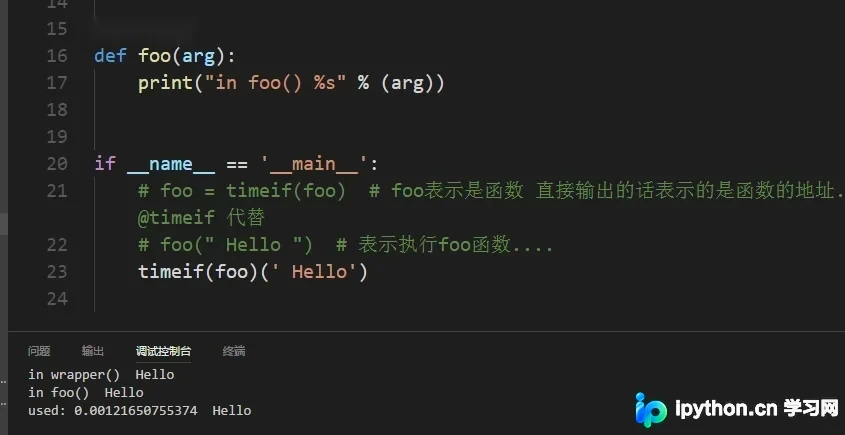
这段代码与标准装饰器结构是否高度相似?实际上,它正是装饰器的本质体现。据此可推断,装饰器的执行逻辑是首先确定参数数量,随后依次传入。基于此理解,我们对代码进行改写:
# coding=utf-8
import time


# 将函数作为参数传入到此方法....
def timeif(func):
  def wrapper(arg):
    print("in wrapper() %s" % (arg))
    start = time.clock()
    func(arg)
    end = time.clock()
    print("used: %s %s" % (end-start, arg))
  return wrapper


# @timeif
def foo(arg):
  print("in foo() %s" % (arg))


if __name__ == '__main__':
  timeif(foo)(' Hello')
以上内容即为本文核心总结,希望能对各位的学习有所助益,同时也欢迎大家继续支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









