


先理解 C++ 数组的基本特性
在讨论“数组如何作为参数传递”之前,先要明确 C++ 数组本身的几个关键特征。原生数组适合存放固定大小、类型一致的数据,而且元素在内存中是连续排布的,这也是它访问效率高的原因之一。
数组的声明与初始化
C++ 中常见的数组声明方式如下:
// 基本数组声明
int numbers[5];  // 包含 5 个整数的未初始化数组

// 数组初始化
int scores[3] = {85, 90, 92};  // 初始化数组

// 自动推断大小
int values[] = {10, 20, 30, 40};  // 大小自动确定
这里要注意,未初始化的局部数组可能包含不确定值。只要不是刻意追求极限性能,实际开发中通常都应该在声明时完成初始化。
为什么数组访问快:连续内存布局
数组元素存放在一段连续内存中,索引从 0 开始。也就是说,访问 arr[i] 本质上是在基地址上做偏移计算,这让数组具备了非常直接的访问成本。
它的几个核心特点可以概括为:
| 特性 | 描述 |
|---|---|
| 固定大小 | 数组具有预先确定的大小 |
| 从零开始计数 | 第一个元素的索引是 0 |
| 连续内存 | 元素存放在相邻的内存位置 |
| 类型一致性 | 所有元素必须是相同类型 |
连续内存带来性能优势,也带来限制:原生数组大小固定,且默认没有自动边界检查。
数组的访问、修改与遍历
int grades[5] = {75, 80, 85, 90, 95};

// 访问元素
int firstGrade = grades[0];  // 75
int thirdGrade = grades[2];  // 85

// 修改元素
grades[1] = 82;
遍历数组时,可以使用传统 for 循环,也可以使用 C++11 的范围 for:
int temperatures[5] = {22, 25, 27, 23, 26};

// 使用传统for循环
for (int i = 0; i < 5; i++) {
    std::cout << temperatures[i] << " ";
}

// 使用基于范围的 for 循环(C++11)
for (int temp : temperatures) {
    std::cout << temp << " ";
}
原生数组最常见的问题
- 没有自动边界检查
- 存在缓冲区溢出风险
- 大小固定,不适合动态扩缩容
因此,很多项目会优先考虑 std::array 或 std::vector,只有在必须直接使用原生数组时才回到这种写法。
函数里传数组,C++ 到底是怎么处理的
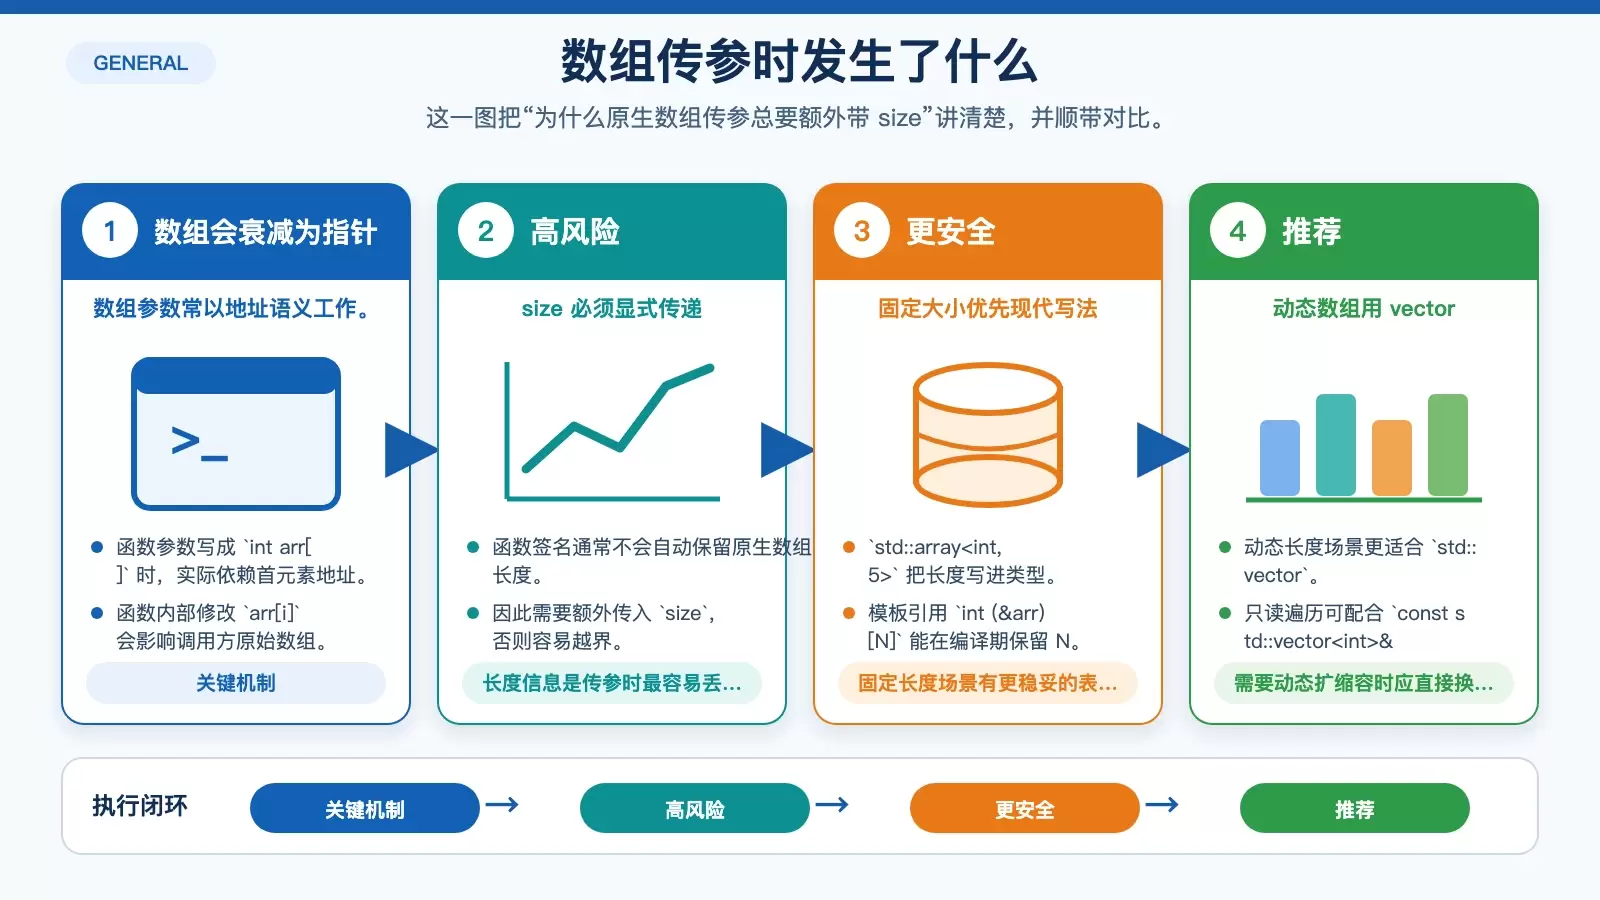
数组参数传递最容易让人误解的地方在于:你以为传的是“整个数组”,但函数接收时往往已经退化成了地址语义。理解这一点,才能判断函数里修改元素是否会影响原始数据,以及为什么大小信息经常会丢失。
最常见的两种写法:数组参数和指针参数
// 方法 1:按引用传递数组
void processArray(int arr[], int size) {
    for (int i = 0; i < size; i++) {
        arr[i] *= 2;  // 修改原始数组
    }
}

// 方法 2:传递数组指针
void modifyArray(int* arr, int size) {
    for (int i = 0; i < size; i++) {
        arr[i] += 10;
    }
}
这两种形式在函数参数里都能够操作原始数组内容,本质上都依赖数组首元素地址。也正因为如此,函数内部修改 arr[i] 会直接作用到调用方的数据。
几种参数传递策略该怎么选
| 策略 | 描述 | 内存影响 |
|---|---|---|
| 按引用 | 直接内存访问 | 开销低 |
| 按指针 | 传递内存地址 | 复制最少 |
| 按值 | 不建议用于数组 | 内存成本高 |
实际使用时,原生数组几乎都要额外传一个 size 参数,因为函数签名里通常无法自动保留长度信息。
为什么总要手动传 size:数组会衰减为指针
原文提到的几个典型挑战,本质都来自数组到指针的隐式衰减:
- 隐式的数组到指针的衰减
- 大小信息丢失
- 潜在的缓冲区溢出
这也是很多 C++ 初学者容易踩坑的地方:函数参数里写成 int arr[] 看起来像数组,实际行为却更接近指针。因此,除非上下文明确,否则始终显式传入数组大小是最稳妥的做法。
更现代的方案:`std::array`、模板引用和 `std::vector`
如果希望保留更好的类型信息和边界安全性,可以考虑下面几种现代写法。
// 使用 std::array 实现类型安全的参数
void processStdArray(std::array<int, 5>& arr) {
    // 更安全、更现代的方法
    for (auto& element : arr) {
        element++;
    }
}

// 基于模板的数组处理
template <size_t N>
void genericArrayProcess(int (&arr)[N]) {
    // 编译时确定大小
    for (int i = 0; i < N; i++) {
        arr[i] *= 2;
    }
}
std::array 适合固定长度场景,长度是类型的一部分;模板引用方式则可以在编译期保留原生数组长度。两者都比裸指针或普通数组参数更容易写出安全代码。
如果数组长度需要动态变化,std::vector 往往更合适:
#include <iostream>
#include <vector>

void safeArrayProcess(const std::vector<int>& arr) {
    // 进行边界检查的安全迭代
    for (const auto& element : arr) {
        std::cout << element << " ";
    }
}

int main() {
    std::vector<int> numbers = {1, 2, 3, 4, 5};
    safeArrayProcess(numbers);
    return 0;
}
函数参数的实用建议
- 使用引用或指针
- 始终显式传递数组大小
- 考虑使用
std::array或std::vector - 实现边界检查
- 对只读操作使用
const - 尽量减少不必要的复制
传数组不只是语法问题,还关系到内存与性能
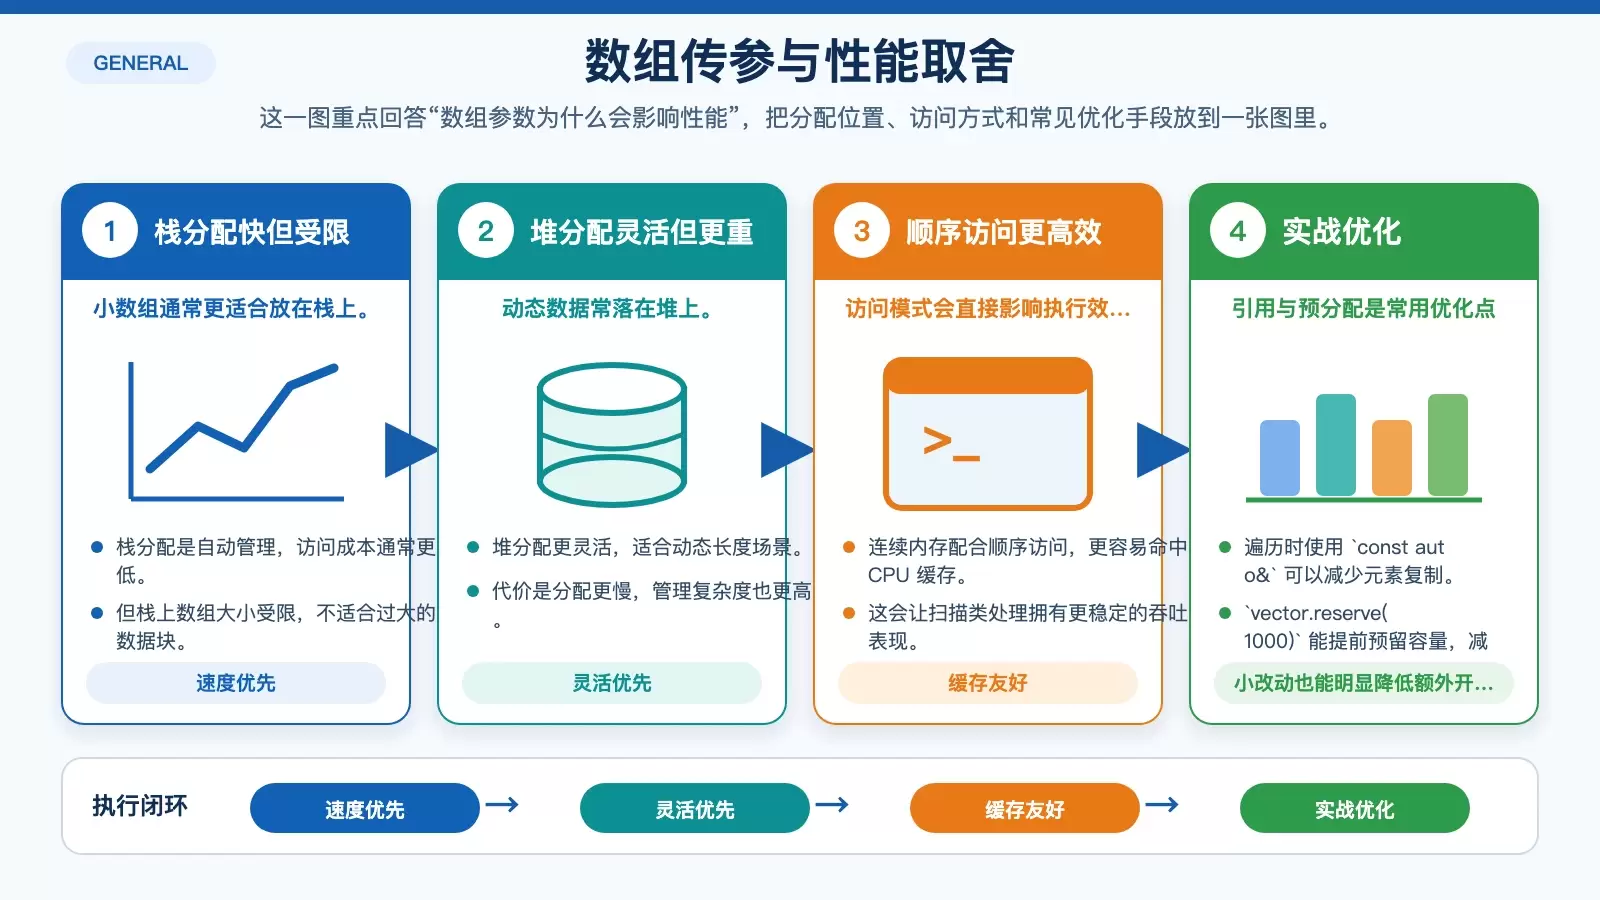
数组参数设计看起来像接口问题,实际上直接影响内存分配方式、缓存命中率和复制成本。如果函数会被频繁调用,或者处理的是大规模数据,这一层的差别会很快体现出来。
栈、堆与静态分配有什么区别
| 分配类型 | 内存位置 | 性能 | 灵活性 |
|---|---|---|---|
| 栈分配 | 自动 | 快 | 大小受限 |
| 堆分配 | 手动 | 慢 | 灵活 |
| 静态分配 | 编译时 | 高效 | 预先确定 |
对于小数组,栈分配通常更直接;对于动态长度场景,std::vector 提供了更好的可维护性;而在大小已知且固定时,std::array 往往是兼顾性能与安全性的折中方案。
几条直接有效的优化手法
// 高效的数组迭代
void optimizedProcess(const std::vector<int>& arr) {
    // 使用引用避免复制
    for (const auto& element : arr) {
        // 处理时无不必要的内存开销
    }
}

// 预分配内存
std::vector<int> efficientVector;
efficientVector.reserve(1000);  // 预先分配内存
这里有两个重点:一是用 const auto& 遍历元素,避免按值复制;二是提前 reserve(1000),减少动态扩容带来的重新分配成本。
顺序访问为什么更有利于性能
数组和 std::vector 都依赖连续内存,这使顺序访问更容易命中 CPU 缓存。原文将这种模式概括为:
- 缓存友好,效率更高
- 性能可预测
- 实现最佳内存利用
如果函数只是顺序扫描数组,那么连续容器通常比离散分配的数据结构更容易获得稳定性能。
基准测试与内存分析工具
要验证不同传参和分配策略的影响,可以结合基准代码与分析工具一起看。
#include <chrono>
#include <vector>

void performanceComparison() {
    const int SIZE = 1000000;

    // 栈分配
    auto start = std::chrono::high_resolution_clock::now();
    int stackArray[SIZE];
    auto end = std::chrono::high_resolution_clock::now();

    // 堆分配
    start = std::chrono::high_resolution_clock::now();
    std::vector<int> heapVector(SIZE);
    end = std::chrono::high_resolution_clock::now();
}
| 工具 | 用途 | 关键特性 |
|---|---|---|
| Valgrind | 内存分析 | 详细的内存泄漏 |
| gprof | 性能分析 | 执行时间 |
| 地址 sanitizer | 内存错误检测 | 运行时检查 |
动态数组与高级内存管理
// 智能指针的使用
std::unique_ptr<int[]> dynamicArray(new int[100]);
std::shared_ptr<int> sharedArray(new int[50], std::default_delete<int[]>());
这类写法说明,原生动态数组并不是不能用,但一旦牵涉所有权管理,就会迅速变复杂。除非确有特殊需求,否则通常优先选择 std::vector 这样的标准容器。
结论:优先写清楚边界,再谈性能优化
把数组传给函数时,真正要解决的不是“语法能不能写通”,而是长度是否明确、是否会修改原数据、有没有额外复制,以及后续维护者能不能一眼看懂接口语义。
简单总结就是:
- 固定大小且希望保留长度信息,用
std::array - 需要动态大小,用
std::vector - 必须使用原生数组时,显式传
size,并做好边界控制 - 只读场景优先加上
const,减少误修改和复制成本
掌握这些规则后,数组参数传递就不再只是 C++ 语法点,而是接口设计、内存管理和性能优化的一部分。









