


很多 C++ 初学者遇到“标准库导入问题”时,真正卡住的往往不是语法本身,而是头文件该怎么分、`using namespace std;` 该不该用,以及项目一变大后为什么编译越来越慢。下面按“先能正确导入,再避免命名冲突,最后处理复杂依赖”的顺序梳理常见做法,并保留原文中的命令、版本和示例代码,便于你直接对照实践。
先把标准库导入写对:`#include` 应该怎么用
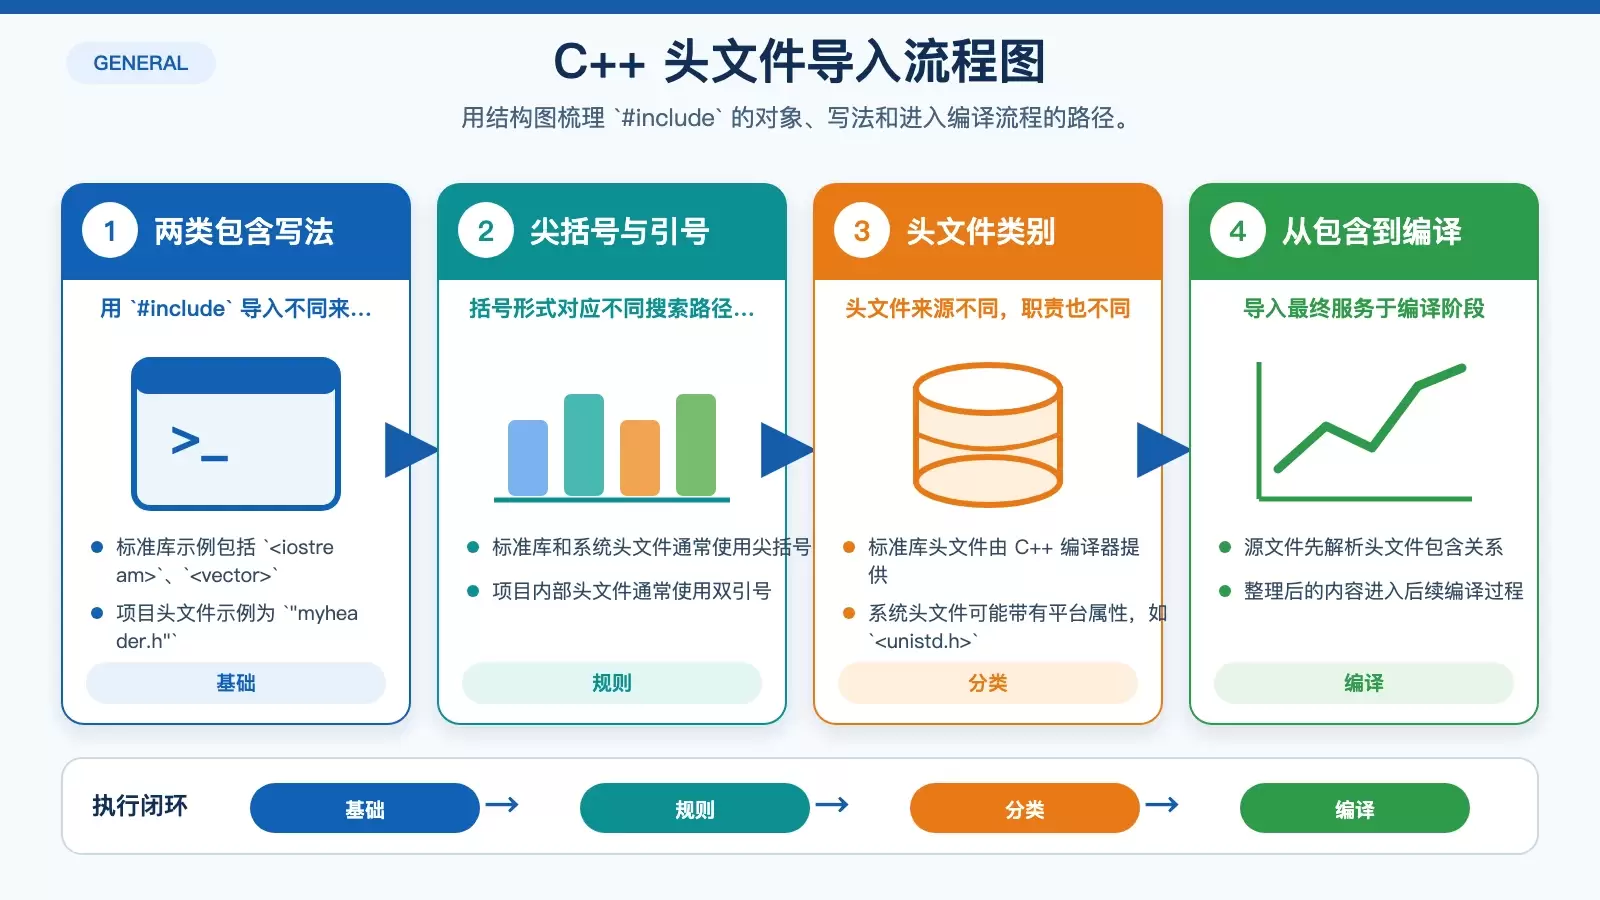
在 C++ 里,导入库最常见的方式就是使用 #include 预处理指令。日常开发里,最核心的区别是:标准库和系统头文件通常使用尖括号,自定义项目头文件使用双引号。
两种最常见的包含写法
// 系统头文件
#include <iostream>
#include <vector>

// 用户自定义头文件
#include "myheader.h"
头文件大致分哪几类
| 类别 | 描述 | 示例 |
|---|---|---|
| 标准库头文件 | 由 C++ 编译器提供 | <iostream>,<string> |
| 系统头文件 | 特定于平台的头文件 | <unistd.h> |
| 用户自定义头文件 | 项目内部头文件 | "myproject.h" |
源码到编译的导入流程
graph TD
    A[源文件] --> B{头文件包含}
    B --> |系统头文件| C[标准库]
    B --> |用户头文件| D[项目头文件]
    C --> E[编译过程]
    D --> E
一个可直接编译的标准库示例
#include <iostream>
#include <vector>

int main() {
    std::vector<int> numbers = {1, 2, 3, 4, 5};
    for(int num : numbers) {
        std::cout << num << " ";
    }
    return 0;
}
这一层最值得先记住的原则
- 优先使用特定导入,而不是一上来就引入整个命名空间。
- 标准库头文件使用尖括号
<>。 - 本地项目头文件使用引号
""。 - 尽量减少无关头文件包含,降低编译时间。
基础场景的编译命令
在 LabEx 环境中,可以直接使用标准 C++ 编译器:
g++ -std=c++11 your_program.cpp -o output
这里的 -std=c++11 对应原文示例所依赖的现代 C++ 语法,例如范围 for 和列表初始化。
导入后为什么还会出错:命名空间该怎么管
很多“导入没问题但代码还是报错”的情况,本质上都和命名空间有关。标准库中的 vector、cout、endl 等名字通常都在 std 命名空间里,如果不明确指定作用域,就容易出现找不到标识符或与项目代码冲突的问题。
命名空间的作用是什么
命名空间用于组织代码并避免命名冲突,它为类型名、函数名和变量名提供独立作用域。
namespace MyProject {
    class DataProcessor {
    public:
        void process() {}
    };
}
三种常见写法怎么选
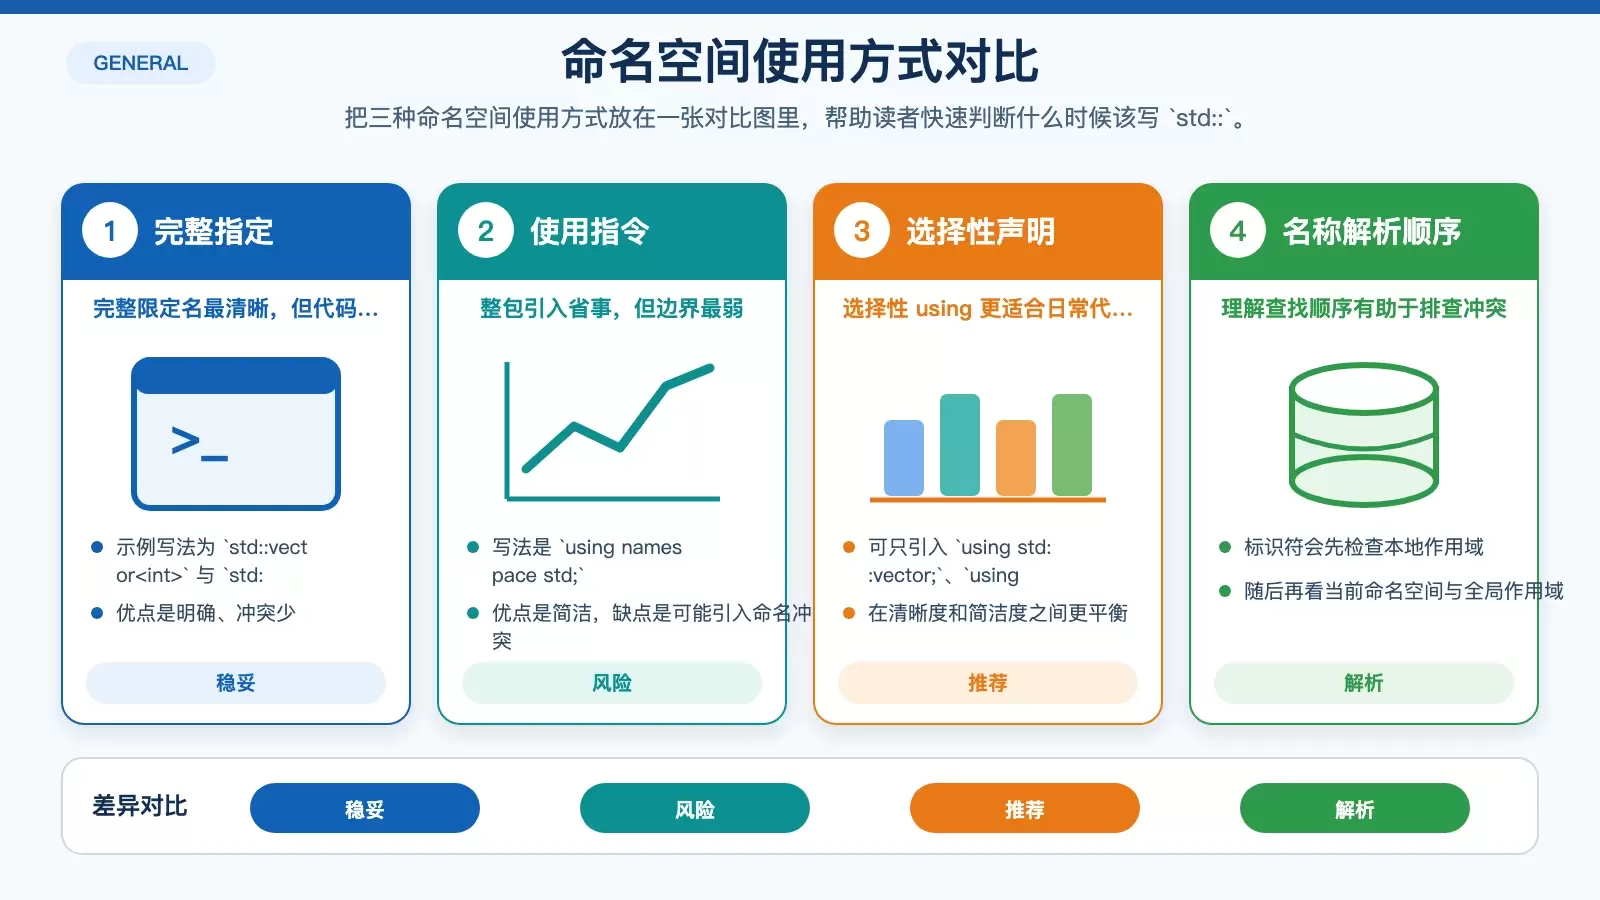
1. 完整命名空间指定
std::vector<int> numbers;
std::cout << "Hello, LabEx!" << std::endl;
2. 使用指令
using namespace std;
vector<int> numbers;
cout << "简化导入" << endl;
3. 选择性使用声明
using std::vector;
using std::cout;

vector<int> numbers;
cout << "特定导入" << std::endl;
三种方式的取舍
| 方法 | 优点 | 缺点 |
|---|---|---|
| 完整指定 | 明确,无命名冲突 | 代码冗长 |
| 使用命名空间 | 代码简洁 | 可能存在命名冲突 |
| 选择性使用 | 在清晰度和特定性之间取得平衡 | 作用域有限 |
标识符一般按什么顺序解析
graph TD
    A[标识符] --> B{命名空间检查}
    B --> |本地作用域| C[本地定义]
    B --> |当前命名空间| D[命名空间定义]
    B --> |全局作用域| E[全局定义]
嵌套、别名和匿名命名空间
嵌套命名空间
namespace ProjectName {
    namespace Utilities {
        class Helper {
            // 实现
        };
    }
}

// 访问嵌套命名空间
ProjectName::Utilities::Helper myHelper;
命名空间别名
// 定义一个很长的命名空间
namespace very_long_namespace_name {
    class ComplexClass {};
}

// 为长命名空间创建一个别名
namespace vln = very_long_namespace_name;
vln::ComplexClass myObject;
匿名命名空间
namespace {
    // 这里的标识符具有内部链接性
    int privateVariable = 10;
}
命名空间管理的实用建议
- 在头文件中避免使用
using namespace std;。 - 优先使用选择性的
using声明。 - 命名空间结构尽量清晰、可描述。
- 减少对全局命名空间的污染。
命名空间示例的编译命令
g++ -std=c++11 namespace_example.cpp -o namespace_demo
原文中输出文件名写作 namespace_demon,这里按常见用法整理为 namespace_demo;如果你需要完全复现原命令,也可以继续使用原文件名。
项目变复杂后,如何处理更高级的导入场景
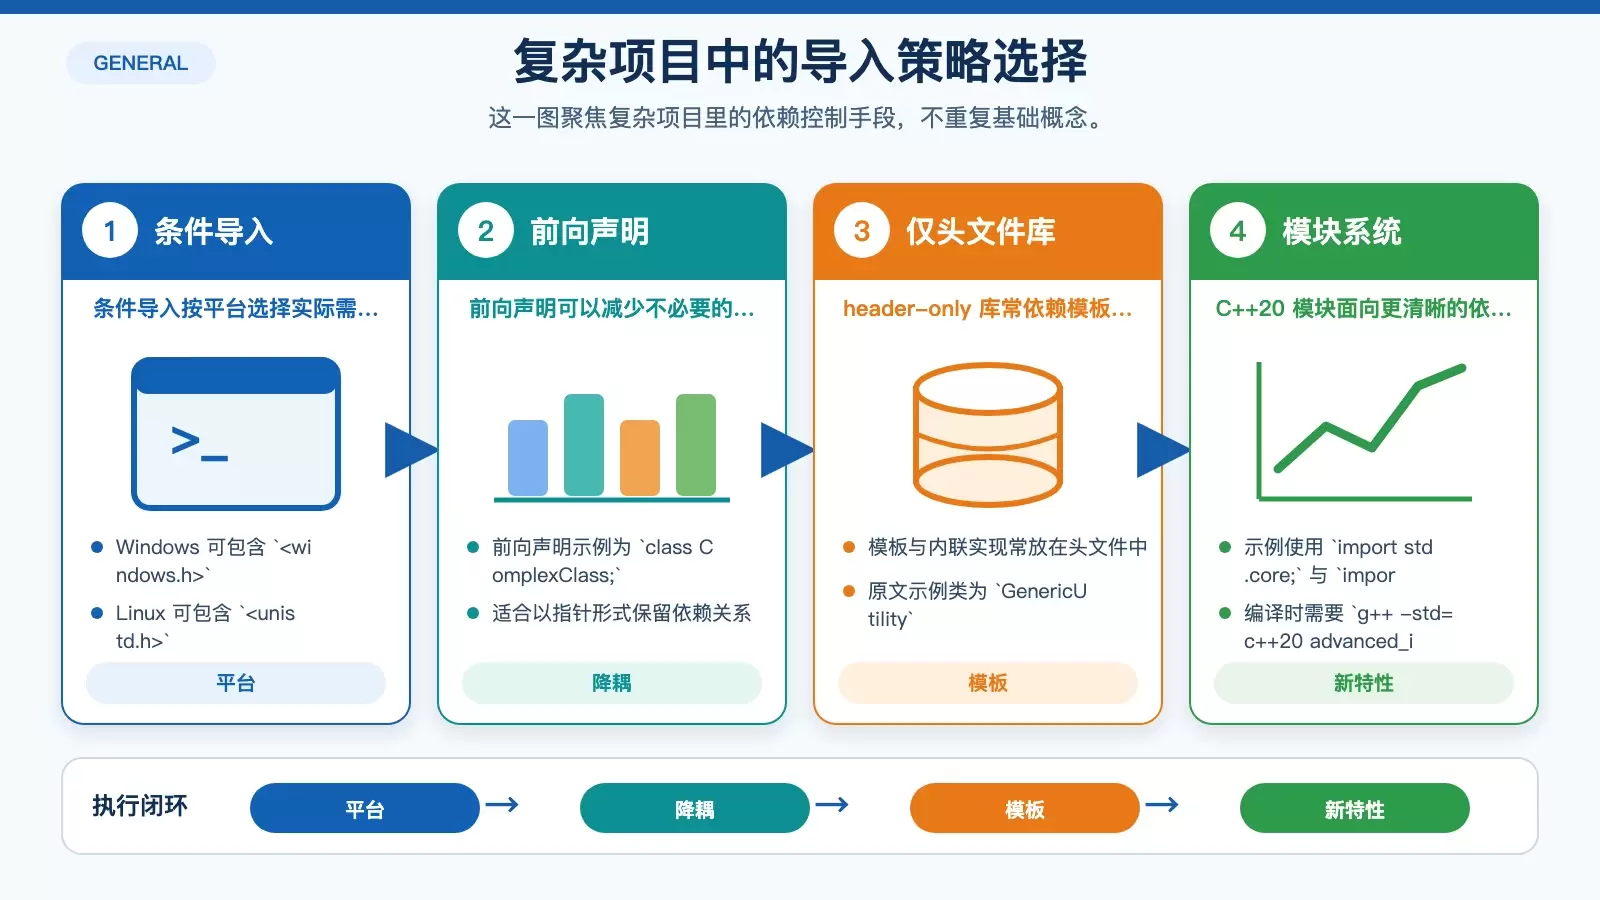
当代码规模扩大后,单纯靠“缺什么头文件补什么头文件”往往不够用了。平台差异、模板库、编译依赖和链接方式,都会影响导入策略的选择。
条件导入:按平台选择头文件
#ifdef _WIN32
    #include <windows.h>
#elif defined(__linux__)
    #include <unistd.h>
#endif
这类写法常见于需要兼容 Windows 和 Linux 的项目。关键点不在“导入更多”,而在“只导入当前平台真正需要的内容”。
仅头文件库与模板写法
#ifndef MYLIB_HEADER_H
#define MYLIB_HEADER_H

namespace LabEx {
    template<typename T>
    class GenericUtility {
    public:
        inline T process(T value) {
            return value * 2;
        }
    };
}
#endif
模板和内联函数常常放在头文件中,这也是很多 header-only 库的基础做法。
几种导入策略的差异
| 策略 | 复杂度 | 性能 | 灵活性 |
|---|---|---|---|
| 直接包含 | 低 | 中等 | 低 |
| 条件导入 | 中等 | 高 | 高 |
| 基于模板 | 高 | 优秀 | 非常高 |
从依赖分析到链接的流程
graph TD
    A[源文件] --> B{导入分析}
    B --> |静态依赖| C[编译时包含]
    B --> |动态依赖| D[运行时加载]
    C --> E[静态链接]
    D --> F[动态链接]
减少依赖的两种常见手段
前向声明
class ComplexClass;  // 前向声明
class DependentClass {
    ComplexClass* ptr;  // 基于指针的依赖
};
显式模板实例化
template<typename T>
class Container {
public:
    void process(T value);
};

// 显式实例化
template class Container<int>;
C++20 模块系统能解决什么问题
// C++20 模块导入
import std.core;
import std.memory;

export module MyCustomModule;
export int calculate(int x) {
    return x * 2;
}
与传统 #include 相比,模块系统的目标是降低重复解析头文件带来的成本,并改善大型工程的依赖组织。不过它也依赖编译器与工具链的支持情况,实际采用时要先确认环境。
静态链接与动态链接的差别
graph LR
    A[源文件] --> B{链接方法}
    B --> |静态链接| C[可执行文件更大]
    B --> |动态链接| D[可执行文件更小]
    C --> E[自包含]
    D --> F[共享库]
复杂导入中的错误处理示例
#include <stdexcept>

template<typename T>
T safeImport(T value) {
    if (!value) {
        throw std::runtime_error("导入失败");
    }
    return value;
}
高级导入场景下的实践建议
- 尽可能使用前向声明。
- 合理利用模板元编程。
- 理解平台条件差异。
- 尽量减少编译依赖。
- 评估链接方式与性能影响。
较新特性的编译命令
g++ -std=c++20 advanced_imports.cpp -o advanced_demo
原文中这一段命令前带有注释“使用现代C++ 标准编译”,核心信息是需要显式使用 -std=c++20 才能匹配模块等新特性。
怎么判断自己的导入方式是否合理
可以用一个简单标准来判断:小程序优先保证清晰和正确,大项目优先控制依赖和编译成本。若你只是调用几个标准库组件,明确写出 #include 和 std:: 往往最稳妥;如果项目已经出现平台差异、头文件膨胀或编译变慢,再考虑前向声明、条件导入、模板策略或 C++20 模块。
换句话说,标准库导入并不只是“让代码编过”,而是代码组织、可维护性和构建效率的一部分。把基础写法、命名空间边界和高级依赖控制分开理解,后续排查导入问题会轻松很多。









