

Python在云计算开发中的核心优势与典型应用场景

在现代云计算开发体系中,软件系统的工程重心已从传统的物理硬件管理全面转向高抽象层次的云端资源编排、跨系统API集成与事件驱动响应。Python凭借其在各大云厂商中一等公民级别的SDK支持、极强的胶水整合能力、卓越的开发交付效率以及无服务器(Serverless)架构下的天然敏捷度,成为了云平台运维、基础设施即代码(IaC)及云原生轻量后端开发的核心首选语言。本文将系统梳理Python在云计算开发中的核心优势,理性辨析围绕执行性能的常见认知边界,并结合具体的代码示例深入剖析其典型应用场景与落地实践。
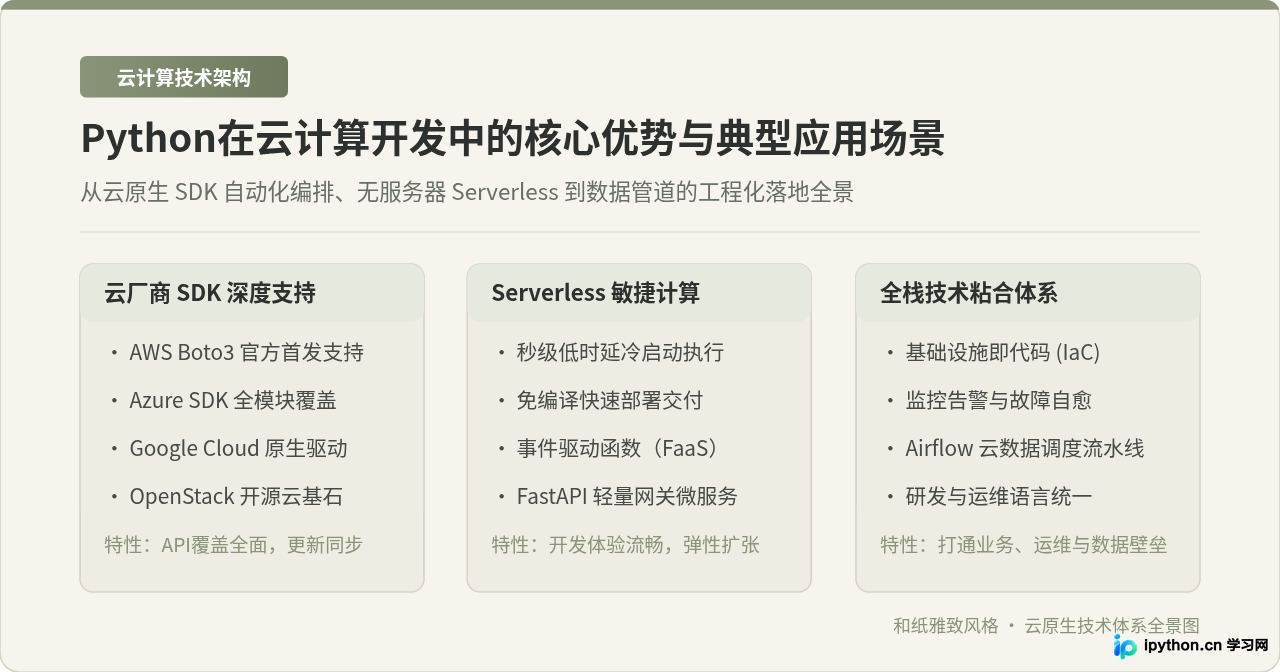
一、Python在云计算开发中的四大核心优势
云计算开发与传统单体或物理机软件开发的最大差异在于,云计算高度依赖对托管服务和API协议的调度组合。在这一范式转变中,Python展现出了其他编程语言难以替代的综合竞争力。
1. 主流云厂商的一等公民支持与完善SDK体系
无论是亚马逊AWS、微软Azure、谷歌云Google Cloud,还是国内的阿里云、腾讯云,其官方软件开发工具包(SDK)中Python始终占据核心地位。以AWS官方的Boto3为例,它不仅对AWS数百种托管服务提供了100%的API覆盖率,更与底层引擎botocore深度结合,实现了请求自动重试、签名计算、分块传输及凭据链轮换的完整封装。当云厂商推出全新云服务或新版API接口时,Python SDK通常同步甚至率先获得支持,使开发者无需耗费精力自行封装复杂的底层HTTP签名与网络重试逻辑。
2. 天然的“胶水语言”特性与多系统异构整合能力
云计算平台本质上是一个高度异构的分布式系统组合体:计算实例运行在Linux内核之上,数据持久化依托对象存储与托管数据库,日志汇聚至流式消息通道,而业务调用则穿梭于RESTful API与gRPC之间。Python具备无与伦比的标准库生态与第三方接口扩展库,能够轻量、高效地在各种序列化格式(如JSON、Protocol Buffers、YAML、Parquet)之间进行无缝转换,充当连接各类孤立云组件的“通用粘合剂”。
3. Serverless无服务器架构下的极速冷启动与高迭代效率
在FaaS(函数即服务,如AWS Lambda、阿里云函数计算)环境中,函数的冷启动(Cold Start)延迟直接影响系统的首包响应质量。相较于需要庞大运行时初始化和JIT编译的Java或.NET体系,Python解释器的体积精简、内存基线占用小,能够在毫秒级内完成容器实例的拉起与加载。同时,Python属于解释型脚本语言,在云端部署时无需经历耗时的本地交叉编译与重型容器镜像打包,极大提升了持续集成与持续部署(CI/CD)的流水线流转效率。
4. 统一业务开发、云运维与数据处理的技术语言栈
在传统的组织架构中,后端工程师通常使用编译型语言编写业务系统,SRE(站点可靠性工程师)使用Shell脚本维护服务器,而数据工程师则使用另外的技术栈处理ETL任务。这种技术栈的分裂在云原生时代带来了高昂的沟通与代码复用成本。Python的通用性打破了这一壁垒:从FastAPI驱动的轻量Web微服务,到Ansible/SaltStack/Pulumi驱动的自动化基础设施,再到Apache Airflow驱动的云端数据湖调度,团队内部可以使用统一的语法规范、测试工具链和工程习惯,显著降低整体运维与协作开销。
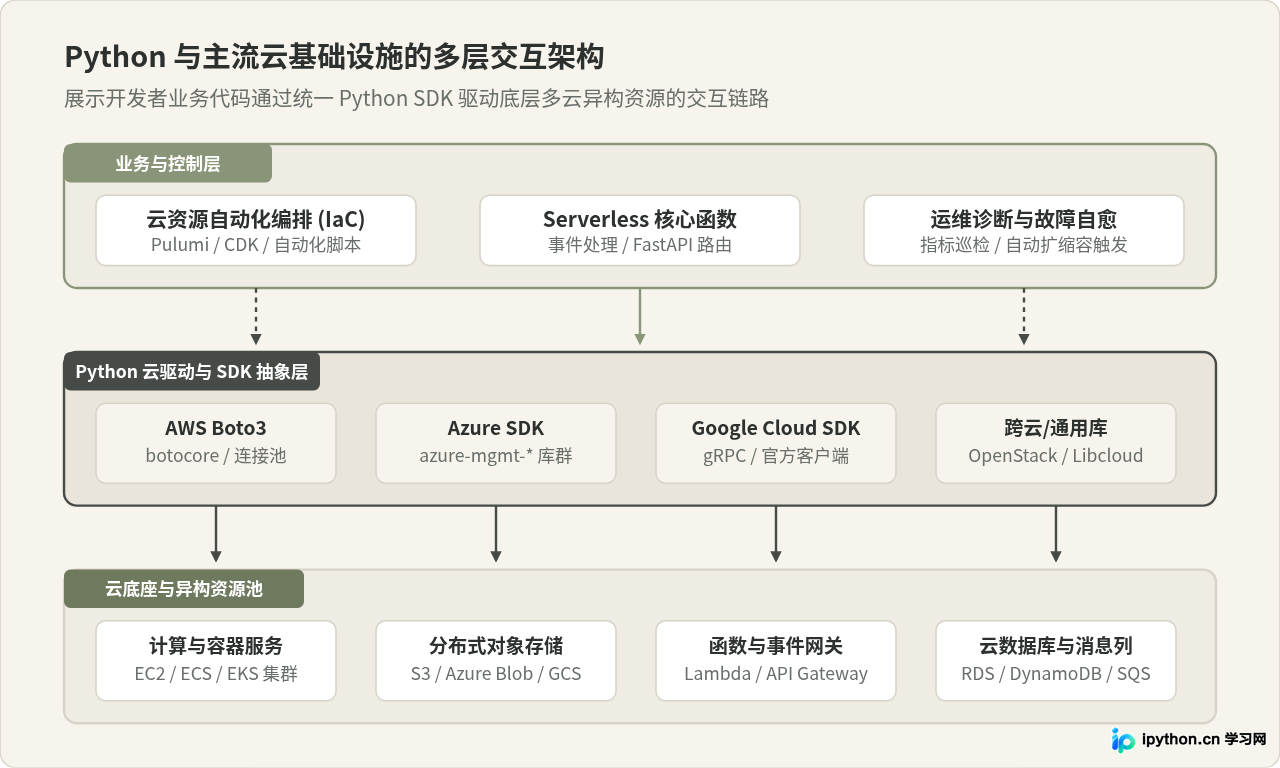
二、技术认知辨析:Python运行速度慢是否影响云计算开发?
在技术社区的讨论中,经常存在一种直觉性观点:“Python属于动态解释型语言,存在全局解释器锁(GIL),执行性能显著逊色于Go、Java或Rust,因此不适合承担云计算核心系统的开发任务”。理解这一观点的合理性与局限性,是进行正确技术选型的关键前提。
1. 该观点在哪些条件下确实成立?
这一结论在单机CPU密集型与纳秒/微秒级极低延迟场景下完全正确。具体包括:
- 底层虚拟化与网络数据平面开发:例如开发类似于Envoy的反向代理网络网关、KVM/QEMU底层虚拟化驱动或eBPF数据包实时过滤时,CPU指令周期的开销至关重要。
- 高密度单机算力算法:例如未经底层C/CUDA加速的超大规模稠密矩阵本地运算、视频流逐帧软件编码,Python的解释器循环开销和GIL锁会造成显著性能瓶颈。
2. 为什么在绝大多数云计算开发场景中该结论需要修正?
在云计算的绝大多数工程实践中,系统的性能瓶颈早已从“本地CPU指令执行速度”转移到了“跨网络I/O延迟与分布式服务往返时延”。这种转变由以下核心事实所决定:
- 时延维度的数量级差异:当Python代码调用云端S3存储桶读取对象,或向托管数据库发起SQL查询时,单次网络往返通常在10毫秒到80毫秒之间;而Python解释器执行十几行业务校验与对象反序列化通常仅需几十微秒。在此类I/O密集型场景中,改用编译型语言并不能实质性压缩网络往返耗时。
- SDK底层的原生C优化:以主流云SDK(如Boto3底层依赖的urllib3及cryptography)为例,其网络连接池管理、TLS/SSL握手加密及HTTP解析均由高优化的C语言扩展库完成,Python仅负责高层调度与上下文传递。
- 异步I/O与云底座的水平伸缩:借助Python现代异步语法(
asyncio、httpx),单进程即可轻松管理成千上万个并发网络请求。若系统面临真实的吞吐量激增,云计算架构的常规手段是通过弹性扩缩容(Auto Scaling)增加Serverless并发实例或容器副本,而非单纯依赖提升单实例的垂直计算性能。 - 算力向云托管服务的卸载(Offloading):在现代云架构中,真正的计算密集型工作(如全文检索、列式聚合、分布式机器学习)通常由托管服务(如OpenSearch、Snowflake、BigQuery)承担,Python的角色是作为“指挥官”协调任务与整合产物。
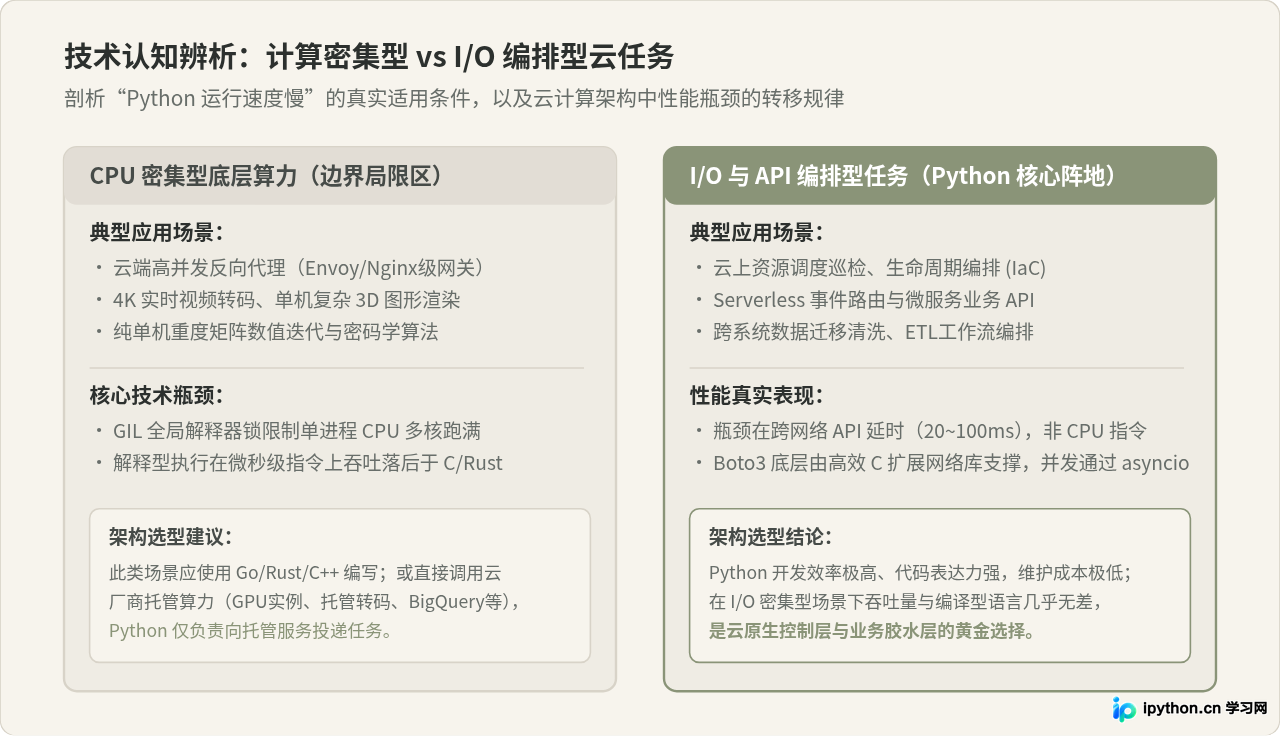
三、Python在云计算中的四大典型应用场景与工程实践
场景一:基础设施即代码(IaC)与云资源合规性自动化巡检
在大型企业的多账号、多区域云环境中,因开发人员疏忽遗漏的未挂载磁盘、未释放公网IP或未打规范标签的测试实例,会造成严重的成本浪费与安全隐患。使用Python结合Boto3编写自动巡检脚本,是实现自动化资源管控的标准方案。
业务目标:扫描指定区域内状态为 available(未挂载至任何EC2主机)的闲置EBS存储卷。检查其创建时长与标签规范,并在非演练模式下先执行快照备份,再安全释放闲置卷。
# -*- coding: utf-8 -*-
"""
运行环境需求:
1. Python 3.9+
2. 依赖安装: pip install boto3
3. 执行凭据: 具备 ec2:DescribeVolumes, ec2:CreateSnapshot, ec2:DeleteVolume 权限的 IAM 角色
"""

import sys
from datetime import datetime, timezone
import boto3
from botocore.exceptions import ClientError

def audit_and_cleanup_ebs_volumes(region_name: str = "us-east-1", dry_run: bool = True):
    """
    巡检指定区域的闲置 EBS 存储卷:
    1. 过滤未关联挂载的卷资源;
    2. 计算闲置时长并核实标签规范;
    3. 支持 DryRun 预检模式与自动快照保护后删除。
    """
    ec2_client = boto3.client("ec2", region_name=region_name)
    print(f"[*] 开始对区域 [{region_name}] 执行 EBS 卷资源自动化审计...")

    try:
        # 查询所有状态为 available 的孤立存储卷
        response = ec2_client.describe_volumes(
            Filters=[{"Name": "status", "Values": ["available"]}]
        )
        volumes = response.get("Volumes", [])
        print(f"[*] 发现 {len(volumes)} 个未挂载的孤立卷。")

        for vol in volumes:
            vol_id = vol["VolumeId"]
            size_gb = vol["Size"]
            create_time = vol["CreateTime"]
            tags = {t["Key"]: t["Value"] for t in vol.get("Tags", [])}

            # 核查标签规范(必须包含 Project 和 Environment 标识)
            missing_tags = [req for req in ["Project", "Environment"] if req not in tags]
            idle_days = (datetime.now(timezone.utc) - create_time).days

            print(f" -> 卷ID: {vol_id} | 大小: {size_gb}GB | 闲置天数: {idle_days}天 | 缺失标签: {missing_tags}")

            # 处置策略:闲置时间超过 7 天执行清理
            if idle_days >= 7:
                if dry_run:
                    print(f"    [演练预检] 卷 {vol_id} 满足清理策略,演练模式跳过实际写入。")
                else:
                    # 步骤 1: 自动打底快照,确保数据可恢复性
                    snapshot = ec2_client.create_snapshot(
                        VolumeId=vol_id,
                        Description=f"Auto-backup before deletion of idle volume {vol_id}"
                    )
                    print(f"    [快照已创建] 快照ID: {snapshot['SnapshotId']}")

                    # 步骤 2: 安全释放孤立资源
                    ec2_client.delete_volume(VolumeId=vol_id)
                    print(f"    [资源已释放] 闲置卷 {vol_id} 成功清理完毕。")

    except ClientError as err:
        error_msg = err.response.get("Error", {}).get("Message", str(err))
        print(f"[!] Boto3 调用异常: {error_msg}", file=sys.stderr)
        raise

if __name__ == "__main__":
    # 首次执行保持 dry_run=True,确保输出符合预期
    audit_and_cleanup_ebs_volumes(region_name="us-east-1", dry_run=True)
避坑指南:在编写云端自动化清理代码时,严禁跳过快照步骤直接物理删除资源。务必通过 dry_run 参数提供预检输出,并使用 Python 标准库的 timezone.utc 进行时间计算,避免因本地服务器时区配置不一致导致误判闲置天数。
场景二:Serverless 无服务器事件驱动计算与响应
Serverless是云原生架构的代表性演进方向。当用户向对象存储(如S3或OSS)上传静态资源时,云存储服务会自动产生通知事件,拉起Python函数进行实时处理与元数据提取。
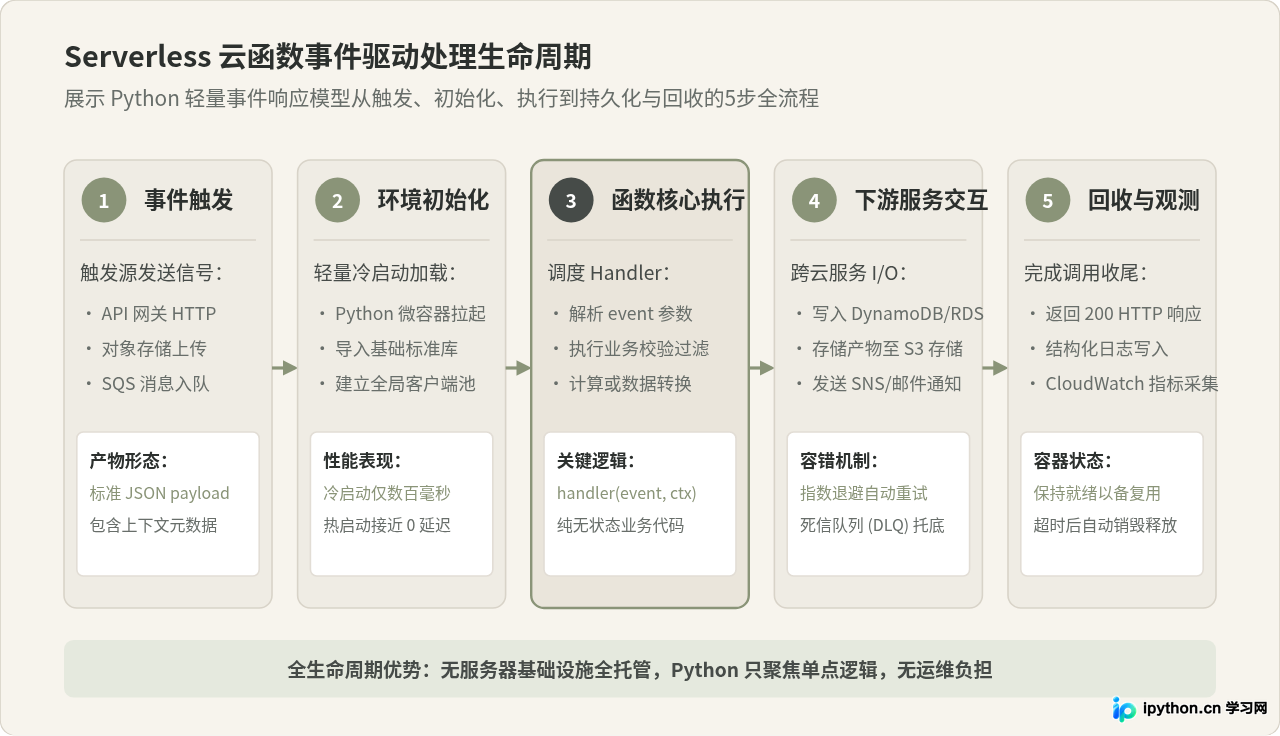
代码实现:以下为响应S3上传事件并记录文件元数据至DynamoDB数据库的生产级Lambda函数示例:
# -*- coding: utf-8 -*-
import json
import os
import urllib.parse
import boto3
from botocore.exceptions import ClientError

# 在模块全局层初始化客户端,确保后续热启动复用已建立的 TCP 与 TLS 连接
S3_CLIENT = boto3.client("s3")
DYNAMO_DB = boto3.resource("dynamodb")
TABLE_NAME = os.environ.get("TARGET_TABLE_NAME", "ObjectAuditLog")

def lambda_handler(event: dict, context) -> dict:
    """
    AWS Lambda 事件驱动入口函数:
    处理 S3 ObjectCreated 通知,解析路径编码并将文件元数据沉降至 DynamoDB。
    """
    audit_table = DYNAMO_DB.Table(TABLE_NAME)
    processed_items = []

    for record in event.get("Records", []):
        bucket_name = record["s3"]["bucket"]["name"]
        # S3 中的 Object Key 在事件载荷中经 URL 编码(如空格转为+号或%20),必须做反解
        raw_key = record["s3"]["object"]["key"]
        object_key = urllib.parse.unquote_plus(raw_key)
        object_size = record["s3"]["object"].get("size", 0)
        event_time = record.get("eventTime", "")

        print(f"[*] 收到新文件上传: s3://{bucket_name}/{object_key} ({object_size} 字节)")

        try:
            # 抓取文件头信息以获取真实 ContentType
            head_meta = S3_CLIENT.head_object(Bucket=bucket_name, Key=object_key)
            mime_type = head_meta.get("ContentType", "application/octet-stream")

            # 构建存盘数据项
            db_item = {
                "file_uri": f"s3://{bucket_name}/{object_key}",
                "bucket_name": bucket_name,
                "file_key": object_key,
                "file_size_bytes": object_size,
                "mime_type": mime_type,
                "processed_timestamp": event_time,
                "lambda_request_id": context.aws_request_id
            }

            audit_table.put_item(Item=db_item)
            processed_items.append(db_item["file_uri"])

        except ClientError as ex:
            error_details = ex.response.get("Error", {}).get("Message", str(ex))
            print(f"[!] 写入数据库或查询对象元数据失败 [{object_key}]: {error_details}")
            # 抛出异常以触发 Lambda 的死信队列 (DLQ) 或重试机制
            raise ex

    return {
        "statusCode": 200,
        "body": json.dumps({
            "status": "success",
            "processed_count": len(processed_items),
            "files": processed_items
        })
    }
场景三:云原生数据管道与跨云ETL编排
在云端大数据与机器学习工程中,数据的流动是业务运转的核心。Python是全球顶尖数据调度引擎(如Apache Airflow、Prefect)的原生定义语言(DAG as Code)。不同于基于XML或静态配置文件的系统,使用Python编写数据管道允许工程师引入条件分支循环、动态任务生成以及异常回退逻辑。通过调用云厂商托管的EMR、Glue或BigQuery API,Python在保持调度层极简的同时,能够驱动PB级数据在对象存储、数据湖与数仓之间的流通清洗。
场景四:监控指标聚合与故障自愈(Self-Healing)控制器
在分布式微服务架构中,单纯依赖被动的人工告警无法满足99.99%的SLA要求。通过Python轻量化常驻进程或事件订阅Webhook,可以构建自愈机器人:
- 当Prometheus或CloudWatch发出节点内存耗尽或磁盘只读告警时,Python控制器自动定位到异常实例ID;
- 通过云SDK将该实例从应用负载均衡器(ALB)的后端目标组中临时摘除,阻断新流量流入;
- 调用系统管理器(SSM)抓取现场诊断日志,随后触发实例置换或自动重启,并向企业微信/飞书/Slack推送处理闭环卡片。
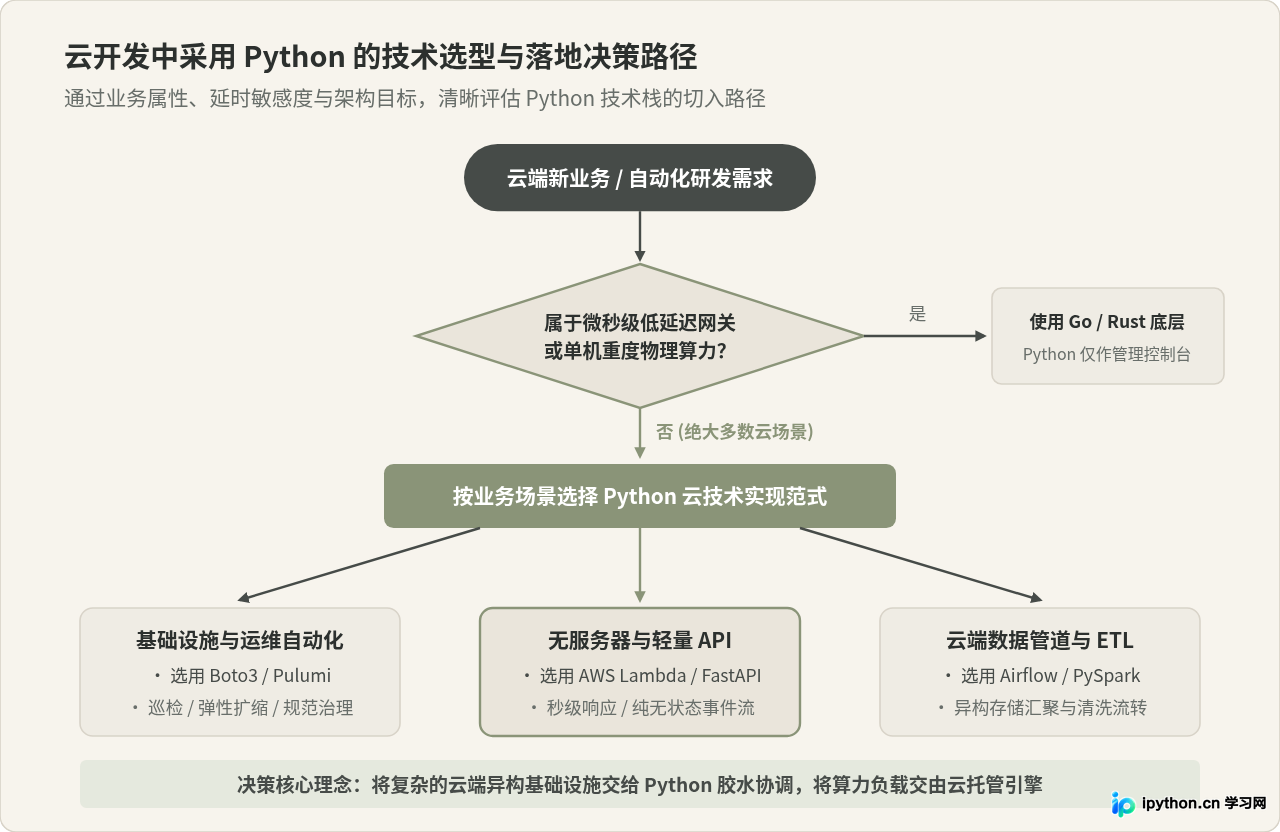
四、云开发中采用Python的技术选型与落地决策路径
为了在实际架构设计中避免盲目技术跟风,团队应当根据业务的具体瓶颈属性,建立清晰的语言选型决策路径。下图总结了在面对云端新业务需求时,决定是否采用Python及采用何种实现范式的工程判断逻辑:
五、总结
云计算技术的发展极大地重塑了现代软件架构,其核心目标是让开发团队从繁琐的底层基础设施维护中解脱出来,聚焦于业务交付的敏捷性与弹性。Python不仅没有因为执行层面的解释特性而在云计算中被边缘化,反而凭借其强大的官方SDK生态、极低的认知开销、统一的技术栈表达力以及卓越的I/O粘合能力,成为了连接异构云服务最稳固、最高效的纽带。在实际工程落地中,清晰划分业务边界——让专用计算引擎处理极端算力,由Python承担控制平面与业务编排——正是最大化释放云计算商业价值的核心工程哲学。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









