

Python应用中使用Apollo本地缓存策略确保高可用

在分布式系统中使用集中配置中心,最常面临的一个现实问题是:当配置中心服务不可用或网络发生分区时,依赖配置的业务应用是否会直接崩溃或无法启动。在 Python 应用中接入携程 Apollo 时,保障高可用的核心就在于落地一套可靠的本地文件容灾缓存与内存优先读取策略。只要合理配置并持久化本地缓存,即使 Apollo 远端集群彻底断连,应用依然能够利用本地快照平稳启动并维持现有业务运转。
一、Apollo多级缓存容灾模型
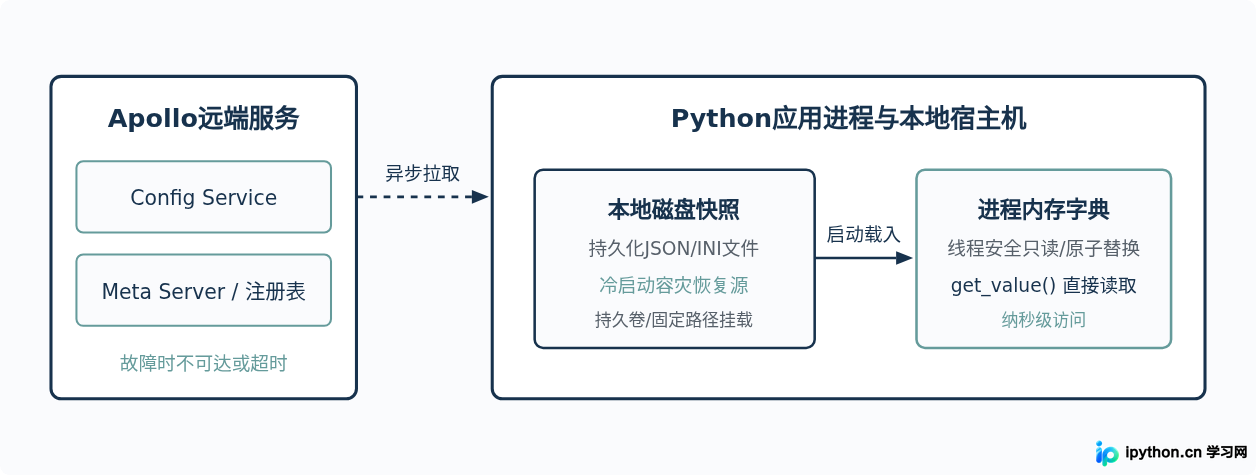
Apollo 官方的客户端架构本质上是一套分层的读写隔离设计。在常规运行中,应用进程内的内存字典提供纳秒级读取;后台异步轮询线程负责监听远程长轮询通知(Notification),并将最新变更原子化刷入本地磁盘快照与内存。这种读写解耦的机制决定了业务主流程不会直接同步发起 HTTP 请求去 Apollo 远端拉取数据。
当网络故障或 Apollo Meta/Config Service 出现集群宕机时,读取链路会天然收缩,直接阻断对远端的强依赖。本地磁盘文件成为最后一层有效的物理备份,确保应用在新实例冷启动、扩容或者重启时,依然能够从磁盘恢复出上一次成功的配置版本。
二、客户端选型与关键参数配置
在 Python 生态中,常用的客户端实现包括社区维护的 pyapollo 或适配 Apollo Open API 的开源客户端。在配置高可用策略时,无论选用哪一个库,都必须显式满足三个底层参数要求:
- 明确指定本地缓存路径(
cache_dir):如果不配置该路径,许多 Python 客户端会默认写入运行目录或操作系统的临时文件夹(如/tmp)。在容器化重新调度或机器重启时,临时文件会被直接清理,导致缓存丢失。 - 设置合理的拉取超时(
timeout):远程请求必须配置短超时(如 2 到 3 秒),避免在远端无响应时卡死主进程或导致后台同步线程长期阻塞。 - 启用后台长轮询同步机制:由守护线程负责增量拉取和更新本地磁盘快照,业务代码始终从本地内存获取值。
下面是一个经过高可用加固的 Python Apollo 客户端封装示例,具备本地缓存初始化、目录权限预检、后台更新和只读保底逻辑:
import os
import json
import logging
from pyapollo import ApolloClient

logger = logging.getLogger(__name__)

class HighAvailabilityApollo:
    def __init__(self, app_id, cluster="default", config_server_url="", cache_dir="/var/data/apollo_cache", namespaces=None):
        self.app_id = app_id
        self.cluster = cluster
        self.config_server_url = config_server_url
        self.cache_dir = cache_dir
        self.namespaces = namespaces or ["application"]

        # 1. 确保缓存目录存在并具备读写权限
        self._ensure_cache_dir()

        # 2. 实例化客户端并挂载本地缓存目录
        self.client = ApolloClient(
            app_id=self.app_id,
            cluster=self.cluster,
            config_server_url=self.config_server_url,
            cache_file_path=self.cache_dir
        )
        # 设置请求超时时间为 3 秒,避免远端宕机时拖垮进程
        self.client.timeout = 3

    def _ensure_cache_dir(self):
        if not os.path.exists(self.cache_dir):
            try:
                os.makedirs(self.cache_dir, exist_ok=True)
                logger.info("创建Apollo本地缓存目录成功: %s", self.cache_dir)
            except OSError as exc:
                logger.error("无法创建本地缓存目录: %s, 错误: %s", self.cache_dir, exc)
                raise
        if not os.access(self.cache_dir, os.W_OK):
            raise PermissionError(f"本地缓存目录没有写入权限: {self.cache_dir}")

    def start(self):
        """
        启动后台监听同步,并在远程完全不可达时优雅降级读取本地缓存
        """
        try:
            # 尝试从远端首次全量同步
            self.client.start()
            logger.info("成功连接Apollo服务器,已完成首轮配置同步。")
        except Exception as e:
            # 核心容灾点:即使初始化远端握手失败,也不应阻断进程抛出异常终止
            logger.warning("连接Apollo服务器失败,开启本地文件兜底模式: %s", e)
            self._load_fallback_from_disk()

    def _load_fallback_from_disk(self):
        """当且仅当远程失联且客户端未完成初次载入时,从磁盘文件装载配置"""
        for ns in self.namespaces:
            filename = f"{self.app_id}_{self.cluster}_{ns}.json"
            filepath = os.path.join(self.cache_dir, filename)
            if os.path.exists(filepath):
                try:
                    with open(filepath, "r", encoding="utf-8") as f:
                        data = json.load(f)
                        # 将磁盘快照灌入内存中供上层业务直接获取
                        if not hasattr(self.client, "_cache"):
                            self.client._cache = {}
                        self.client._cache.setdefault(ns, {}).update(data.get("configurations", {}))
                    logger.info("从本地磁盘快照恢复命名空间 [%s] 配置成功", ns)
                except Exception as read_err:
                    logger.error("读取磁盘快照 [%s] 失败: %s", filepath, read_err)
            else:
                logger.error("未找到磁盘快照文件: %s,无历史可用配置!", filepath)

    def get(self, key, default_val=None, namespace="application"):
        return self.client.get_value(key, default_val=default_val, namespace=namespace)
三、配置读取与容灾恢复流程
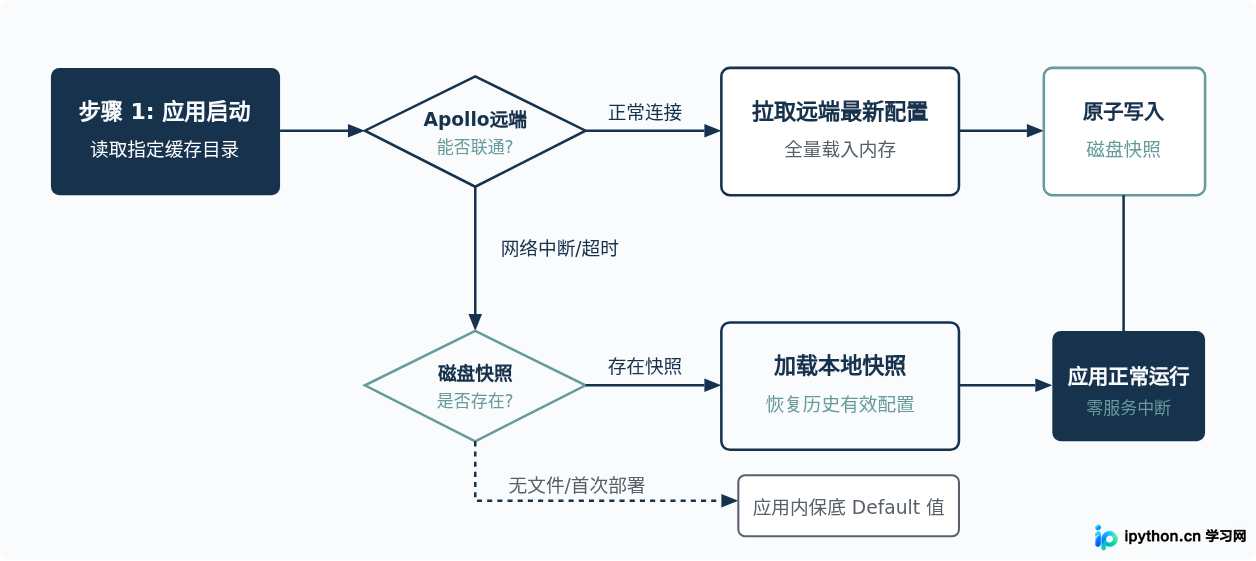
在应用启动以及运行时,配置的获取必须遵循确定的优先级顺序。很多故障之所以会引起停机,是因为代码在启动期强制执行了“远端拉取失败即抛出 SystemExit”的逻辑。
正确的高可用执行顺序应该是:进程内存优先 -> 本地磁盘快照兜底 -> 代码内声明的默认值(Default Value)防穿透。只要本地存在由上一次成功运行留下的快照文件,冷启动就可以在 0 毫秒网络等待的情况下顺利完成。
四、容器化与持久化目录踩坑与实测避错
在传统的物理机或虚机部署中,Apollo 的缓存写入一个固定的绝对路径即可生效。但是在现代基于 Docker 与 Kubernetes 的容器化交付场景中,本地缓存常常因为生命周期管理不当而彻底失效。以下是落地本地缓存策略必须严格把控的细节:
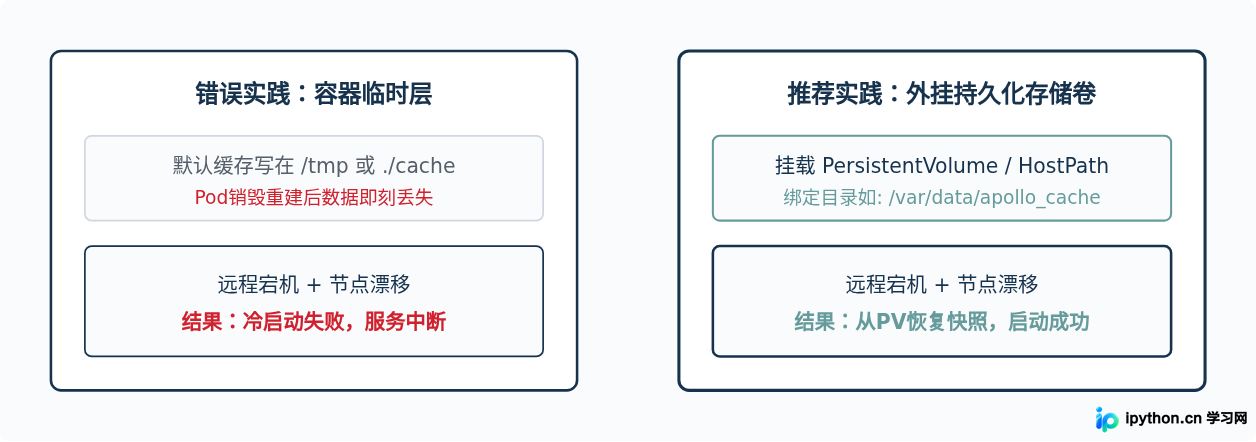
1. 警惕临时容器只读层与 Pod 漂移
如果容器内部路径没有挂载存储卷,每次 Pod 重建或节点漂移,容器都会产生全新的可写层,原有的本地快照直接清空。此时如果恰逢 Apollo 远端故障,新的 Pod 将因为既连不上远程又没有本地快照而启动失败,造成“雪崩”。必须将缓存路径明确映射到宿主机的持久卷(PersistentVolume)或 HostPath 上。
2. 文件写入原子性问题
后台线程在更新本地缓存文件时,如果直接使用 open(path, 'w') 覆盖写入,一旦写入过程中断电或进程强退,磁盘上只会留下残缺损坏的空文件或非法 JSON。稳妥的做法是:先写入临时文件(如 .tmp),在数据确认落盘后再通过 os.replace() 完成原子替换。在 POSIX 系统下,原子替换能够保证读取端永远拿到一个完整合法的数据版本。
JSONDecodeError,优先检查本地缓存文件的修改时间和体积。确保非 root 用户对缓存目录拥有 0755 权限,避免容器安全上下文(SecurityContext)导致写入被底层拒绝。
五、高可用策略配置核心检查清单
在生产环境中正式上线前,可以通过以下四个标准阶段自查本地缓存机制是否真正具备了高可用能力:
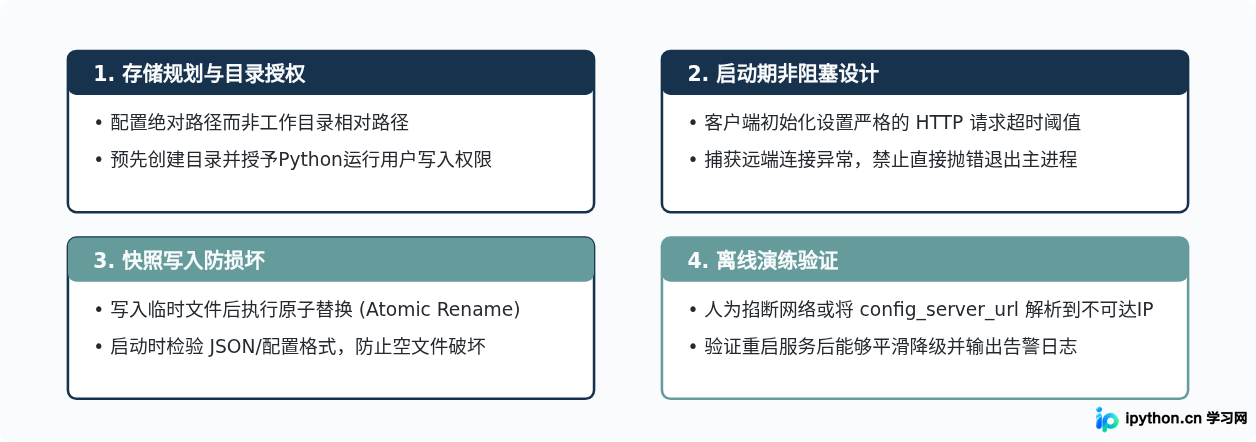
只要在 Python 应用中完整落地了目录持久化、非阻塞降级以及快照有效性保障,整个系统面对 Apollo 节点宕机、网络闪断或集群维护时,就能做到完全脱敏,保障业务逻辑持续稳定运行。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









