


在 C++ 里写指数运算,看起来只是一个 `a^b` 的问题,实际很快会碰到类型选择、精度误差、性能开销以及整数溢出等细节。下面这篇文章按“先会用、再选型、最后落到场景”的顺序整理常见做法,既保留基础示例,也补出判断方法,方便你在不同输入规模和计算目标下选到合适实现。
先弄清楚:C++ 里的指数计算是什么
指数计算表示把一个底数提升到某个幂次,一个典型表达式写作 a^b,其中:
a是底数;b是指数,也就是幂次。
在 C++ 中,指数运算没有单独的幂运算符,通常需要调用标准库函数,或者自己实现乘法逻辑。不同方案面对整数幂、浮点幂、负指数时,行为和成本并不一样。
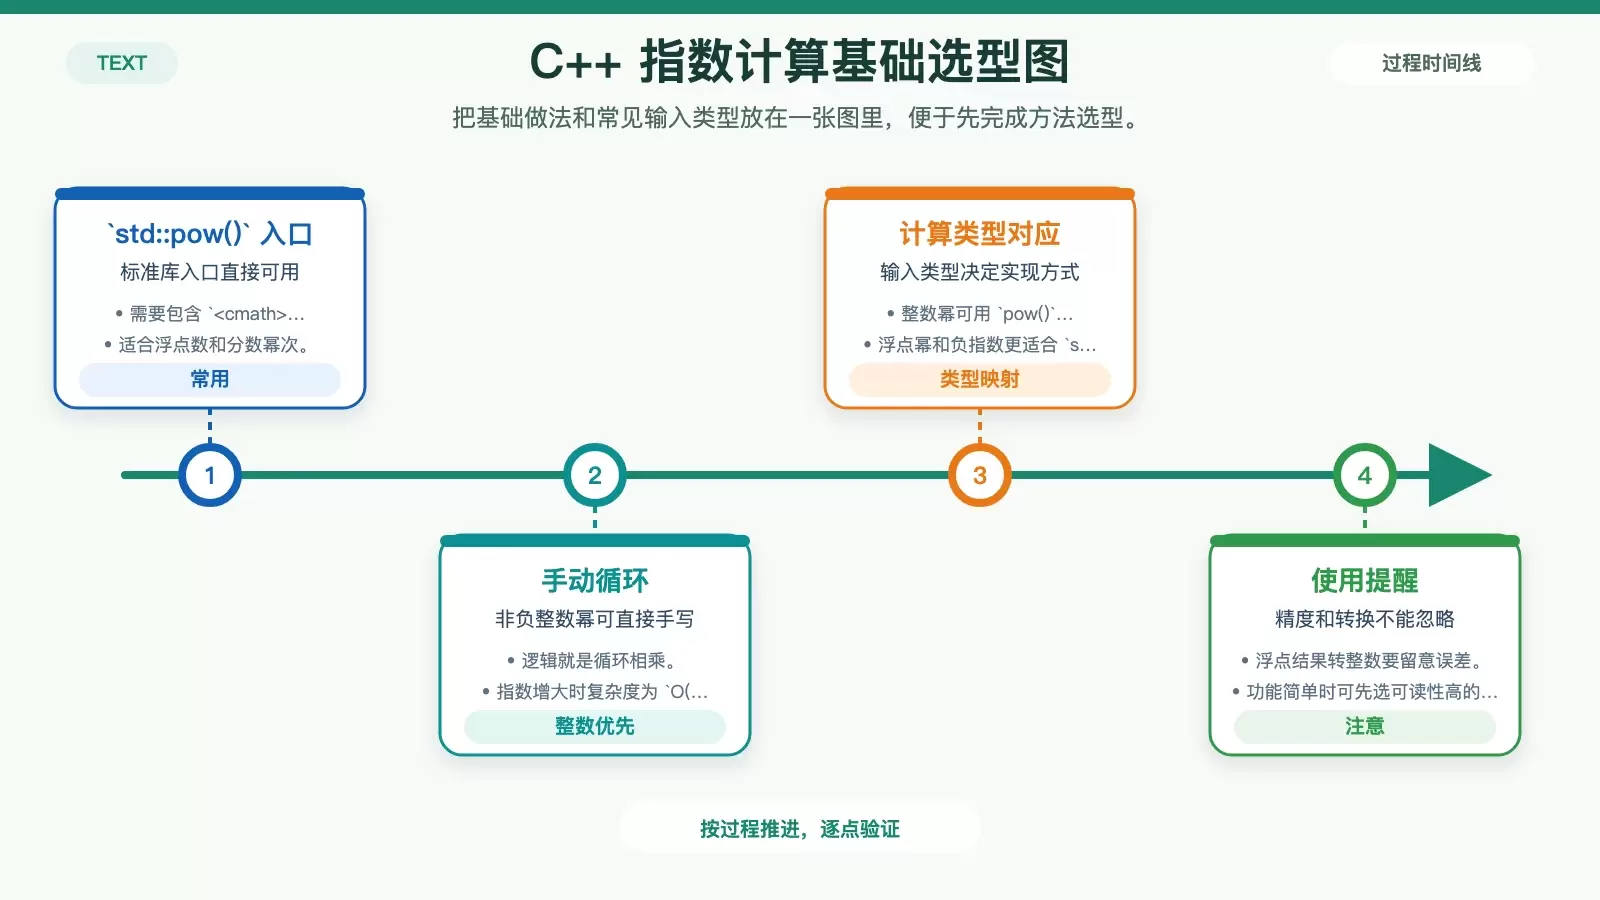
基础做法有哪些:`std::pow()` 与手动循环
直接使用标准库 `pow()`
如果你希望优先解决功能问题,标准库的 pow() 是最直接的入口。它定义在 <cmath> 中,适合处理常见幂运算,尤其是浮点数和分数幂次。
#include <cmath>
#include <iostream>

int main() {
    // 基本指数计算
    double result = pow(2, 3);  // 2^3 = 8
    std::cout << "2^3 = " << result << std::endl;

    // 处理不同类型
    int intResult = pow(2, 4);  // 2^4 = 16
    std::cout << "2^4 = " << intResult << std::endl;

    return 0;
}
这类写法简单,但要留意一点:pow() 往往以浮点计算为核心,结果再转成整数时,可能受到精度和类型转换影响。
整数幂也可以手动循环
如果场景明确是整数底数、非负整数指数,手动乘法往往更直观,也更容易控制行为。
#include <iostream>

int manualExponentiation(int base, int exponent) {
    int result = 1;
    for (int i = 0; i < exponent; ++i) {
        result *= base;
    }
    return result;
}

int main() {
    int result = manualExponentiation(2, 3);
    std::cout << "2^3 = " << result << std::endl;
    return 0;
}
它的优点是逻辑稳定、结果类型清晰;缺点是指数一旦变大,时间复杂度会按 O(n) 增长。
常见指数计算类型怎么选
| 计算类型 | 描述 | C++ 方法 |
|---|---|---|
| 整数指数运算 | 整数幂次 | pow() 或手动循环 |
| 浮点指数运算 | 十进制或分数幂次 | std::pow() |
| 负指数 | 小于零的幂次 | 带有负指数的 std::pow() |
什么时候该用哪种方法
先注意这几个基础问题
- 始终包含
<cmath>以使用指数函数。 - 注意浮点计算中可能出现的精度问题。
- 根据具体用例选择最合适的方法。
性能上的基本判断
- 对于整数幂次,手动乘法可能更高效。
- 对于复杂或浮点计算,使用
std::pow()。 - 考虑对重复计算进行编译器优化。
如果只是偶发计算,写法简洁通常比极致优化更重要;但一旦进入循环、大指数或者性能敏感路径,就要考虑快速幂等更高效的方法。
性能敏感场景怎么做:递归、快速幂和模板计算
递归分治的指数计算
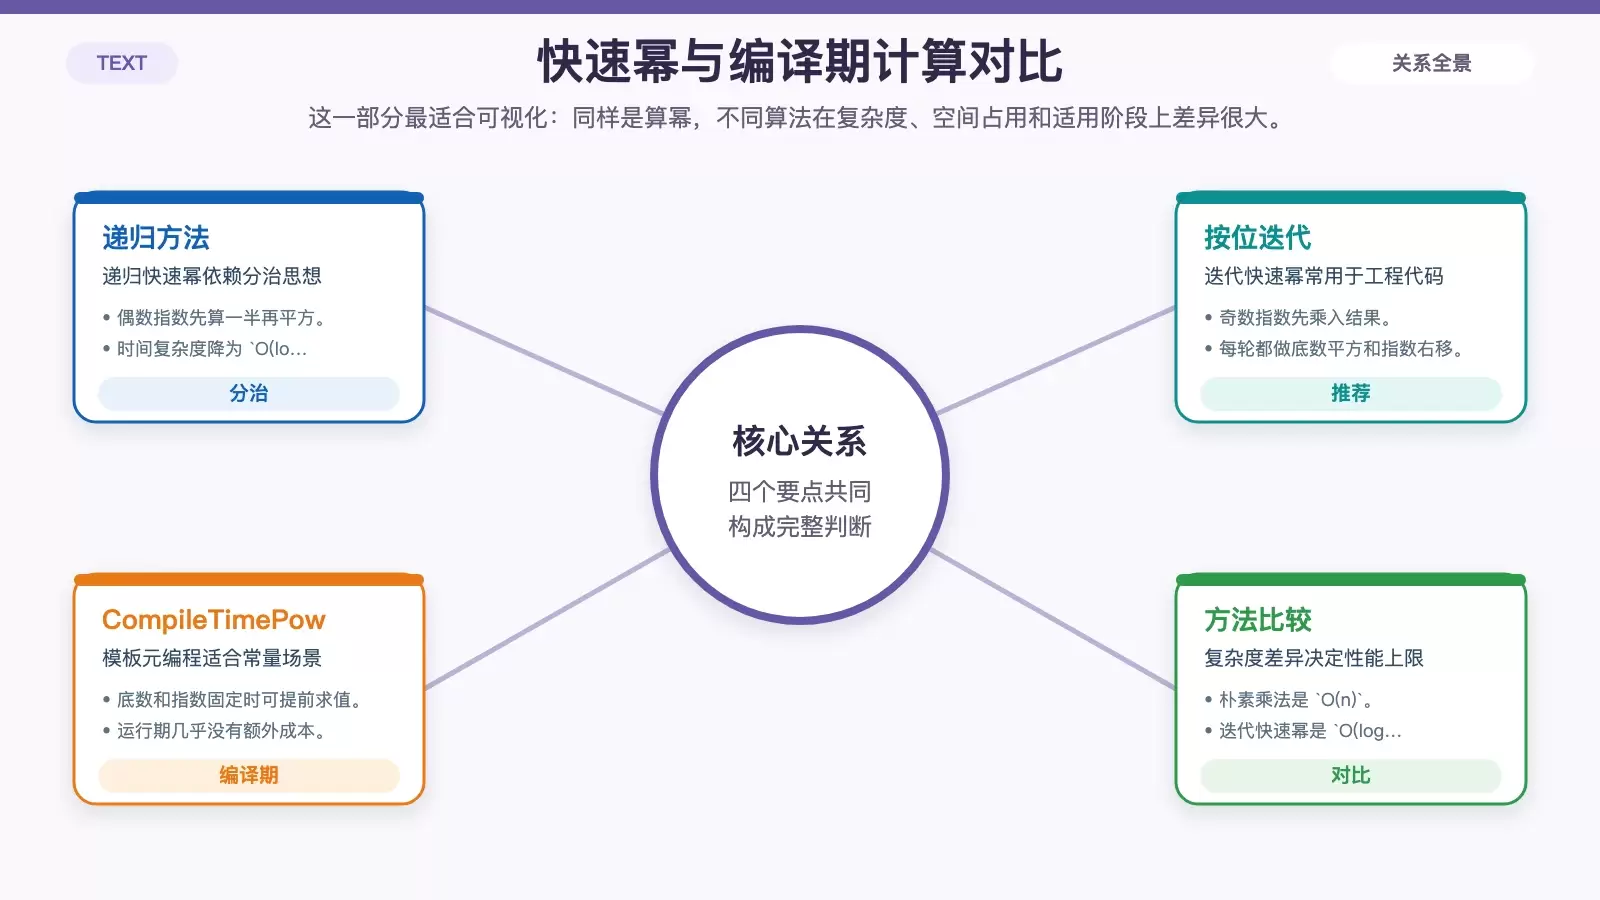
递归做法的核心是把幂次拆小。对于偶数指数,可以先算一半再平方;对于奇数指数,再额外乘一次底数。这类分治思路能把计算量从线性降低到对数级。
#include <iostream>

// 递归幂计算
long long recursivePow(long long base, int exponent) {
    // 基本情况
    if (exponent == 0) return 1;
    if (exponent == 1) return base;

    // 分治方法
    if (exponent % 2 == 0) {
        long long half = recursivePow(base, exponent / 2);
        return half * half;
    } else {
        return base * recursivePow(base, exponent - 1);
    }
}

int main() {
    std::cout << "2^10 = " << recursivePow(2, 10) << std::endl;
    return 0;
}
这种写法适合理解快速幂原理,但递归会带来额外栈开销,指数很大时也要注意调用深度。
更常用的是迭代快速幂
实际工程里,更常见的是迭代版快速幂。它通过按位判断指数奇偶,并在每一步对底数平方、对指数右移,实现 O(log n) 的计算效率,同时把空间复杂度控制在 O(1)。
#include <iostream>

// 快速迭代指数运算
long long fastPow(long long base, int exponent) {
    long long result = 1;

    while (exponent > 0) {
        // 处理奇数指数
        if (exponent & 1) {
            result *= base;
        }

        // 对底数平方
        base *= base;

        // 减少指数
        exponent >>= 1;
    }

    return result;
}

int main() {
    std::cout << "3^5 = " << fastPow(3, 5) << std::endl;
    return 0;
}
如果你的输入是整数,且指数非负,这通常是最值得优先考虑的高性能实现。
编译期计算:模板元编程方案
当底数和指数在编译期就已经确定时,还可以直接把结果放到编译阶段求出来。这样运行期几乎没有成本,但模板写法会明显更复杂,适合对性能和常量表达式有明确要求的代码。
#include <iostream>

// 编译时指数计算
template <long long Base, int Exponent>
struct CompileTimePow {
    static constexpr long long value =
        Exponent == 0? 1 :
        Exponent % 2 == 0?
        CompileTimePow<Base, Exponent/2>::value *
        CompileTimePow<Base, Exponent/2>::value :
        Base * CompileTimePow<Base, Exponent-1>::value;
};

// 基类特化
template <long long Base>
struct CompileTimePow<Base, 0> {
    static constexpr long long value = 1;
};

int main() {
    constexpr auto result = CompileTimePow<2, 10>::value;
    std::cout << "2^10 = " << result << std::endl;
    return 0;
}
几种方法的复杂度对比
| 方法 | 时间复杂度 | 空间复杂度 | 精度 |
|---|---|---|---|
| 朴素乘法 | O(n) |
O(1) |
高 |
| 递归方法 | O(log n) |
O(log n) |
高 |
| 迭代按位运算 | O(log n) |
O(1) |
高 |
标准库 pow() |
O(1) |
O(1) |
各异 |
除了算得快,还要注意精度和错误处理
优化方向并不只在算法
- 使用按位运算以实现更快的计算。
- 尽可能利用编译时计算。
- 根据输入大小和类型选择合适的方法。
负指数与溢出需要单独处理
对于整数快速幂,实现时通常默认指数非负。如果要对外提供更稳妥的接口,至少要明确负指数是否支持,以及在大底数、大指数下如何检查溢出。
#include <stdexcept>
#include <limits>

long long safePow(long long base, int exponent) {
    // 防止整数溢出
    if (exponent < 0) {
        throw std::invalid_argument("不支持负指数");
    }

    // 检查潜在溢出
    if (base > std::numeric_limits<long long>::max()) {
        throw std::overflow_error("底数太大,无法进行计算");
    }

    return fastPow(base, exponent);
}
上面这段代码给出了基本思路:先拦截不支持的输入,再把实际计算交给快速幂。工程里如果对溢出要求严格,还需要在乘法过程中逐步检查,而不是只在入口判断一次。
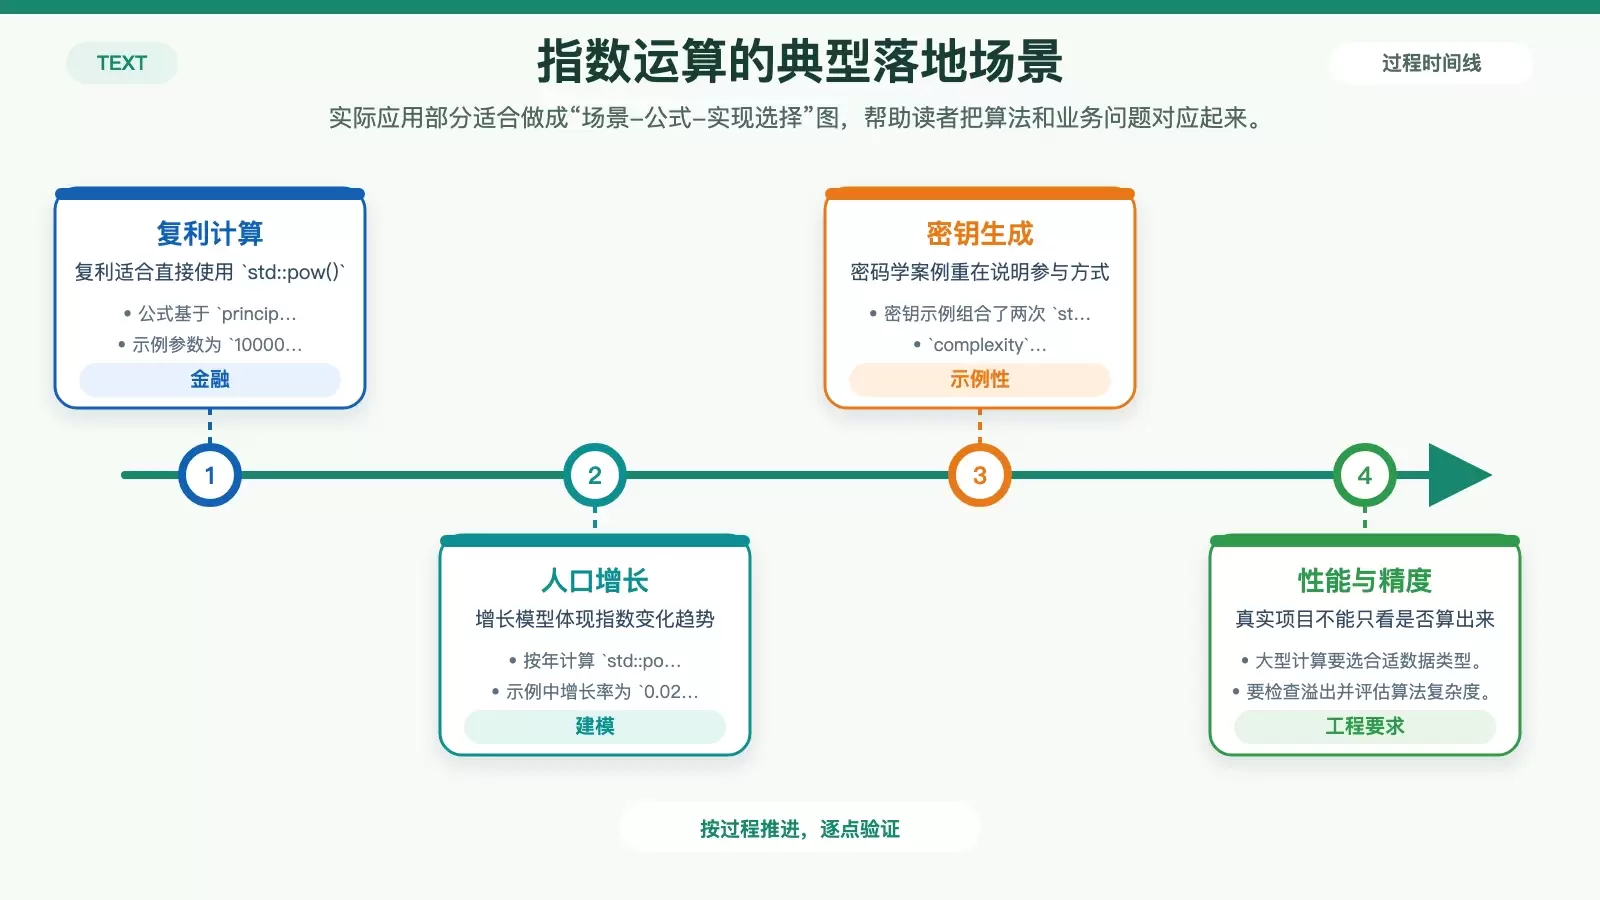
这些指数计算能用在哪些实际场景
复利计算
在金融场景里,指数运算最直接的例子就是复利。此时通常需要浮点计算,因此 std::pow() 依然是合适选择。
#include <iostream>
#include <iomanip>
#include <cmath>

class FinancialCalculator {
public:
    static double calculateCompoundInterest(
        double principal,
        double rate,
        int years,
        int compoundFrequency = 1
    ) {
        return principal * std::pow(
            1 + (rate / compoundFrequency),
            compoundFrequency * years
        );
    }
};

int main() {
    double principal = 10000.0;
    double annualRate = 0.05;
    int years = 5;

    double finalAmount = FinancialCalculator::calculateCompoundInterest(
        principal, annualRate, years
    );

    std::cout << std::fixed << std::setprecision(2);
    std::cout << "初始投资:$" << principal << std::endl;
    std::cout << "最终金额:$" << finalAmount << std::endl;

    return 0;
}
人口增长建模
指数模型也常用于增长预测。下面这个例子按年计算人口变化,核心仍然是 std::pow(1 + growthRate, year)。
#include <iostream>
#include <vector>
#include <cmath>

class PopulationModel {
public:
    static std::vector<double> exponentialGrowth(
        double initialPopulation,
        double growthRate,
        int years
    ) {
        std::vector<double> population(years + 1);
        population[0] = initialPopulation;

        for (int year = 1; year <= years; ++year) {
            population[year] = initialPopulation *
                std::pow(1 + growthRate, year);
        }

        return population;
    }
};

int main() {
    double initialPopulation = 1000.0;
    double growthRate = 0.02;
    int projectionYears = 10;

    auto populationProjection = PopulationModel::exponentialGrowth(
        initialPopulation, growthRate, projectionYears
    );

    for (int year = 0; year < populationProjection.size(); ++year) {
        std::cout << "第 " << year
                  << " 年:" << populationProjection[year] << std::endl;
    }

    return 0;
}
加密密钥生成示例
在密码学相关场景里,指数运算也很常见。原文给出了一个模拟性的基于质数的密钥生成示例:
#include <iostream>
#include <cmath>
#include <random>

class CryptographicKeyGenerator {
public:
    static long long generatePrimeBasedKey(
        int complexity,
        int basePrime = 2
    ) {
        // 模拟基于质数的密钥生成
        return std::pow(basePrime, complexity) +
               std::pow(basePrime, complexity - 1);
    }
};

int main() {
    int keyComplexity = 10;
    long long secureKey = CryptographicKeyGenerator::generatePrimeBasedKey(
        keyComplexity
    );

    std::cout << "生成的密钥:" << secureKey << std::endl;
    return 0;
}
需要说明的是,这段代码更偏演示用途,重点在说明指数运算如何参与组合计算,而不是一个可直接用于生产环境的加密实现。
常见应用领域一览
| 领域 | 应用 | 计算类型 |
|---|---|---|
| 金融 | 复利 | 连续复利 |
| 生物学 | 人口增长 | 指数模型 |
| 物理学 | 放射性衰变 | 衰变计算 |
| 计算机科学 | 算法复杂度 | 计算规模 |
落地时还要看性能与精度
- 对于大型计算使用合适的数据类型。
- 对潜在的溢出实现错误检查。
- 考虑算法的计算复杂度。
总结:先按场景选方案,再谈优化
C++ 里的指数计算并不只有 std::pow() 这一种做法。整数幂、浮点幂、性能敏感路径和编译期常量,分别对应不同实现;真正实用的关键,不是背下所有代码,而是知道什么时候该优先选标准库,什么时候该切换到快速幂,什么时候必须把精度和溢出检查放在前面。









