

Python矩阵输出挤在一行怎么办?

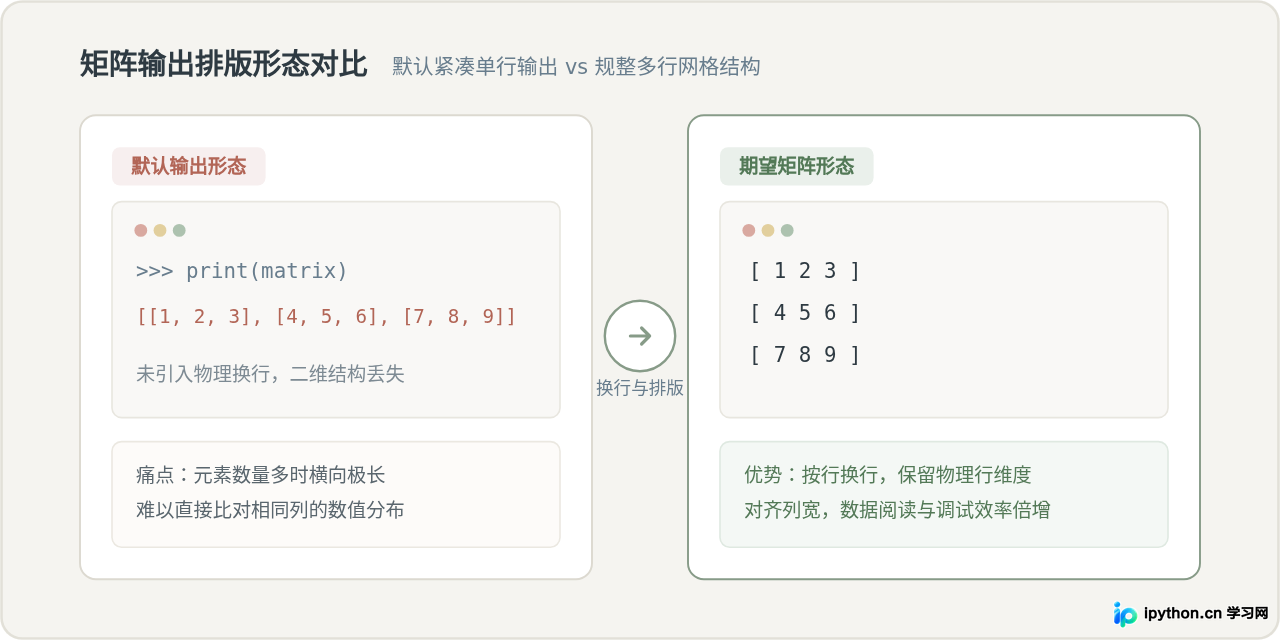
在 Python 中输出矩阵时,许多初学者会发现所有元素全部连成一行长长的文本,无法体现行与列的二维空间结构。导致这一现象的核心原因非常直观:直接调用 print(matrix) 打印原生嵌套列表时,Python 仅调用其内部的字符串表示方法,默认以紧凑单行格式呈现;若使用循环自定义打印,则往往是在内层循环指定了不换行参数后,漏掉了外层循环的换行触发语句;而在使用科学计算库时,也可能因数组维度退化或控制台打印宽度配置不当引发折行混乱。针对不同场景,只需补充行级循环、规范 print() 换行逻辑或配置库内置排版参数,即可获得清晰规整的矩阵输出。
一、排查矩阵输出挤在一行的基本路径
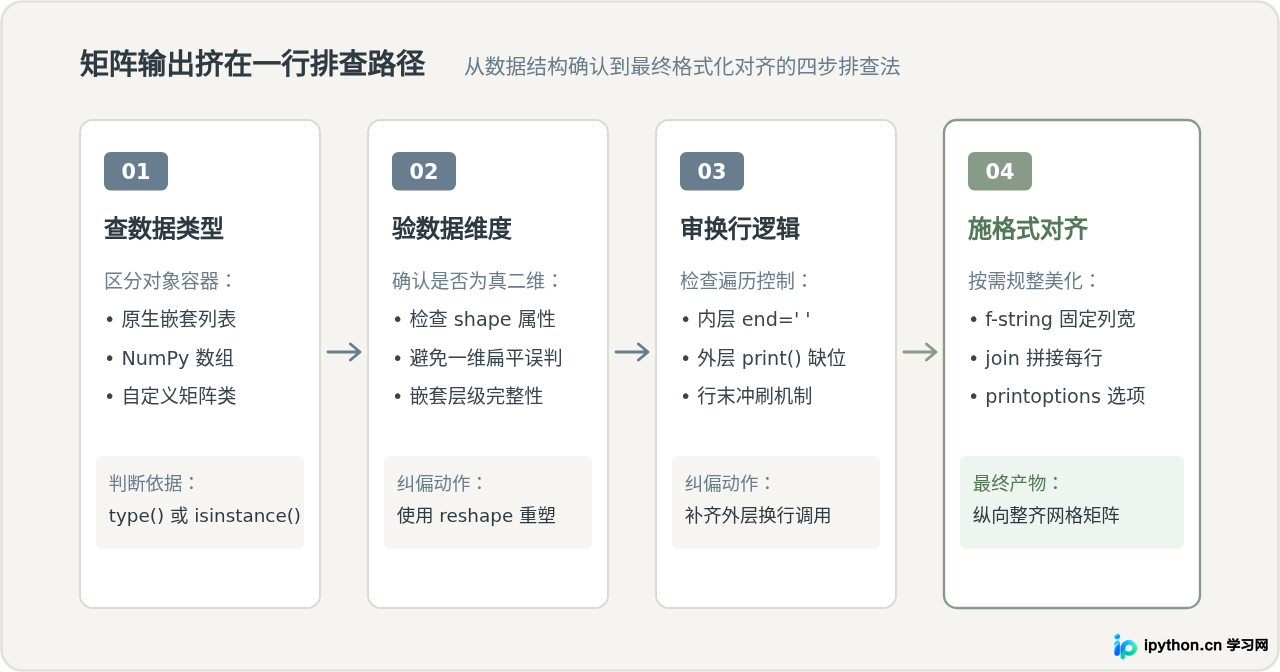
排查矩阵排版异常时,应当按照固定的逻辑顺序核实对象类型与换行逻辑。盲目使用字符串替换往往会破坏数据内部格式,按照“查类型、验维度、审逻辑、施对齐”四个阶段逐步操作,可以迅速锁定问题根源并采用最合适的解决代码。
二、原生嵌套列表直接打印导致单行挤压
在 Python 中,内置列表(list)并不是专门为数值矩阵计算设计的容器。当创建一个二维嵌套列表并执行 print(matrix) 时,标准输出会调用整个列表对象的 __repr__ 字符串转换逻辑。该机制会将外层列表及其内部所有子列表直接串接为纯文本,并不包含任何换行字符 \n。
# 场景复现:直接打印二维列表
matrix = [
    [1, 2, 3],
    [4, 5, 6],
    [7, 8, 9]
]
print(matrix)

# 示例输出:
# [[1, 2, 3], [4, 5, 6], [7, 8, 9]]
针对这一情况,最直接的解法是利用 for 循环按行遍历,让每一行拥有独立的 print() 调用:
# 解决方案 A:基础逐行打印
for row in matrix:
    print(row)

# 示例输出:
# [1, 2, 3]
# [4, 5, 6]
# [7, 8, 9]
虽然逐行遍历解决了行换行的问题,但如果矩阵中的数值位数不统一(例如有的数字是个位数,有的是百位数),列表自带的方括号和逗号仍然会让各列错位。此时可以结合字符串格式化方法,剔除括号并强制设置统一列宽:
# 解决方案 B:基于 f-string 的网格对齐打印
matrix_irregular = [
    [12, 3, 456],
    [7, 89, 1],
    [234, 5, 67]
]

for row in matrix_irregular:
    # 每个数值固定占用 6 个字符宽度,默认右对齐
    print(" ".join(f"{val:>6}" for val in row))

# 示例输出:
#     12      3    456
#      7     89      1
#    234      5     67
三、双层循环中换行控制丢失的原因与机制
许多开发者在尝试去除方括号时,会选择使用嵌套循环输出每个元素。在这一过程中最常见的错误,是为内层循环设置了 end=" " 或 end="\t",却在内层结束后遗漏了外层行的换行操作。
Python 的内置函数 print() 默认参数为 end="\n",每次执行完毕都会向控制台发送换行符。当为了保持同一行元素连续而将内层改为 end=" " 后,光标在打印完当前子列表后仍然停留在当前行末尾。如果不显式执行换行,下一行的第一个元素就会紧接着上一行的最后一个元素继续输出,最终所有元素依然完全挤在同一行。
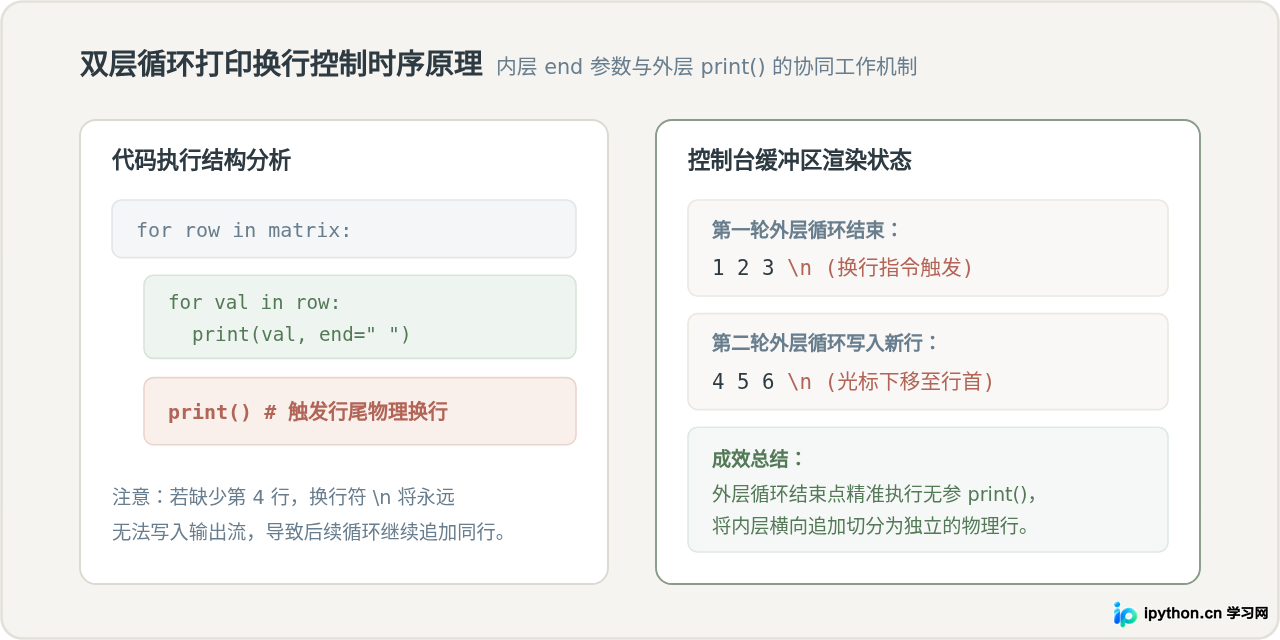
正确的双层嵌套打印实现如下,关键点在于外层循环每结束一次,就必须执行一次无参数的 print():
# 嵌套循环的标准安全写法
matrix = [
    [1, 2, 3],
    [4, 5, 6],
    [7, 8, 9]
]

for row in matrix:
    for val in row:
        # 内层使用固定宽度输出,且不自动换行
        print(f"{val:>4}", end="")
    # 核心步骤:每行元素遍历完成后,立即刷新换行
    print()

# 示例输出:
#    1   2   3
#    4   5   6
#    7   8   9
四、NumPy 矩阵输出排版与控制台配置
在涉及科学计算时,通常会采用 numpy.ndarray 对象。NumPy 本身对矩阵的 __str__ 进行了深度优化,默认情况下二维数组能够以多行形式输出。但在两种典型情况下,NumPy 矩阵也会出现“挤在一行”或折行失控的现象:
- 维度退化为一维(形状为
(N,)):如果数组在切片、拼接或初始化时不小心被扁平化,它在逻辑上已不再是二维矩阵,打印出来自然是一整行。此时需检查arr.shape,并通过reshape(rows, cols)恢复其二维几何结构。 - 控制台输出宽度参数受限:当矩阵列数较多时,NumPy 默认会根据
linewidth参数判断是否超出终端宽度。若单行字符数超限,它会在中间强行拆断折行;反之,若终端配置过宽或过窄,也可能出现排版拥挤。
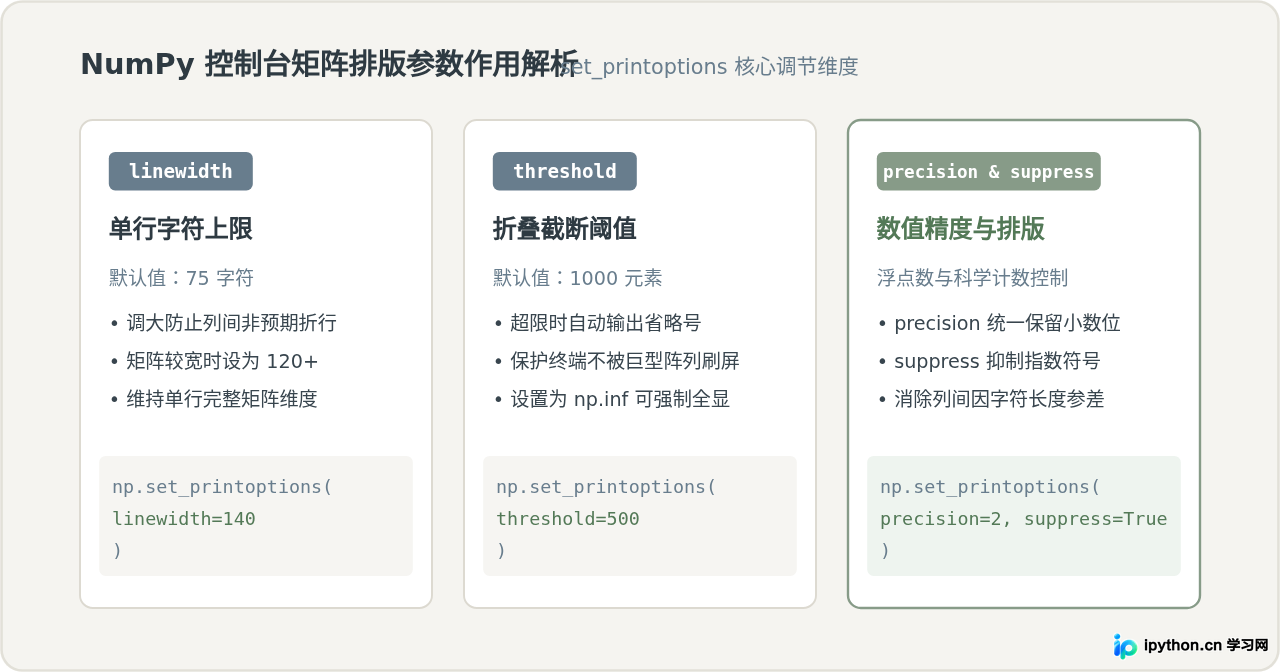
NumPy 数组的排版调整示例:
import numpy as np

# 1. 确保数据是规范的二维矩阵结构
flat_arr = np.array([1, 2, 3, 4, 5, 6, 7, 8])
matrix_2d = flat_arr.reshape(2, 4)

# 2. 调整 NumPy 全局输出排版策略
np.set_printoptions(
    linewidth=120,   # 防止宽列矩阵折行
    precision=2,     # 保留两位小数
    suppress=True    # 禁用科学计数法
)

print(matrix_2d)

# 示例输出:
# [[1 2 3 4]
#  [5 6 7 8]]
五、原生逐行格式化与 NumPy 全局排版的关键差异
在相同的二维数据处理场景下,选择“原生循环格式化”还是“NumPy 内置配置”会带来完全不同的运行影响。明确这两者的适用差异对于构建稳定程序至关重要:
| 比对维度 | 原生循环与字符串格式化 | NumPy 打印选项控制 |
|---|---|---|
| 环境依赖 | 零外部依赖,纯内置语法,任意标准 Python 环境均可运行 | 必须安装并导入 NumPy 第三方库 |
| 列对齐灵活性 | 极高。可通过 f-string 自定义任意左右对齐、前缀填充或分隔符 | 受内置 formatter 约束,主要支持标准数值网格排版 |
| 大矩阵表现 | 若全量打印将生成海量输出流,容易拖慢终端甚至导致界面卡死 | 内置 threshold 自动折叠,仅输出首尾两端,具备天然的保护机制 |
| 生效范围 | 仅在执行该段循环代码时生效,作用域局部受控 | set_printoptions 会影响当前解释器进程内的全局输出行为 |
for 循环结合 join 和 f-string 是最轻量、直观的做法,无需引入重型依赖;但如果面对的是大规模科学计算或神经网络权重调试,强行用原生循环打印巨型矩阵会导致终端瞬间被几万行字符淹没,此时必须依赖 NumPy 的维度折叠机制进行排版。
六、方案选择与最佳实践总结
处理 Python 矩阵输出挤在一行的问题,不应盲目套用代码,而需根据具体业务场景选择对应手段:
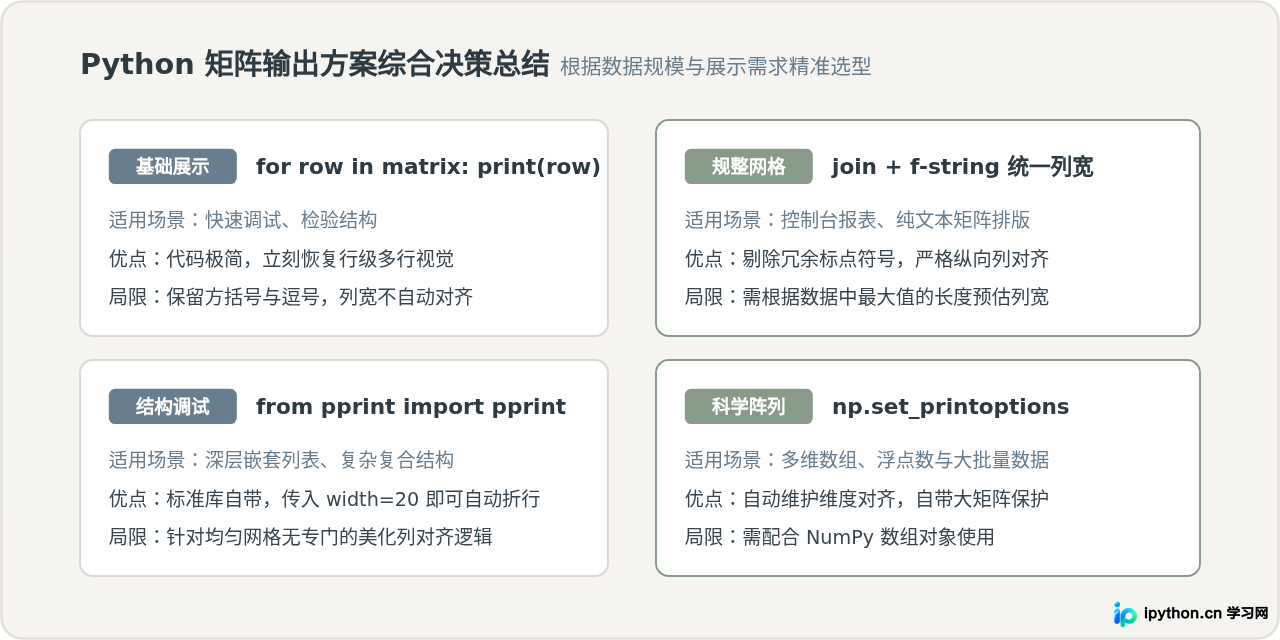
针对深层嵌套列表,如果不希望手动编写格式化循环,还可以直接借助 Python 标准库中的 pprint 模块:
from pprint import pprint

matrix = [
    [10, 20, 30, 40],
    [50, 60, 70, 80],
    [90, 100, 110, 120]
]

# 设置较小的单行输出宽度阈值,强制触发按行分行输出
pprint(matrix, width=25)

# 示例输出:
# [[10, 20, 30, 40],
#  [50, 60, 70, 80],
#  [90, 100, 110, 120]]
综上所述,Python 矩阵输出挤在一行并不是语言缺陷,而是标准输出机制对线性字符流与容器表示方式的自然呈现。在日常开发中,只需通过逐行遍历、显式补齐外层换行、利用 f-string 规整列宽或调用科学计算库的排版参数,即可轻松构建出清晰美观的二维矩阵输出。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









