

Python读取xls文件出现中文乱码怎么解决

在 Python 中读取 .xls 格式文件出现中文乱码,绝大多数情况是因为老版 Excel 97-2003 二进制文件内部缺失了代码页(Codepage)标记,导致解析库默认回退到了西文字符集,或者该文件本质上是伪装成 xls 的 HTML、CSV 文本。最直接有效的解决办法是在使用 xlrd 打开工作簿时显式传入 encoding_override='cp936' 参数,若遇到伪 xls 则需先通过文件头嗅探实际格式再采用对应的解析器。
一、中文乱码产生的原因与机制分析
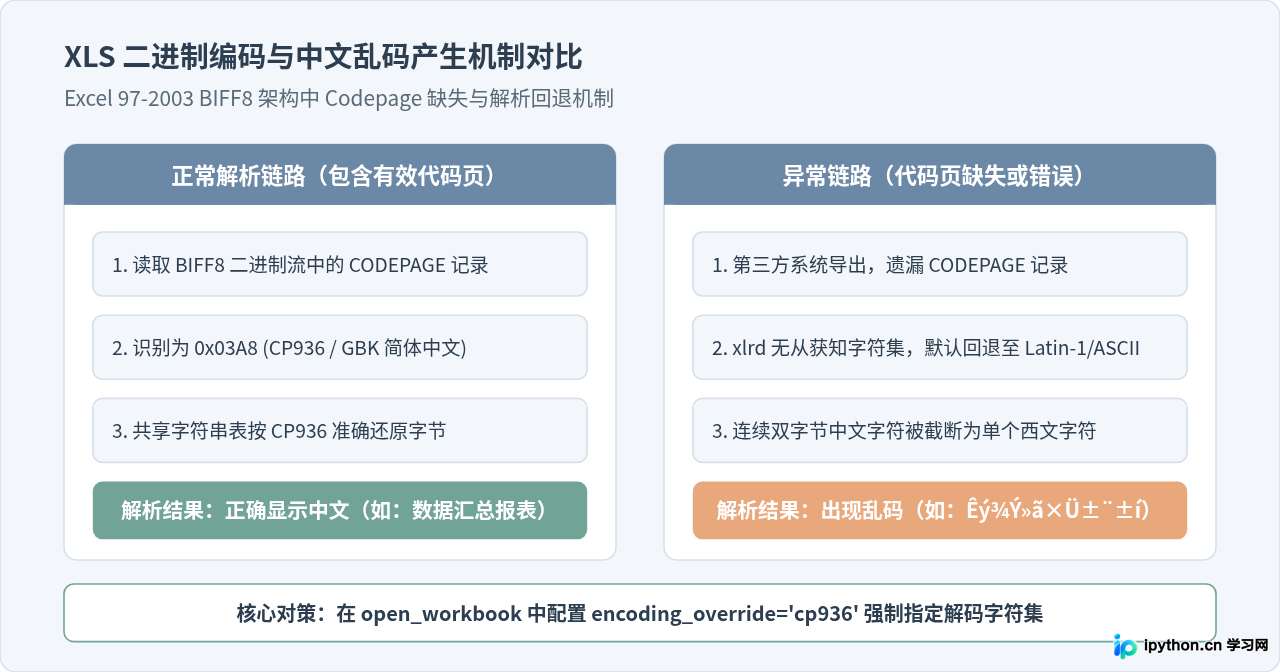
.xls 是微软早期的 BIFF8(Binary Interchange File Format)复合二进制文档结构。与基于 XML 压缩包的现代 .xlsx 格式不同,BIFF8 文件内部使用专门的字符串表(Shared String Table)来存储文本数据。在标准格式规范中,工作簿文件头应包含一个名为 CODEPAGE 的记录块,用来告诉解析程序该文档中的非 Unicode 字符串应当使用哪种字符集解码。
但在实际业务中,许多中文环境下的 .xls 文件是由旧版 OA、ERP 或第三方导出组件自动生成的。这些生成工具往往省略了 CODEPAGE 记录,或者写入了错误的代码页标记。Python 中最常用的 xls 解析库 xlrd 在遇到没有声明代码页的文件时,会默认按照 ascii 或 latin-1 规则解码,这就导致多字节的中文字符被切碎并解释为西文字符,从而呈现为常见形如 这、ÄãºÃ 或一连串问号的乱码。
二、主要解决路径与完整代码实现
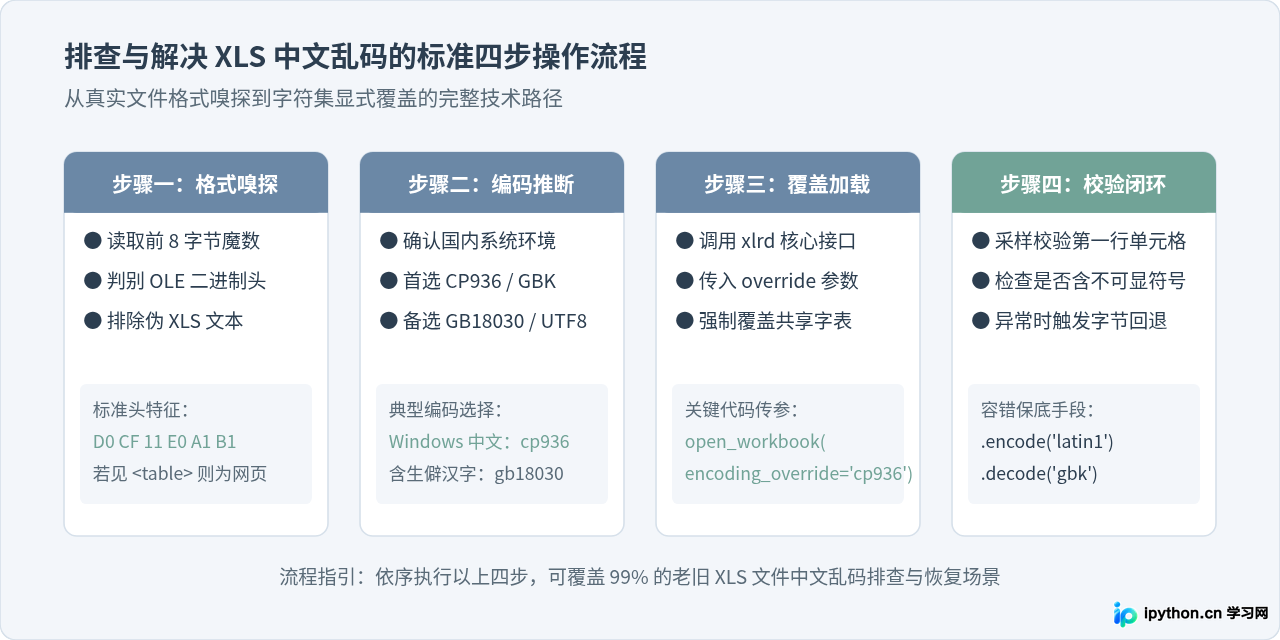
明确了乱码成因后,解决问题应当遵循从文件真伪排查、参数覆盖到结果校验的标准化步骤。以下梳理具体的操作顺序与对应实现。
1. 最常用解决手段:使用 xlrd 的 encoding_override 参数
对于真正的 BIFF8 二进制 XLS 文件,最标准的解决方式是直接在 xlrd.open_workbook 函数中传递 encoding_override 参数。这会强行覆盖文件内损坏或遗漏的 Codepage 设置,使字符串解析器直接使用我们指定的编码。
import xlrd

def read_xls_with_override(file_path):
    # 显式指定编码为 cp936(兼容 GBK),解决老旧系统未声明代码页的问题
    workbook = xlrd.open_workbook(file_path, encoding_override="cp936")
    sheet = workbook.sheet_by_index(0)

    print(f"工作表名称: {sheet.name}")
    print(f"总行数: {sheet.nrows}, 总列数: {sheet.ncols}")

    # 读取第一行表头进行验证
    header = [sheet.cell_value(0, col_idx) for col_idx in range(sheet.ncols)]
    print("表头内容:", header)
    return sheet

# 调用示例
# read_xls_with_override("sales_report_2003.xls")注意事项:如果目标文件中包含生僻字(如古汉语人名、生僻地名),可将参数调整为 encoding_override="gb18030"。如果源系统是在现代 Linux/macOS 环境下用纯 UTF-8 写入但误标了老版格式,也可以尝试 encoding_override="utf-8"。
2. 识别与处理“伪 XLS”文件(HTML 或 CSV 改后缀)
许多所谓的 .xls 乱码,其实并不是编码解析错误,而是文件格式根本就不是真正的 Excel 二进制文件。在许多 Web 管理后台中,开发者为了“简便”,直接将动态生成的 HTML <table> 或纯文本 CSV 文件保存为 .xls 后缀供用户下载。Excel 软件能够根据内容自动兼容打开,但 Python 的二进制解析器则会解析失败或产生大面积乱码。
排查的第一步是读取文件的头部前 8 个字节进行魔数验证:真正的 BIFF8 文件以 0xD0, 0xCF, 0x11, 0xE0, 0xA1, 0xB1, 0x1A, 0xE1 开头;HTML 伪文件以 <html 或 <!DOCTYPE、<table 开头;CSV 伪文件则直接是纯文本。
import pandas as pd

def inspect_and_read_xls(file_path):
    # 读取前 16 字节判断文件真实特征
    with open(file_path, "rb") as f:
        head = f.read(16)

    # 标准 OLE 复合文档头(真实 xls)
    if head.startswith(b"\xd0\xcf\x11\xe0\xa1\xb1\x1a\xe1"):
        print("检测到真实 BIFF8 二进制 XLS,使用 xlrd 引擎读取")
        import xlrd
        wb = xlrd.open_workbook(file_path, encoding_override="cp936")
        sheet = wb.sheet_by_index(0)
        data = [[sheet.cell_value(r, c) for c in range(sheet.ncols)] for r in range(sheet.nrows)]
        return pd.DataFrame(data[1:], columns=data[0])

    # 检测是否为 HTML 表格伪装的 XLS
    head_text = head.decode("ascii", errors="ignore").lower()
    if "<html" in head_text or "<!doc" in head_text or "<tabl" in head_text:
        print("检测到该文件为 HTML 表格伪装的 XLS,采用 read_html 解析")
        # 根据实际情况尝试 utf-8 或 gbk
        tables = pd.read_html(file_path, encoding="utf-8")
        return tables[0]

    # 检测是否为纯文本 CSV 伪装的 XLS
    print("未匹配到二进制头,尝试作为文本 CSV 读取")
    try:
        return pd.read_csv(file_path, encoding="gbk")
    except UnicodeDecodeError:
        return pd.read_csv(file_path, encoding="utf-8")
3. 已被错误解码为字符串后的“回退重解”恢复技巧
如果数据已经被某个第三方库或上游流程用 latin-1(ISO-8859-1)强行读取,在内存中变成了类似 这一 的乱码字符串对象,此时重新读取文件可能成本较高。只要原字节在 latin-1 转换过程中没有发生字节丢失,就可以通过“先编码回原始字节、再用正确字符集解码”的方式逆向恢复:
def recover_garbled_string(text, source_encoding="latin1", target_encoding="gbk"):
    try:
        raw_bytes = text.encode(source_encoding)
        return raw_bytes.decode(target_encoding)
    except (UnicodeEncodeError, UnicodeDecodeError):
        # 若转码失败则原样返回
        return text

# 示例:将误用 latin1 解码的 GBK 中文还原
garbled_sample = "ÄãºÃ"  # "你好" 的 GBK 字节被当作 latin-1 打印出的表现
recovered = recover_garbled_string(garbled_sample, source_encoding="latin1", target_encoding="gbk")
print("恢复结果:", recovered)  # 输出:你好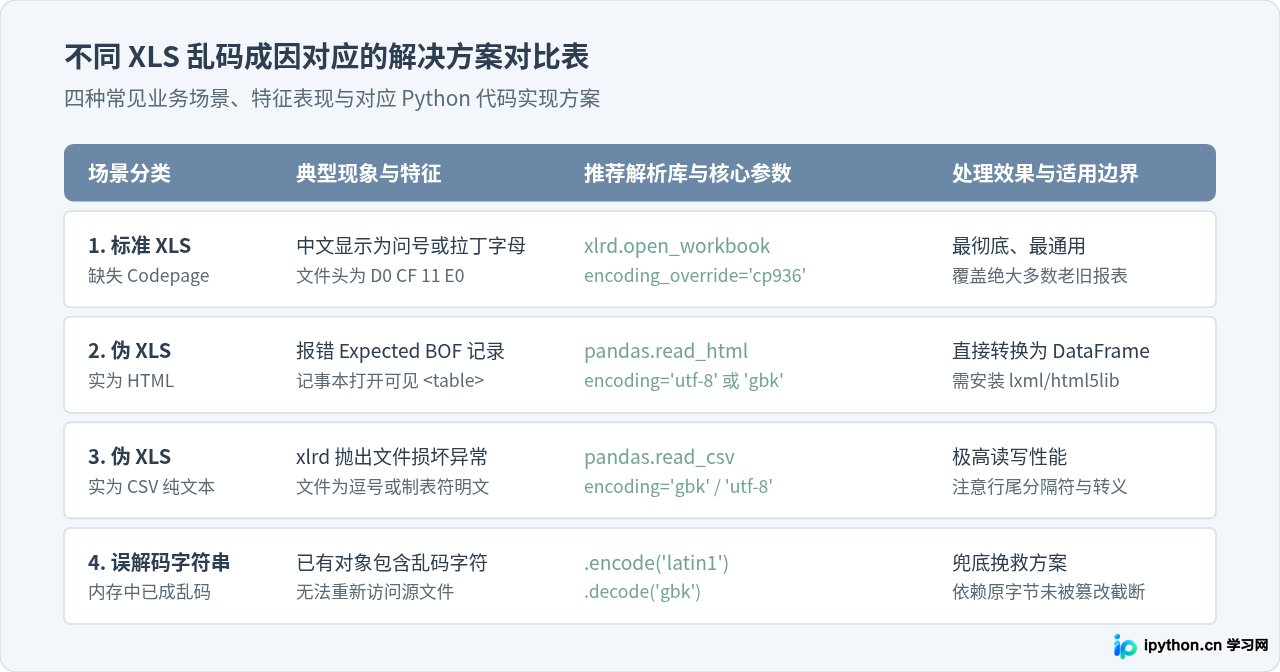
三、环境依赖与常见陷阱排查
在实施上述解决方案时,还需要注意 Python 环境中相关依赖库的版本变动与平台差异:
- xlrd 版本的关键变动:官方
xlrd在发布 2.0.0 版本后,主动移除了对.xlsx格式的支持,仅保留了对老版.xls的解析能力。处理.xls时使用最新的xlrd 2.0.1完全没有问题,但不能用它去读取.xlsx。 - Pandas 的 engine 参数指定:在 Pandas 1.2+ 及更高版本中,若调用
pd.read_excel('file.xls'),Pandas 默认会使用xlrd作为解析引擎。如果直接读取发生乱码,由于 Pandas 的read_excel并不直接向外暴露encoding_override参数,推荐先使用原生xlrd.open_workbook(..., encoding_override='cp936')读取出矩阵数据,再构造成 DataFrame。 - 生僻字与特殊符号截断:标准的
GBK字符集共收录约 2.1 万个汉字,而GB18030收录了超过 7 万个汉字及少数民族文字。如果读取包含少数民族姓名或生僻地名的档案时出现局部乱码或抛出UnicodeDecodeError,务必将覆盖编码调整为gb18030。
.xls 文件统一批量转换为现代的标准 .xlsx(基于 UTF-8 XML)或 .parquet 文件存储,从根本上杜绝旧式字符集声明缺失带来的隐患。
四、全流程排查总结与决策树
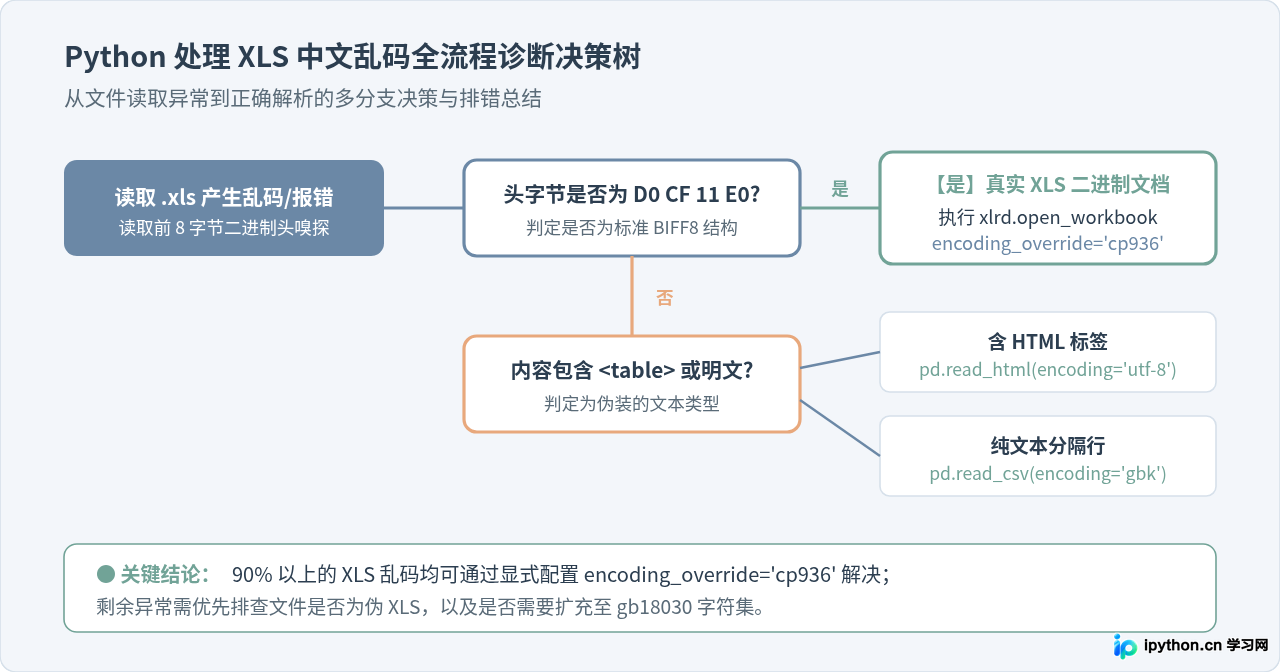
面对一个给定的出现乱码或报错的 .xls 文件,可以通过以下系统化的决策逻辑快速定位处理方案:
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









