

Python判断列表或字典中是否包含指定元素

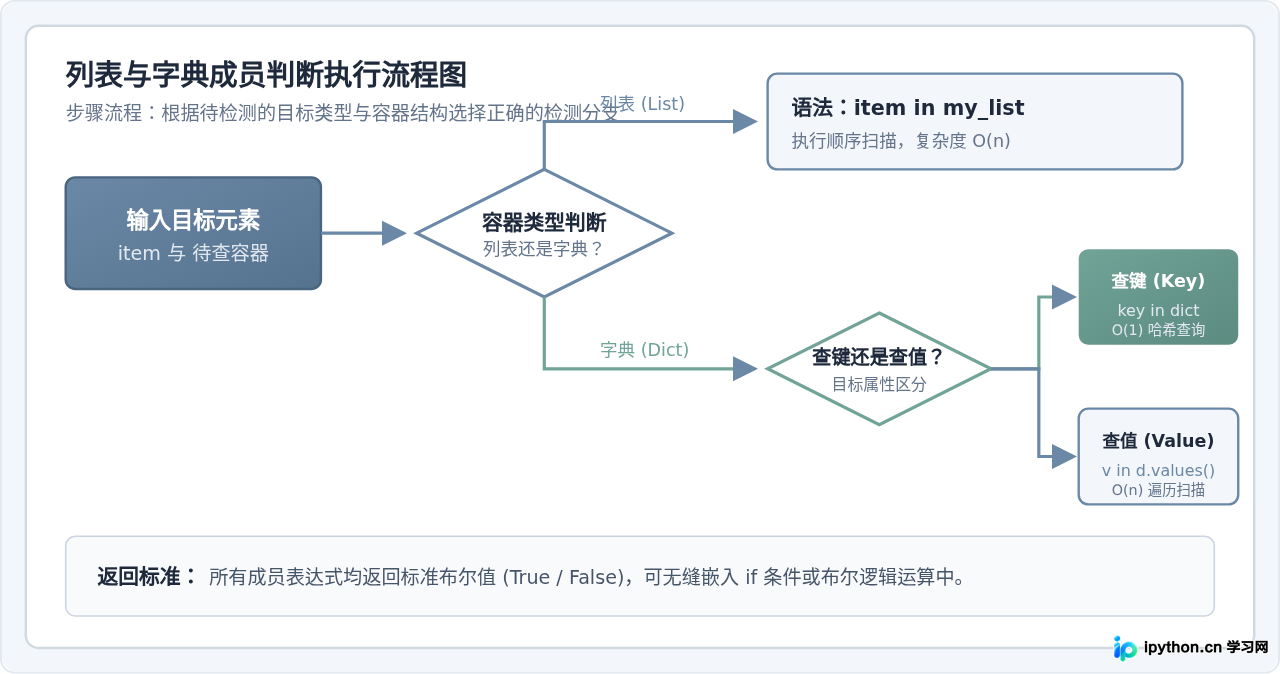
在 Python 中,判断列表或字典中是否存在某个元素的核心方法是使用成员运算符 in 与 not in。对于列表,item in my_list 直接按值检索;对于字典,默认的 key in my_dict 用于高效检测键是否存在,若需检测值则显式调用 value in my_dict.values()。
一、列表(List)中判断元素是否存在
列表是 Python 中最常用的有序序列。判断指定元素是否存在于列表中,最直接、最符合 Python 习惯的写法就是使用 in 运算符。
1. 基础判断语法与示例
当元素存在于列表中时,in 表达式返回 True,否则返回 False;配合 not in 可以直接判断元素是否不存在:
# 示例:判断水果列表中是否存在指定项目
fruits = ["apple", "banana", "orange", "grape"]

target = "banana"
if target in fruits:
    print(f"列表中包含元素: {target}")
else:
    print(f"列表中未找到元素: {target}")

# 使用 not in 进行反向判断
if "watermelon" not in fruits:
    print("西瓜不在采购列表中")
示例输出:
列表中包含元素: banana
西瓜不在采购列表中
2. 其他辅助方法与适用边界
除了布尔判断外,有时读者还需要获取元素出现的频次或具体索引位置:
my_list.count(target):统计元素出现的总次数。若返回值大于 0,则说明元素存在。my_list.index(target):返回指定元素第一次出现的下标。若元素不存在,该方法会抛出ValueError,因此必须配合try...except结构使用。
二、字典(Dictionary)中判断键(Key)是否存在
字典是由键值对(Key-Value)组成的映射结构。在绝大多数业务场景下,我们所谓的“字典中是否包含指定元素”,实际指的是“字典中是否存在指定键”。
1. 标准推荐写法:key in my_dict
在 Python 中,直接对字典变量执行 in 运算,默认就是检测给定的键是否存在。这是最地道、可读性最好且执行效率最高的写法:
# 示例:检测用户信息字典中是否存在关键字段
user_profile = {
    "username": "alex_99",
    "email": "alex@example.com",
    "role": "admin"
}

# 推荐:直接在字典中判断键
if "email" in user_profile:
    print(f"邮箱配置存在: {user_profile['email']}")

if "phone" not in user_profile:
    print("未绑定手机号码")
示例输出:
邮箱配置存在: alex@example.com
未绑定手机号码
2. 常见写法对比与误区
许多初学者或从其他语言转来的开发者容易采用以下两种写法,需要注意它们的适用场景与潜在问题:
key in user_profile.keys():在 Python 3 中,.keys()返回的是一个字典视图对象(dict_keys)。该视图底层依旧使用哈希表,因此时间复杂度仍是 O(1),但它会带来多余的属性查找与方法调用开销,属于非必要的冗余写法。user_profile.get(key) is not None:使用.get()方法虽然也能安全取值,但当字典中的键本身对应的值就是None时(例如{"phone": None}),该判断逻辑会出现误判。因此,严谨的成员存在性检查应始终优先采用in运算符。
三、字典中判断值(Value)与键值对(Item)是否存在
虽然默认的 in 作用于键,但在数据处理过程中,我们经常需要判断某个具体的“值”或者“键值组合”是否存在于字典中。
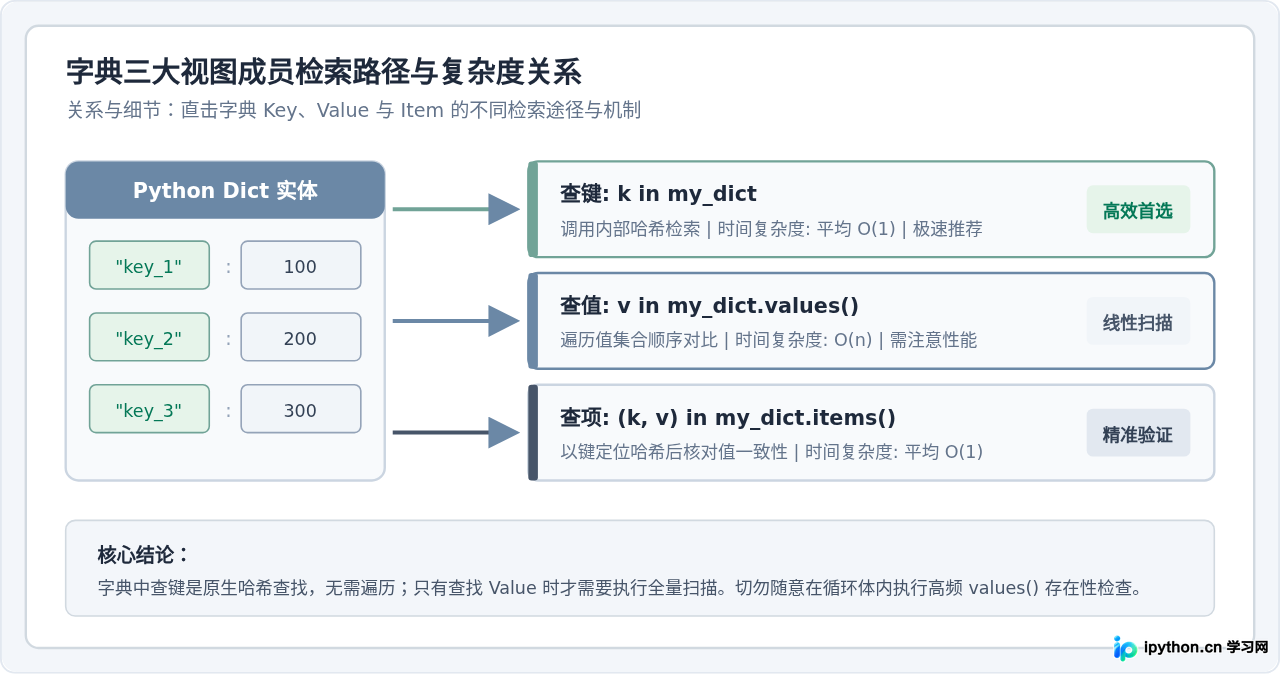
1. 判断值是否存在:value in my_dict.values()
要判断字典中是否包含指定的值,必须显式调用 .values() 方法获取值视图:
# 示例:检测成绩字典中是否存在及格分或满分
scores = {
    "math": 95,
    "english": 88,
    "physics": 100
}

# 判断是否存在满分 100 分
if 100 in scores.values():
    print("存在获得满分 100 的科目!")

if 60 not in scores.values():
    print("没有刚好考 60 分的科目")
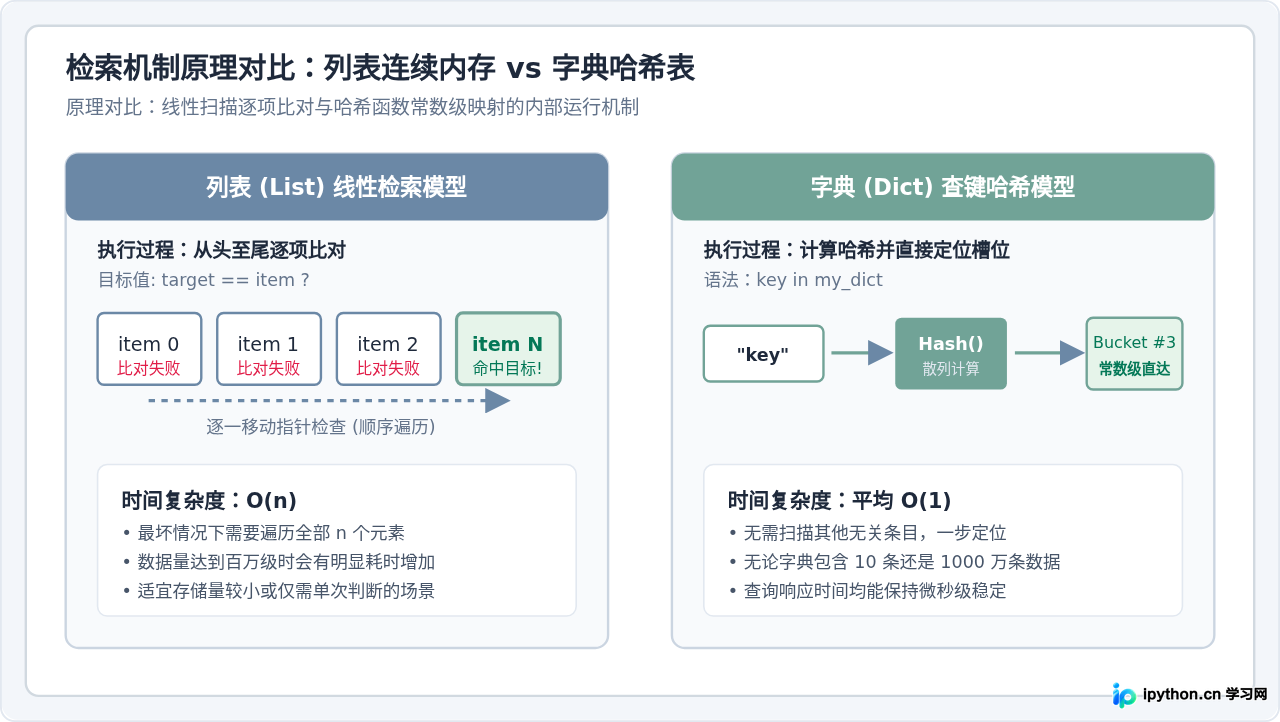
注意性能差异:与查键的 O(1) 不同,字典的值是没有建立哈希索引的。因此执行 val in my_dict.values() 时,底层会对所有值进行线性遍历,其时间复杂度退化为 O(n)。如果在超大字典中需要频繁查值,建议在外部构建双向映射或反向查找表。
2. 判断完整键值对:(k, v) in my_dict.items()
若需要同时验证某个特定的键是否对应着特定的值,可以使用 .items() 视图:
# 示例:检查配置字典中特定键值对是否存在
server_config = {
    "host": "127.0.0.1",
    "port": 8080,
    "debug": True
}

# 检查 ('port', 8080) 这一完整元组
if ("port", 8080) in server_config.items():
    print("服务运行于指定端口 8080")
四、性能瓶颈分析与高频检索优化策略
在小规模数据量(百条以内)下,不同数据结构的查找开销几乎可以忽略不计;但当数据规模增长到成千上万条,并且需要在循环或高并发服务中高频执行判断时,不同数据结构的性能差距将达到数百甚至上千倍。
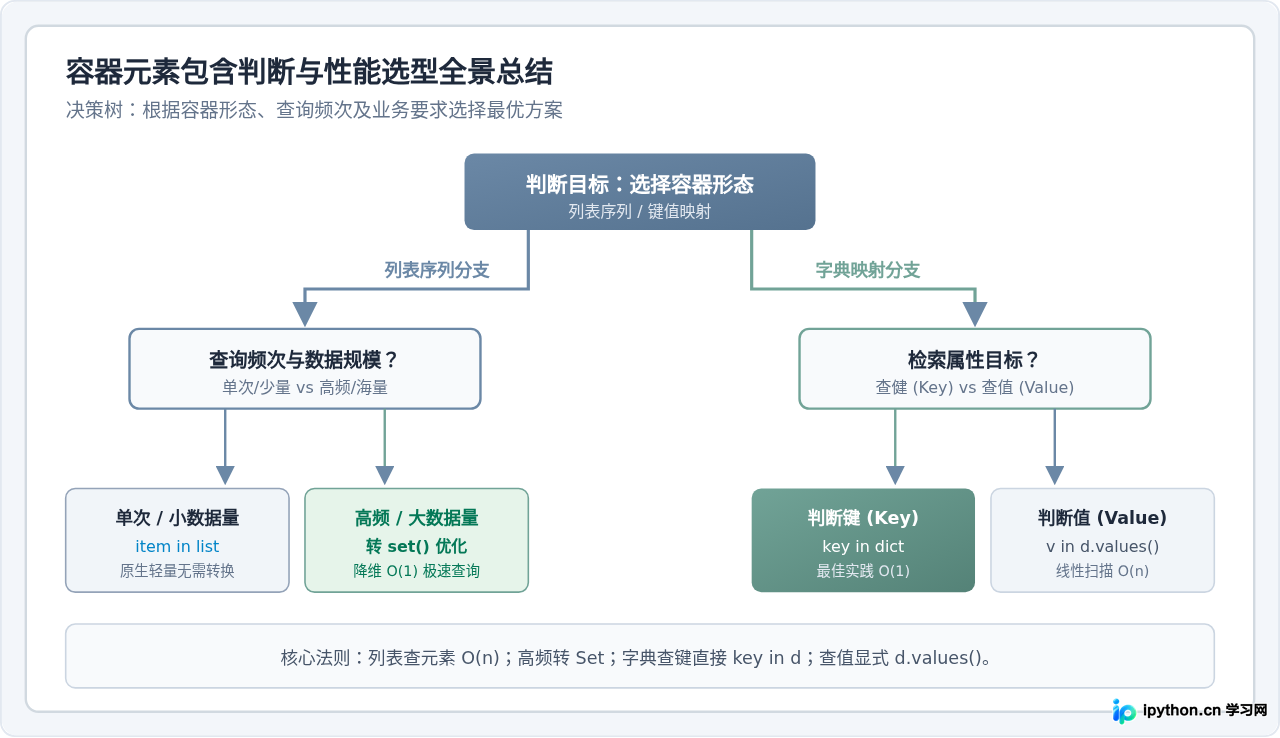
1. 大列表高频查找的性能陷阱与转 Set 优化
假设我们有一个包含 50,000 个元素的黑名单列表,如果每次有新用户请求时都执行 user_id in blacklist_list,程序每秒处理的能力会极其低下。优化方案非常明确:在预处理阶段将列表转换为集合(set)。
# 优化对比演示
# 假设 raw_users 是包含大量数据的列表
raw_users = [f"user_{i}" for i in range(100000)]

# ❌ 不推荐:高频在超大列表中检索 (每次 O(n))
def check_in_list(target):
    return target in raw_users

# ✅ 推荐:转换为 Set 进行哈希存储 (每次 O(1))
users_set = set(raw_users)

def check_in_set(target):
    return target in users_set
2. 各容器成员检测复杂度对比
| 数据结构 | 判断语法 | 平均时间复杂度 | 适用场景与建议 |
|---|---|---|---|
| 列表 (List) | x in my_list |
O(n) | 数据量少、元素有序排列、只需偶尔判断 |
| 元组 (Tuple) | x in my_tuple |
O(n) | 固定不可变数据、内存紧凑 |
| 集合 (Set) | x in my_set |
O(1) | 高频存在性查询、去重集合、大规模数据首选 |
| 字典查键 (Dict Keys) | k in my_dict |
O(1) | 映射结构、直接通过属性名称检索 |
| 字典查值 (Dict Values) | v in my_dict.values() |
O(n) | 偶尔验证某些特定属性值是否存在 |
五、常见问题排查与注意事项
1. 嵌套结构不会自动深度查找
in 运算符仅对当前容器的顶层(一级)元素进行匹配,不会递归深入嵌套的列表或字典内部:
# 嵌套列表的常见误区
nested_list = [[1, 2], [3, 4]]

# ❌ 直接判断内部子元素会返回 False
print(1 in nested_list)  # 输出: False

# ✅ 必须精确匹配子列表对象,或者使用列表推导式
print([1, 2] in nested_list)  # 输出: True
print(any(1 in sub for sub in nested_list))  # 输出: True
2. 相等性比较(==)与对象同一性(is)
in 运算符在底层依赖对象的 __eq__ 方法进行相等性判定。在 Python 中,整数 1 与布尔值 True 在数值比较上是相等的:
bool_list = [1, 2, 3]
# 由于 True == 1 成立,因此这里会返回 True
print(True in bool_list)  # 输出: True
若业务逻辑对数据类型有严苛要求,需在匹配时额外配合 type() 校验。
3. 浮点数 NaN 的特殊性质
在 IEEE 754 浮点标准中,NaN(非数字)与任何值都不相等,包括其自身(即 float('nan') == float('nan') 结果为 False)。如果列表中包含不同实例的 NaN,使用 in 可能会判断失败,此时应借助 math.isnan() 进行判断。
总结
Python 中判断列表或字典包含元素的语法设计非常一致且优雅,主要遵循以下规则:
- 列表判断:统一使用
item in my_list,逻辑清晰直观;对于超大数据量或高频查询任务,优先将列表转换为set提升效率。 - 字典查键:直接使用
key in my_dict,避免编写冗余的.keys(),享受 O(1) 的常数级极速响应。 - 字典查值:显式调用
value in my_dict.values(),并注意其 O(n) 线性扫描特性,防止在性能敏感链路中造成瓶颈。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









