

Python安全拼接URL及处理查询参数的方法

在网络请求与接口对接开发中,构造 URL 是一项高频基础工作。许多初学者习惯直接使用字符串相加或 f-string 拼接路径与参数,这种方式极易引发多斜杠重叠、路径意外覆盖、特殊字符未转义以及潜在的参数注入漏洞。在 Python 中,最安全、标准的解决路径是使用内置库 urllib.parse 中的 urljoin、urlencode 以及 urlsplit/urlunsplit。本文将系统梳理这些方法的核心机制、具体代码实现及避坑要点。
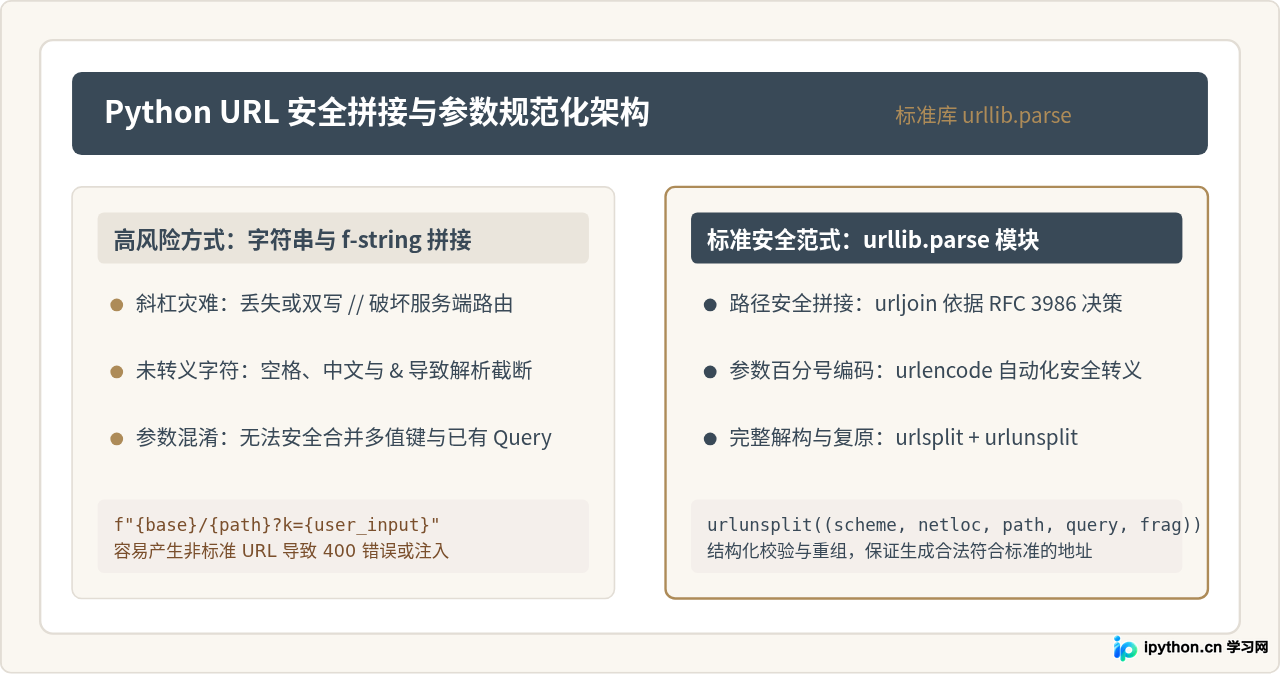
为什么必须避免直接字符串拼接
很多开发者在拼装网络地址时,最直观的写法是 base_url + "/" + path。然而在复杂的生产环境中,这种操作存在显著的边界缺陷:
- 重复斜杠或丢失斜杠:当
base_url已经以/结尾,且path也以/开头时,直接相加会生成https://api.example.com//v1/users,部分严格的反向代理(如 Nginx)会返回重定向或直接报错;反之,若两者都不带斜杠,则会变成错误的路径连接。 - 未编码字符导致解析异常:如果用户查询参数包含空格、特殊标点或中文,未经过百分号编码(Percent-encoding)直接放入 URL,会导致 HTTP 协议解析错误。
- 参数分隔符混淆:若参数值本身含有
&或=,字符串拼接会使其直接暴露为 URL 的语法标记,导致参数结构被破坏,严重时造成参数注入风险。
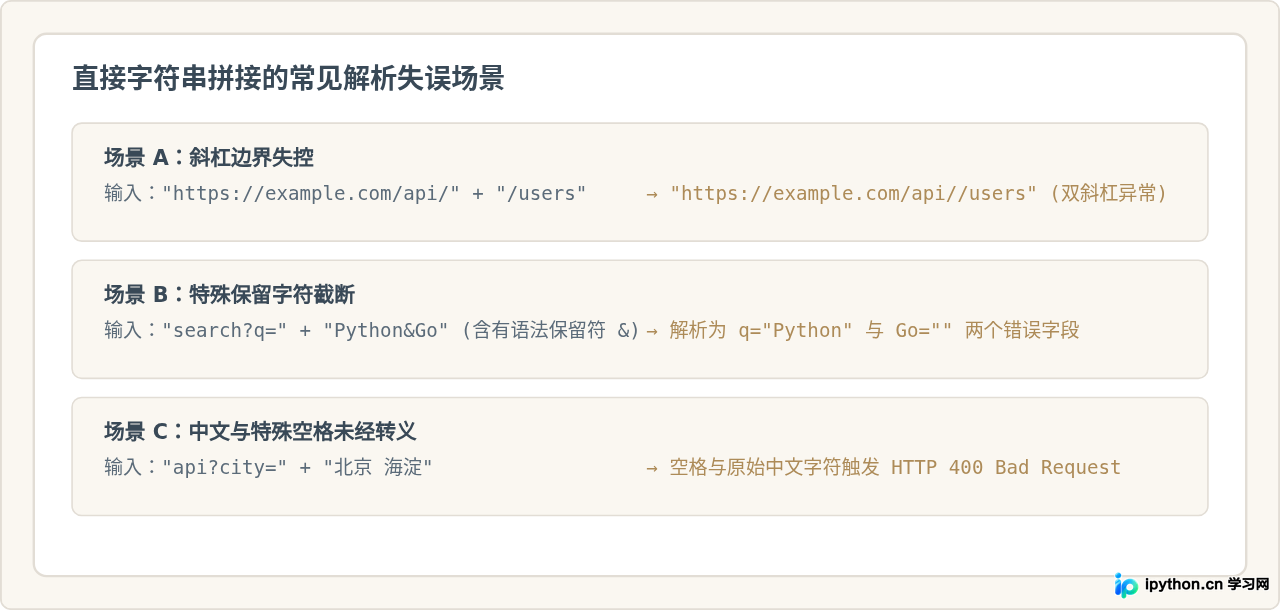
使用 urljoin 进行路径安全拼接
标准库中的 urllib.parse.urljoin 严格遵循 RFC 3986 规范,模拟浏览器解析相对超链接的逻辑来合并 URL。要准确使用该函数,必须理解其路径判断的核心规则:
- 基础路径末尾斜杠至关重要:若
base为"https://example.com/v1"(无末尾斜杠),解析器会将v1视为文件名,拼接"users"时会替换该层,变成"https://example.com/users"。若要保留v1作为目录,必须以斜杠结尾:"https://example.com/v1/"。 - 相对路径不可随意加前导斜杠:若待拼接的相对路径以
/开头(例如"/users"),它会被视作绝对路径,从而直接覆盖根目录以外的所有层级,生成"https://example.com/users"。
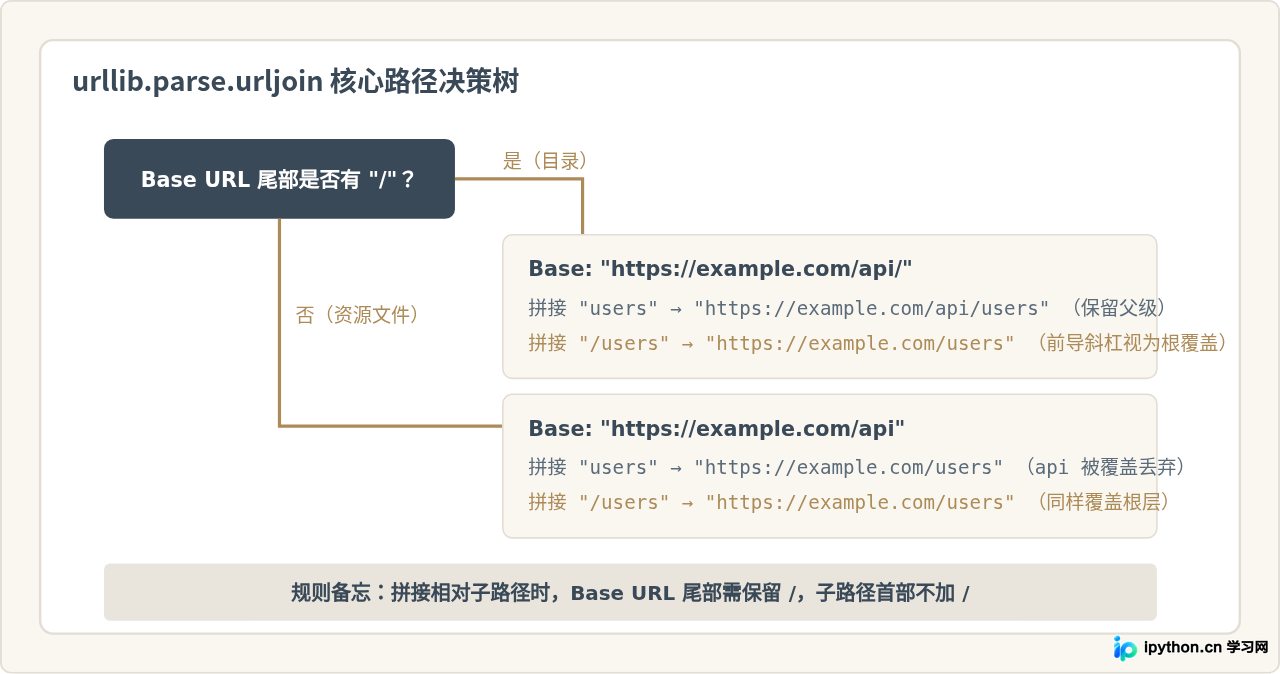
下面是使用 urljoin 安全组装各级路径的示范代码:
from urllib.parse import urljoin

base_endpoint = "https://api.example.com/v2/"

# 正确示范:基础路径有尾部斜杠,子路径无首部斜杠
resource_url = urljoin(base_endpoint, "users")
print(resource_url)
# 输出: https://api.example.com/v2/users

# 多段路径的安全拼接处理
def join_url_paths(base: str, *paths: str) -> str:
    result = base.rstrip("/") + "/"
    for p in paths:
        clean_p = p.strip("/")
        if clean_p:
            result = urljoin(result, clean_p + "/")
    return result.rstrip("/")

full_path = join_url_paths("https://api.example.com", "v2", "teams", "billing")
print(full_path)
# 输出: https://api.example.com/v2/teams/billing
处理查询参数:使用 urlencode 规范化编码
处理 GET 请求或动态 URL 中的参数时,核心工具是 urllib.parse.urlencode。它能自动将键值对编码为标准的 application/x-www-form-urlencoded 格式,将非安全字符安全转义为百分号序列(例如空格编码为 + 或 %20,中文编码为 UTF-8 字节的百分号组合)。
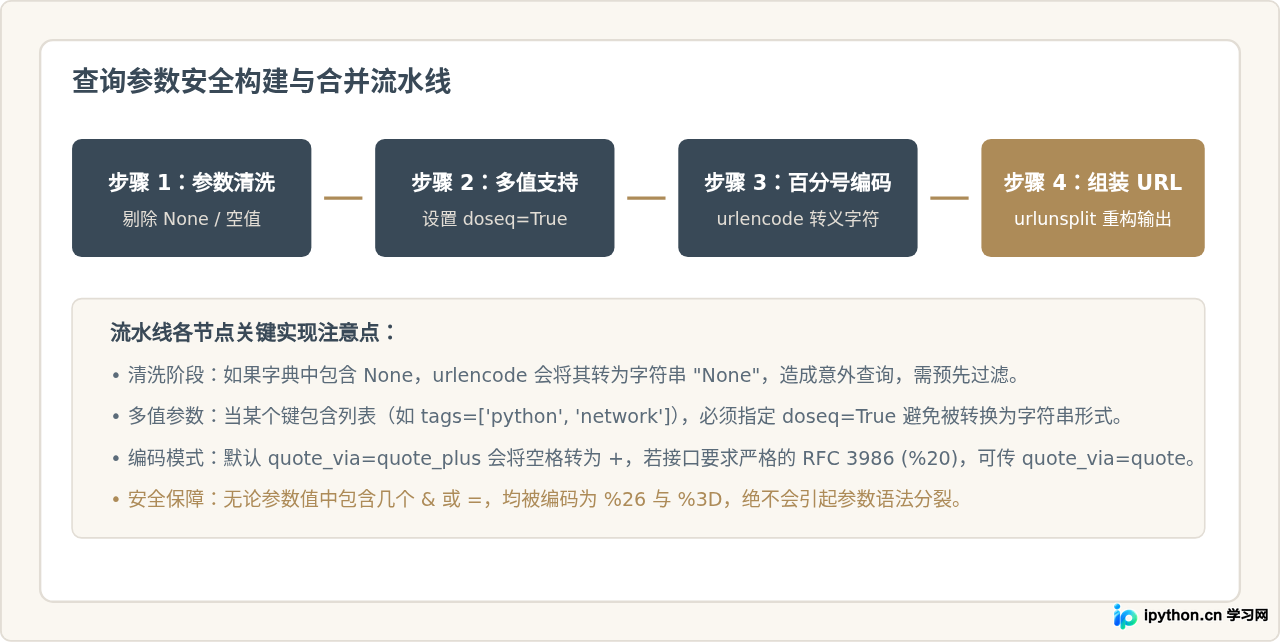
在编码过程中,有两项关键细节需要特别留意:
- 多值列表参数(
doseq=True):如果参数中存在列表或元组(例如filter_id=[101, 102]),默认情况下urlencode会将列表强转为"['101', '102']"字符串。设置doseq=True后,它会展开为filter_id=101&filter_id=102的标准序列。 - 预过滤
None值:urlencode不会自动丢弃None,而是直接序列化为key=None。建议在传入前通过字典推导式进行清洗。
from urllib.parse import urlencode, quote

raw_params = {
    "keyword": "Python 编程",
    "categories": ["backend", "network"],
    "token": "a&b=c",      # 包含保留符号
    "deprecated_field": None # 空字段
}

# 1. 过滤为 None 的无效字段
clean_params = {k: v for k, v in raw_params.items() if v is not None}

# 2. 安全编码(展开列表序列)
query_string = urlencode(clean_params, doseq=True)
print(query_string)
# 输出:
# keyword=Python+%E7%BC%96%E7%A8%8B&categories=backend&categories=network&token=a%26b%3Dc

# 3. 若服务端要求空格转为 %20 而非 +
query_strict = urlencode(clean_params, doseq=True, quote_via=quote)
print(query_strict)
# keyword=Python%20%E7%BC%96%E7%A8%8B...
动态合并已有 URL 的参数:urlsplit 与 urlunsplit
在很多实际业务场景中,我们拿到的目标 URL 本身就已经附带了部分查询参数或锚点(Fragment)。若直接拼接 ?new_key=val,一旦原 URL 中已存在 ?,就会造成双问号的语法错误;若原 URL 已有相同键名,直接追加还会产生键冲突。规范的做法是将 URL 解构、合并参数,然后重组。
标准库提供了 urlsplit 与 urlunsplit(相比 urlparse,它不拆分 parameters 字段,更符合当前 URI 规范):
from urllib.parse import urlsplit, urlunsplit, parse_qsl, urlencode

def append_query_params(base_url: str, new_params: dict) -> str:
    """安全地向已有 URL 中追加或更新查询参数"""
    # 1. 解构 URL
    parts = urlsplit(base_url)

    # 2. 解析原有 query 为键值列表(保留重复键)
    existing_pairs = parse_qsl(parts.query, keep_blank_values=True)
    existing_dict = dict(existing_pairs)

    # 3. 覆盖或添加新参数(过滤 None)
    for k, v in new_params.items():
        if v is not None:
            existing_dict[k] = v

    # 4. 重新编码 query
    new_query = urlencode(existing_dict)

    # 5. 重组 URL (scheme, netloc, path, query, fragment)
    updated_parts = (
        parts.scheme,
        parts.netloc,
        parts.path,
        new_query,
        parts.fragment
    )
    return urlunsplit(updated_parts)

# 测试已有查询参数的 URL
original = "https://example.com/search?engine=google&page=1#top"
result = append_query_params(original, {"page": 2, "keyword": "Python 教程"})

print(result)
# 输出: https://example.com/search?engine=google&page=2&keyword=Python+%E6%95%99%E7%A8%8B#topparse_qsl 返回的是包含键值元组的列表,能较好地应对原本可能存在的重名参数;urlunsplit 能够忠实地保留原始 URL 的协议、域名、路径以及 #top 锚点位置,保证合并过程不丢失 URL 状态。
总结与最佳实践检查清单
构建安全、严谨的 URL 处理代码,关键在于放弃对字符串拼接操作的依赖,全面拥抱结构化解析与标准化编码。日常开发中可遵循以下核心原则:
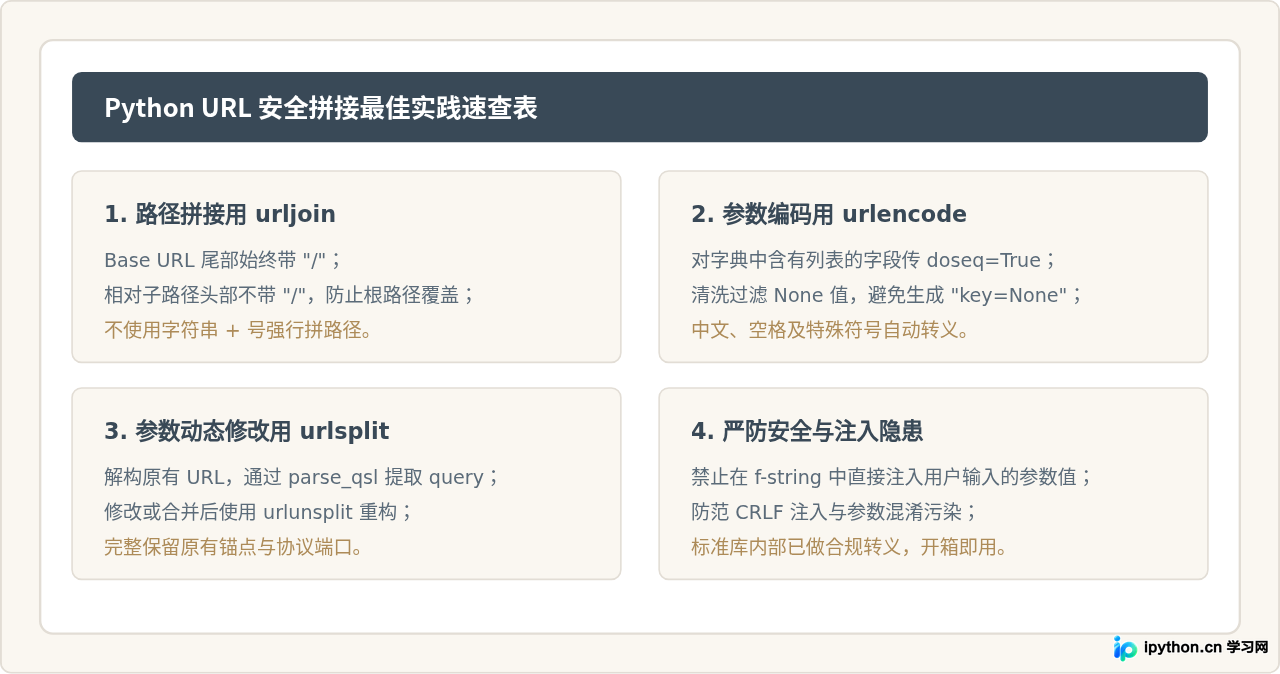
只要在实际项目中严格遵循以上模块化处理流程,就能彻底杜绝由于双斜杠、丢失斜杠、字符未转义以及参数注入导致的线上隐患,写出健壮且符合网络规范的 Python 网络代码。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









