

Python速成教程:零基础快速掌握核心语法与实战

对于完全没有编程经验的学习者而言,掌握 Python 并不需要一开始就通读数百页的语法手册。核心学习路径非常明确:搭建干净轻便的开发环境,理解变量、列表、字典等高频容器,掌握条件与循环结构,学会通过函数沉淀逻辑,最后通过一个真实的数据处理案例将所学串联起来。本文将围绕这套最小必要知识体系展开,不铺垫冗长背景,直接进入核心语法与实战演练。
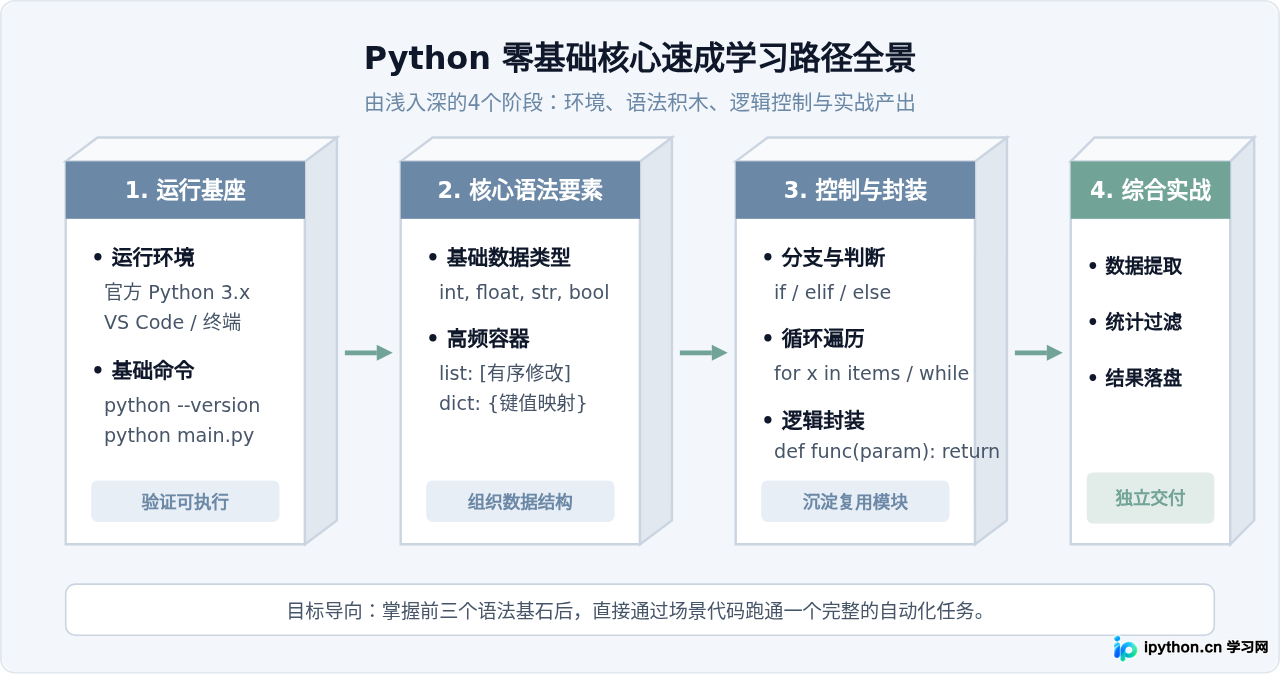
一、准备工作:搭建并验证运行环境
编写 Python 程序的第一步是确保计算机上有解释器,并能正常执行 .py 文件。请遵循以下具体步骤:
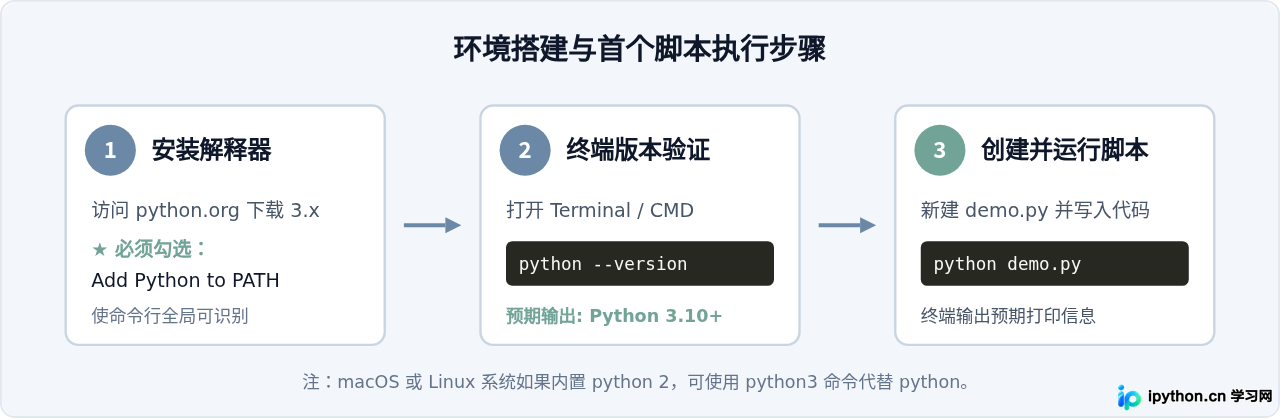
- 下载与安装解释器:进入官网 python.org 下载最新的稳定版安装包。在 Windows 安装向导的第一个界面中,务必勾选底部
Add Python to PATH,随后点击Install Now。如果漏选此项,在命令行中输入 python 会提示找不到命令。 - 验证安装结果:打开系统的终端(Windows 的 PowerShell 或 CMD,macOS 的 Terminal),执行版本检测命令:
若终端正确返回类似python --versionPython 3.11.4或更高版本信息,则说明系统路径配置成功。 - 编写并执行脚本:创建一个名为
hello.py的纯文本文件,写入一行代码:
在命令行进入该文件所在目录,执行运行命令:print("你好,Python!")
终端输出python hello.py你好,Python!,代表基础执行环境已经完全就绪。
二、核心语法基石:变量与高频容器
编程本质上是用变量存放数据,再用容器组织数据。Python 是动态类型语言,不需要显式声明变量类型,直接赋值即可使用。
1. 标量数据类型与变量
日常编码中最常用的四种标量类型是整数、浮点数、字符串和布尔值:
# 整数与浮点数
item_count = 12
unit_price = 45.5

# 字符串(单引号或双引号均可)
user_name = "张小明"

# 布尔值(首字母大写:True 或 False)
is_member = True

# 格式化字符串输出(f-string:推荐做法)
total_price = item_count * unit_price
print(f"客户: {user_name}, 购买数量: {item_count}, 应付金额: {total_price:.2f}")
2. 列表(List)与字典(Dictionary)的对照与选择
在批量处理数据时,列表和字典是最常打交道的两类结构。它们在组织形式和访问逻辑上有着本质差异:
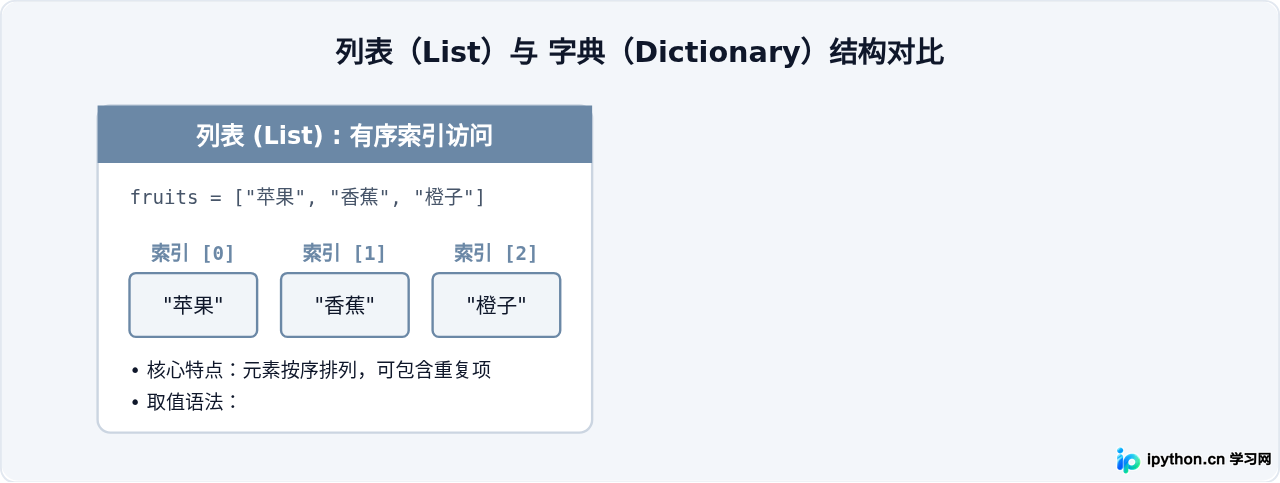
代码示例如下:
# 1. 列表操作
scores = [85, 92, 78]
scores.append(88)        # 末尾添加新元素
print(scores[0])         # 输出第1个元素: 85
print(len(scores))       # 元素总数: 4

# 2. 字典操作
student = {
    "name": "李四",
    "department": "技术部",
    "active": True
}
student["level"] = "中级"   # 添加或修改键值对
print(student["department"]) # 访问键对应的值
print(student.get("age", 25)) # 安全取值,如果键不存在则返回默认值 25
三、逻辑流控制:分支判断与循环遍历
Python 使用严格的代码缩进(通常为4个空格)来划分代码块,而不是像其它语言那样使用大括号 {}。这一规定使得代码层次分明。
1. 条件判断(if / elif / else)
score = 82

if score >= 90:
    grade = "优秀"
elif score >= 80:
    grade = "良好"
elif score >= 60:
    grade = "及格"
else:
    grade = "不及格"

print(f"最终评定结果为: {grade}")
2. 遍历循环(for ... in)
日常业务开发中,大部分循环都是在遍历列表或字典,直接用 for item in items 既清晰又安全:
# 遍历列表
sales = [120, 340, 260, 510]
total = 0
for amount in sales:
    total += amount
print(f"销售额总计: {total}")

# 遍历带键值的字典
product_prices = {"键盘": 299, "鼠标": 129, "显示器": 1499}
for product_name, price in product_prices.items():
    if price > 200:
print(f"高单价商品: {product_name} (¥{price})")IndentationError 异常。
四、模块化封装:定义与调用函数
当一段逻辑在多处需要执行时,将其封装为函数可以消除重复代码。使用 def 关键字定义函数,通过 return 返回运算结果:
def calculate_discount(price, discount_rate=0.9):
    """
    计算折后价格,默认提供 9 折优惠
    :param price: 原始价格 (float)
    :param discount_rate: 折扣比率,默认为 0.9
    :return: 折后金额
    """
    if price < 0:
        return 0.0
    final_amount = price * discount_rate
    return round(final_amount, 2)

# 调用函数
result_1 = calculate_discount(100.0)         # 使用默认参数,得到 90.0
result_2 = calculate_discount(250.0, 0.8)    # 指定自定义折扣,得到 200.0
print(f"折后价1: {result_1}, 折后价2: {result_2}")
五、综合实战演练:结构化文本日志分析器
为了检验上述基本语法的综合运用,我们来完成一个真实场景任务:编写一个脚本,解析一段模拟的服务器访问日志字符串,提取所有 HTTP 状态码为 200 的请求,统计每类资源的访问次数,并筛选出访问量最高的热门路径。
# 原始模拟日志文本
raw_logs = """
GET /index.html 200 120ms
POST /api/login 200 45ms
GET /static/style.css 304 10ms
GET /index.html 200 88ms
GET /api/user/profile 401 15ms
POST /api/login 200 50ms
GET /index.html 200 95ms
"""

def parse_and_summarize_logs(log_text):
    # 1. 拆分为行并过滤空行
    lines = log_text.strip().split("\n")
    success_requests = []

    # 2. 遍历并解析数据
    for line in lines:
        parts = line.strip().split(" ")
        if len(parts) >= 3:
            method = parts[0]
            path = parts[1]
            status_code = parts[2]

            # 仅统计状态码为 200 的成功访问
            if status_code == "200":
                success_requests.append(path)

    # 3. 利用字典统计每个路径出现的频次
    path_counts = {}
    for path in success_requests:
        path_counts[path] = path_counts.get(path, 0) + 1

    return path_counts

# 执行解析函数
summary_result = parse_and_summarize_logs(raw_logs)

# 4. 输出格式化报告
print("=== 访问成功的接口统计报告 ===")
for path, count in summary_result.items():
    print(f"资源路径: {path:<20} 成功访问次数: {count}")
运行结果(示例):
=== 访问成功的接口统计报告 ===
资源路径: /index.html          成功访问次数: 3
资源路径: /api/login            成功访问次数: 2
在上述 30 余行代码中,完整运用了我们前面讲解的知识点:字符串分割(split)、列表追加(append)、条件判断(if len(...) 与 if status_code == ...)、字典计数逻辑(path_counts.get())以及函数封装与解包遍历。零基础初学者理解了这段代码的执行流,就意味着已经具备了使用 Python 解决基础实际问题的能力。
六、知识总结与后续进阶路径
本文从环境确认、基本类型与集合容器、流程控制到函数复用,完成了 Python 最核心的基石构建。回顾整个学习过程,各个模块在实际开发中的角色可以总结如下:
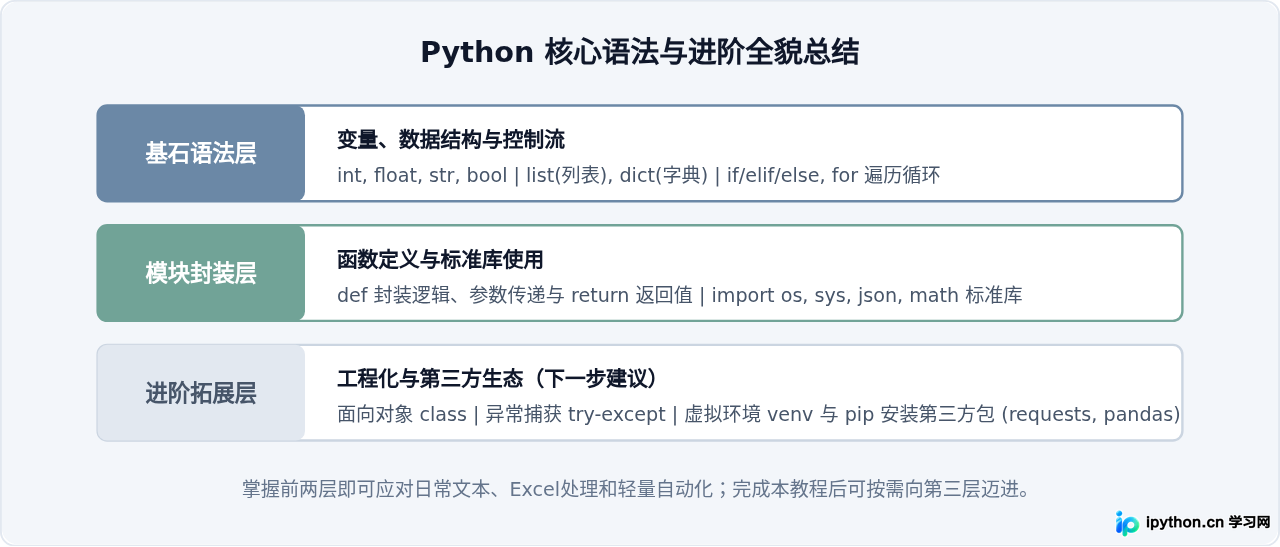
掌握了本教程介绍的语法后,建议读者不要停留在反复抄写语法规则上,而是直接挑选一个日常工作中的具体小问题(例如批量重命名文件、从多个文本中提取特定关键词等),在实践中巩固代码编写手感。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









