


在 C++ 里,原生数组依然可用,但一旦代码进入需要扩容、频繁传参、复杂遍历或安全检查的场景,它很快就会暴露出固定大小、手动管理和易出错的问题。本文按“为什么换、怎么用、怎样写得更高效”三步展开,保留常见代码写法和性能事实,帮助你判断什么时候该直接用 std::vector,什么时候还要关注容量、迭代器和算法配合。
为什么优先用 std::vector
原生数组的主要局限
在传统 C++ 编程里,原生数组长期是存储元素集合的常用方式,但它的使用成本往往被低估。数组大小通常在编译期确定,后续不能自然扩容;一旦涉及传递、拷贝、边界访问或生命周期管理,代码也更容易出现隐蔽错误。
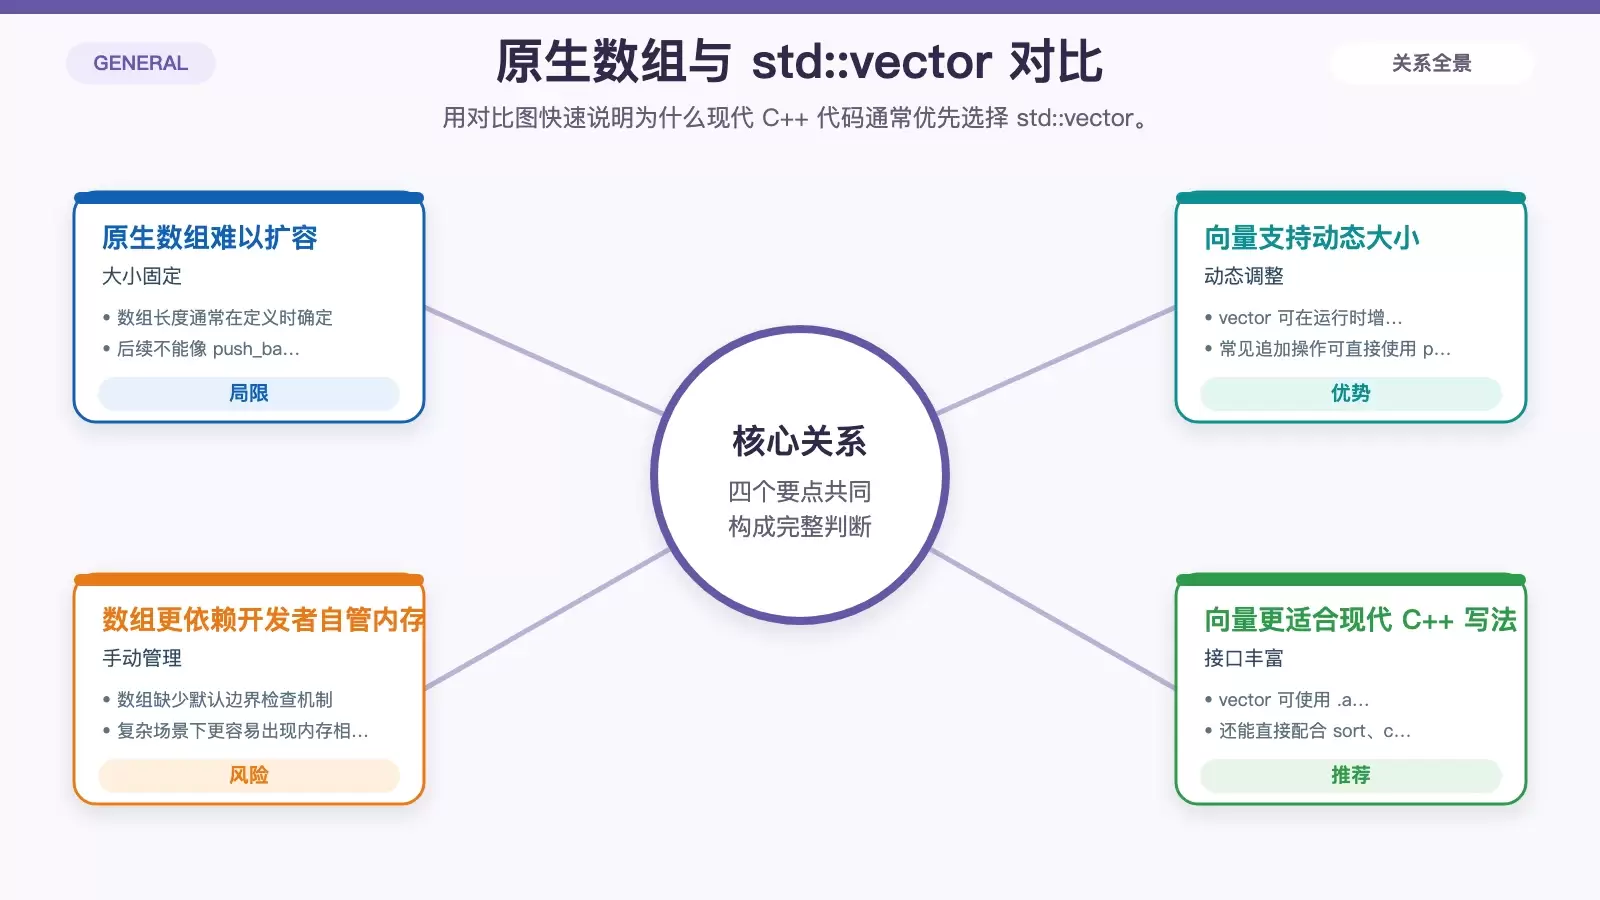
和现代的 std::vector 相比,原生数组的问题主要集中在三个方面:
- 大小固定,无法按需增长或缩减
- 缺少自动内存管理,复杂场景下更容易出错
- 没有现成的成员方法,很多操作都要手写
向量带来的三个直接收益
1. 动态大小管理
原生数组的长度一开始就固定,而向量可以在运行时扩展:
// 原生数组(固定大小)
int staticArray[5] = {1, 2, 3, 4, 5};

// 向量(动态大小)
std::vector<int> dynamicVector = {1, 2, 3, 4, 5};
dynamicVector.push_back(6);  // 轻松添加元素
2. 更安全的内存管理
向量会自动处理内存分配与释放,能显著减少手动管理带来的负担。需要边界检查时,还可以使用 .at() 进行安全访问。
| 特性 | 原生数组 | std::vector |
|---|---|---|
| 内存分配 | 手动 | 自动 |
| 边界检查 | 无 | 可选(使用 .at()) |
| 内存泄漏 | 可能 | 防止 |
3. 可直接配合标准库操作
向量本身就提供了丰富的接口,也天然适合与标准算法一起使用:
std::vector<int> numbers = {3, 1, 4, 1, 5, 9};
std::sort(numbers.begin(), numbers.end());  // 轻松排序

numbers.clear();  // 简单清空
numbers.resize(10);  // 轻松调整大小
性能上并不吃亏
std::vector 和原生数组一样,底层使用连续内存,因此保留了高效随机访问的特性。它的额外价值在于:扩容、重新分配和容量管理由容器统一处理,开发者可以在大多数业务代码里减少手动干预。
在实际开发中,选择 std::vector 往往还能带来这些好处:
- 提高代码可读性
- 增强类型安全性
- 简化内存管理
- 在大多数情况下性能更佳
向量的基础用法
声明与初始化怎么写
向量的创建方式比原生数组更灵活,既能声明空容器,也能一次性指定大小、初值或重复内容:
// 空向量
std::vector<int> emptyVector;

// 具有初始大小的向量
std::vector<int> sizedVector(5);

// 具有初始值的向量
std::vector<int> initializedVector = {1, 2, 3, 4, 5};

// 具有重复值的向量
std::vector<std::string> repeatedVector(3, "LabEx");
最常用的成员操作
| 方法 | 描述 | 示例 |
|---|---|---|
push_back() | 在末尾添加元素 | vec.push_back(10); |
pop_back() | 删除最后一个元素 | vec.pop_back(); |
size() | 获取元素数量 | int count = vec.size(); |
clear() | 删除所有元素 | vec.clear(); |
empty() | 检查向量是否为空 | bool isEmpty = vec.empty(); |
元素访问与遍历方式
向量支持多种访问方式。性能优先时可以使用下标运算符,需要更安全的检查时可以改用 .at(),而需要与算法库协作时则会大量使用迭代器。
std::vector<int> numbers = {10, 20, 30, 40, 50};

// 通过索引访问
int firstElement = numbers[0];

// 带边界检查的安全访问
int safeElement = numbers.at(2);

// 基于迭代器的访问
auto it = numbers.begin();
int firstViaIterator = *it;
遍历时,优先考虑更直观的范围 for:
std::vector<int> data = {1, 2, 3, 4, 5};

// 基于范围的 for 循环
for (int value : data) {
    std::cout << value << " ";
}

// 传统迭代器
for (auto it = data.begin(); it != data.end(); ++it) {
    std::cout << *it << " ";
}
容量、连续内存与 reserve()
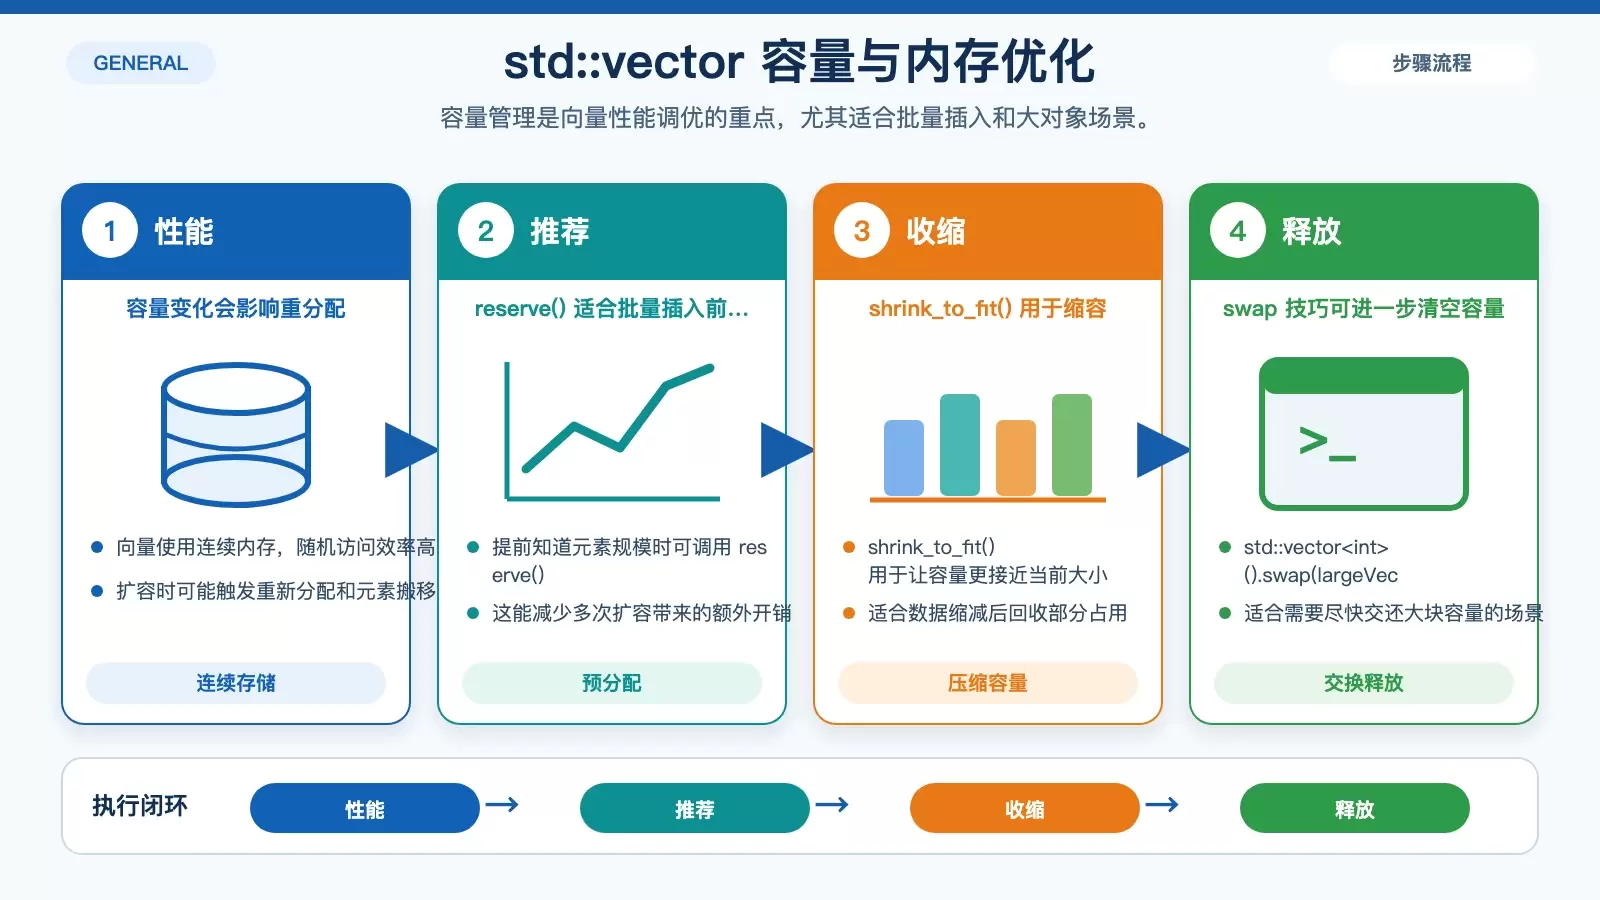
向量的一个关键特点是连续内存布局,这让它保留了接近数组的访问效率。但动态增长也意味着可能发生重新分配,因此容量管理很重要。
如果你大致知道未来要放多少元素,可以提前预留容量:
std::vector<int> dynamicVector;
dynamicVector.reserve(100);  // 预分配内存
这通常能减少扩容次数,避免多次搬移元素,尤其适合批量插入场景。
复杂类型与多维向量
向量不只适合基本类型,也适用于结构体、字符串以及多维数据:
// 自定义对象的向量
struct Student {
    std::string name;
    int age;
};

std::vector<Student> classRoom = {
    {"Alice", 20},
    {"Bob", 22}
};

// 向量的向量
std::vector<std::vector<int>> matrix = {
    {1, 2, 3},
    {4, 5, 6}
};
常见操作的时间复杂度也需要记住:
| 操作 | 时间复杂度 |
|---|---|
| 随机访问 | O(1) |
| 在末尾插入 | 均摊 O(1) |
| 插入/删除 | O(n) |
| 搜索 | O(n) |
实用向量技术与性能优化
排序、查找与标准算法配合
向量真正的效率优势,往往体现在与标准算法库结合时。排序、查找、去重、旋转等操作都不需要自己重写底层逻辑。
std::vector<int> numbers = {5, 2, 8, 1, 9};

// 标准排序
std::sort(numbers.begin(), numbers.end());

// 自定义排序
std::sort(numbers.begin(), numbers.end(), std::greater<int>());

// 二分查找
bool exists = std::binary_search(numbers.begin(), numbers.end(), 5);
| 算法 | 用途 | 示例 |
|---|---|---|
std::remove | 删除元素 | vec.erase(std::remove(vec.begin(), vec.end(), value), vec.end()) |
std::unique | 删除重复项 | vec.erase(std::unique(vec.begin(), vec.end()), vec.end()) |
std::rotate | 旋转元素 | std::rotate(vec.begin(), vec.begin() + shift, vec.end()) |
过滤、转换与数据处理
对集合做过滤和转换时,向量也比原生数组更顺手,尤其适合配合 std::copy_if、std::transform 和插入迭代器。
std::vector<int> original = {1, 2, 3, 4, 5, 6, 7, 8, 9, 10};

// 过滤偶数
std::vector<int> evenNumbers;
// 将 original 中的偶数元素复制到 evenNumbers 中
std::copy_if(original.begin(), original.end(),
    std::back_inserter(evenNumbers),
    [](int n) { return n % 2 == 0; });

// 对 original 中的元素进行转换
std::vector<int> squared;
std::transform(original.begin(), original.end(),
               std::back_inserter(squared),
               [](int n) { return n * n; });
内存优化的几个实用手法
当向量较大或生命周期较长时,可以进一步控制容量,减少不必要的内存占用:
std::vector<int> largeVector(10000);

// 减少容量以匹配大小
largeVector.shrink_to_fit();

// 使用交换技巧释放内存
std::vector<int>().swap(largeVector);
如果对象构造成本较高,还可以优先考虑 emplace_back():
std::vector<int> data(1000000);

// 预分配内存
data.reserve(1000000);

// 使用 emplace_back 而非 push_back
data.emplace_back(42);

// 避免不必要的复制
std::vector<std::string> names;
names.emplace_back("LabEx");  // 直接构造
反向遍历与条件分区
除了常规遍历,向量还支持反向迭代器和条件分区,适合处理中间步骤较多的数据流:
std::vector<std::string> words = {"Hello", "LabEx", "C++", "Programming"};

// 反向迭代
for (auto it = words.rbegin(); it != words.rend(); ++it) {
    std::cout << *it << " ";
}

// 条件迭代
auto partitionPoint = std::partition(words.begin(), words.end(),
    [](const std::string& s) { return s.length() > 4; });
异常处理与安全访问
当访问位置可能越界时,.at() 比下标运算符更适合写在关键路径中,因为它会在越界时抛出异常:
std::vector<int> safeVector;

try {
    // 安全的元素访问
    int value = safeVector.at(0);  // 抛出 out_of_range 异常
} catch (const std::out_of_range& e) {
    std::cerr << "向量访问错误:" << e.what() << std::endl;
}
什么时候该直接用 vector
一组实用判断标准
如果你的代码符合下面任意一种情况,通常都可以优先考虑 std::vector:
- 元素数量在运行时才能确定
- 需要频繁追加、过滤、排序或查找
- 希望与标准算法库无缝协作
- 希望减少手动内存管理和边界错误
相对地,只有在极少数对底层布局、固定长度或特殊接口形式有硬性要求的场景里,原生数组才更有必要保留。
实践中的建议
- 使用
reserve()尽量减少重新分配 - 优先使用基于范围的
for循环 - 在安全性要求高时使用
.at() - 对复杂操作优先使用标准算法库
- 构造对象时优先考虑
emplace_back()
总体来看,std::vector 不是“可选替代品”,而是现代 C++ 中管理顺序数据集合的默认答案。理解它的容量模型、访问方式和算法配合方式后,你就能在保留性能的同时,把代码写得更稳、更清晰。









