

PHP计算中英文字符串长度的正确方法

发布时间:2026-10-13| 6人浏览过
在PHP开发中,准确计算包含中文在内的多字节字符串长度是常见需求。直接使用strlen()会导致中文被按字节拆分从而计数错误;推荐使用mb_strlen()配合正确的字符编码进行精准统计,或在特定场景下使用正则表达式辅助匹配。
为什么直接计算字符串长度会出错
在早期的ASCII编码环境中,一个英文字母占用1个字节,因此计算长度直接对应字符数。然而,现代网页开发普遍采用UTF-8编码。在中文字符集中,一个汉字通常占用3个字节(或更多)。如果忽略编码差异,简单的字节统计会将一个汉字误算为3个字符,导致逻辑判断和前端展示出现严重偏差。
方法一:使用 mb_strlen() 计算(推荐)
mb_strlen()是处理多字节字符串最标准的方法。它需要根据指定的字符编码(如UTF-8)来识别字符边界,从而返回正确的字符数量。
第1步:配置并调用 mb_strlen
- 目的:获取准确的混合中英文字符数。
- 关键参数:必须显式指定第二个参数为
'UTF-8',否则函数可能因环境默认编码不同而产生不可预知的结果。
$str = "Hello 你好";
// 指定编码为 UTF-8
$length = mb_strlen($str, 'UTF-8');
echo "字符串的长度是:" . $length;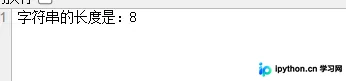
方法二:使用 strlen() 的限制与误区
strlen()仅计算字符串占据的字节数,不区分字符类型。对于纯英文字符串,它的表现良好且性能最高,但在遇到中文时会产生误导性结果。
第2步:测试 strlen 在混合文本中的表现
- 入口:任何包含非单字节字符(如中文、日文、Emoji)的字符串。
- 现象:在UTF-8下,1个汉字会被计为3个字节。
- 示例:字符串
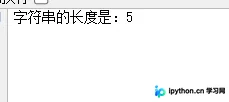
Hello长度为5,而Hello 你好若用 strlen 计算将得到 11 (5+6),而非期望的7。
$str = "Hello";
$length = strlen($str);
echo "英文字符串的长度是:" . $length;
方法三:使用正则表达式匹配字符
当需要更复杂的匹配逻辑,或者某些旧版本环境对Mbstring扩展支持不佳时,可以使用preg_match_all()结合Unicode模式来提取字符。
第3步:通过正则表达式统计
- 动作:使用
/./u模式,其中u修饰符表示使用UTF-8进行正则匹配。 - 逻辑:匹配出所有字符存入数组,再统计数组元素个数。
$str = "Hello 你好";
preg_match_all('/./u', $str, $matches);
// $matches[0] 包含了所有匹配到的单个字符
$length = count($matches[0]);
echo "字符串的长度是:" . $length;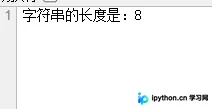
总结与建议
在处理涉及用户输入、数据库存储和前端显示的PHP项目时,保持编码一致性至关重要。首选 mb_strlen($str, 'UTF-8'),因为它语义明确且性能较好。除非有特定的特殊字符过滤需求,否则不建议盲目依赖 strlen() 进行业务逻辑判断。
以上就是PHP计算中英文字符串长度的详细内容,更多关于PHP字符串处理技巧的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









