


很多人第一次接触 C# 正则里的前瞻、后顾,都会觉得写法短却不容易读懂。其实 Lookaround 的核心并不复杂:它本身不消费字符,只负责在当前位置做条件判断。下面按“先看语法、再看校验、提取和避坑”的顺序展开,你可以直接对照示例判断什么时候该用前瞻,什么时候该用后顾。
四种 Lookaround 是什么
Lookaround 常被翻译为“环视”或“前瞻/后顾”,它们的共同点是:只做条件断言,不把断言本身纳入最终匹配结果,因此也被称为零宽断言。
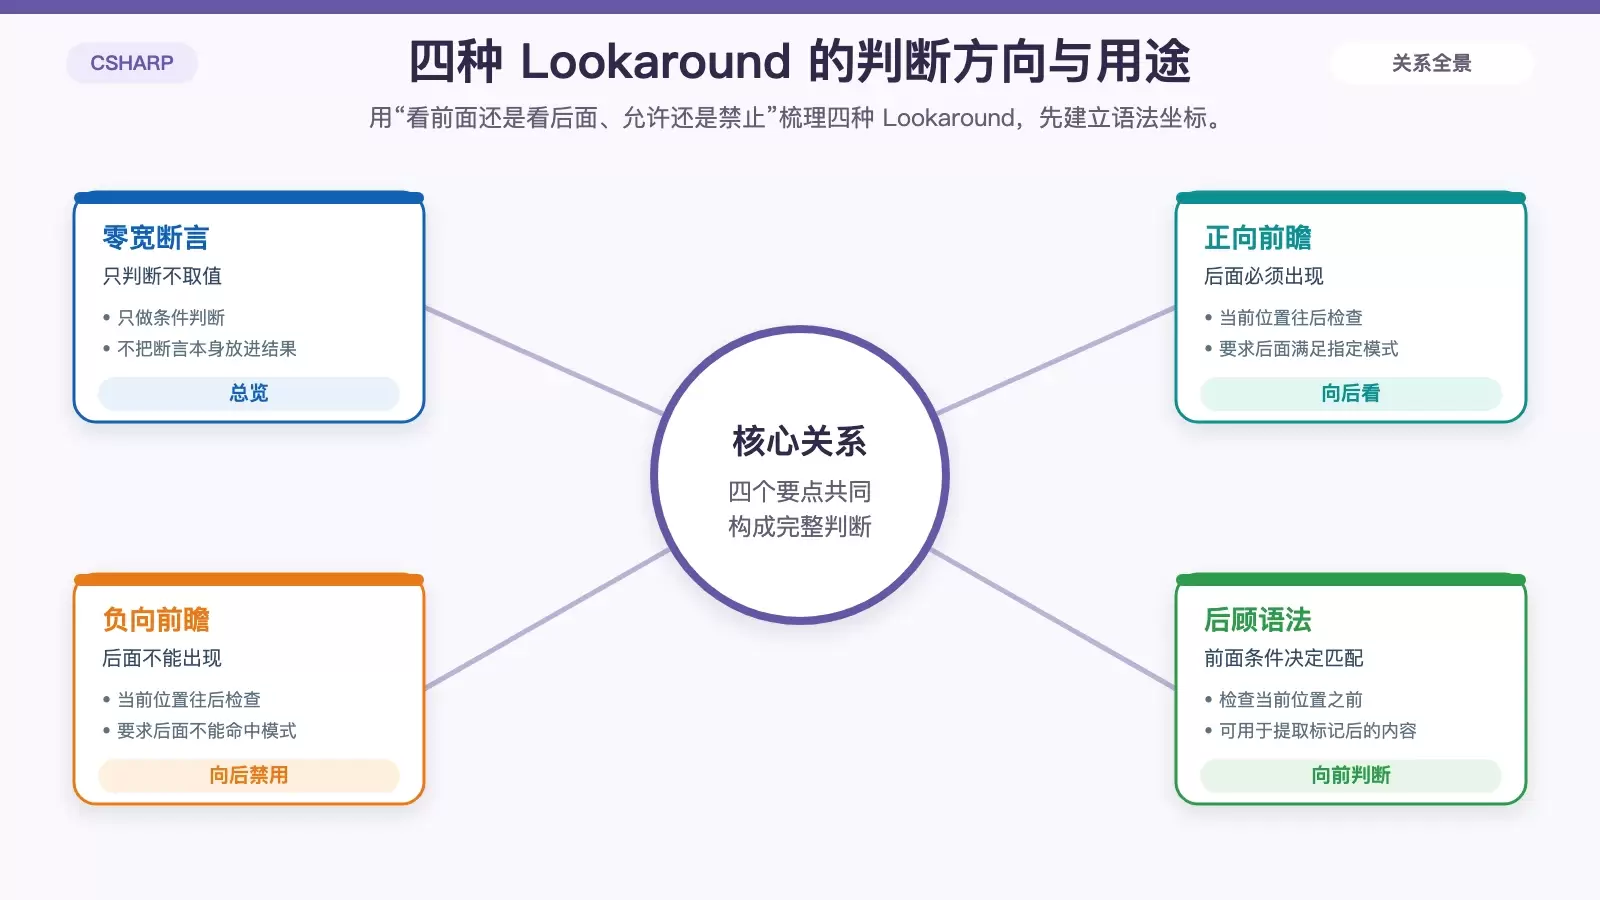
正向前瞻:后面必须能看到某个条件
(?=...)
含义是:从当前位置往后看,必须满足 ...,当前匹配才算成立。
负向前瞻:后面必须看不到某个条件
(?!...)
含义是:从当前位置往后看,不能满足 ...。
正向后顾:前面必须是某个条件
(?<=...)
它用于检查当前位置之前的内容是否满足指定模式。
负向后顾:前面必须不是某个条件
(?<!...)
它和正向后顾相反,要求当前位置之前不能出现指定模式。
前瞻怎么做复杂规则校验
前瞻最常见的用途,是把“长度限制”“字符集限制”“至少包含某类字符”这几类规则叠加到同一个表达式里。这样写的重点是:断言负责检查条件,真正消费字符的主体放在后面。
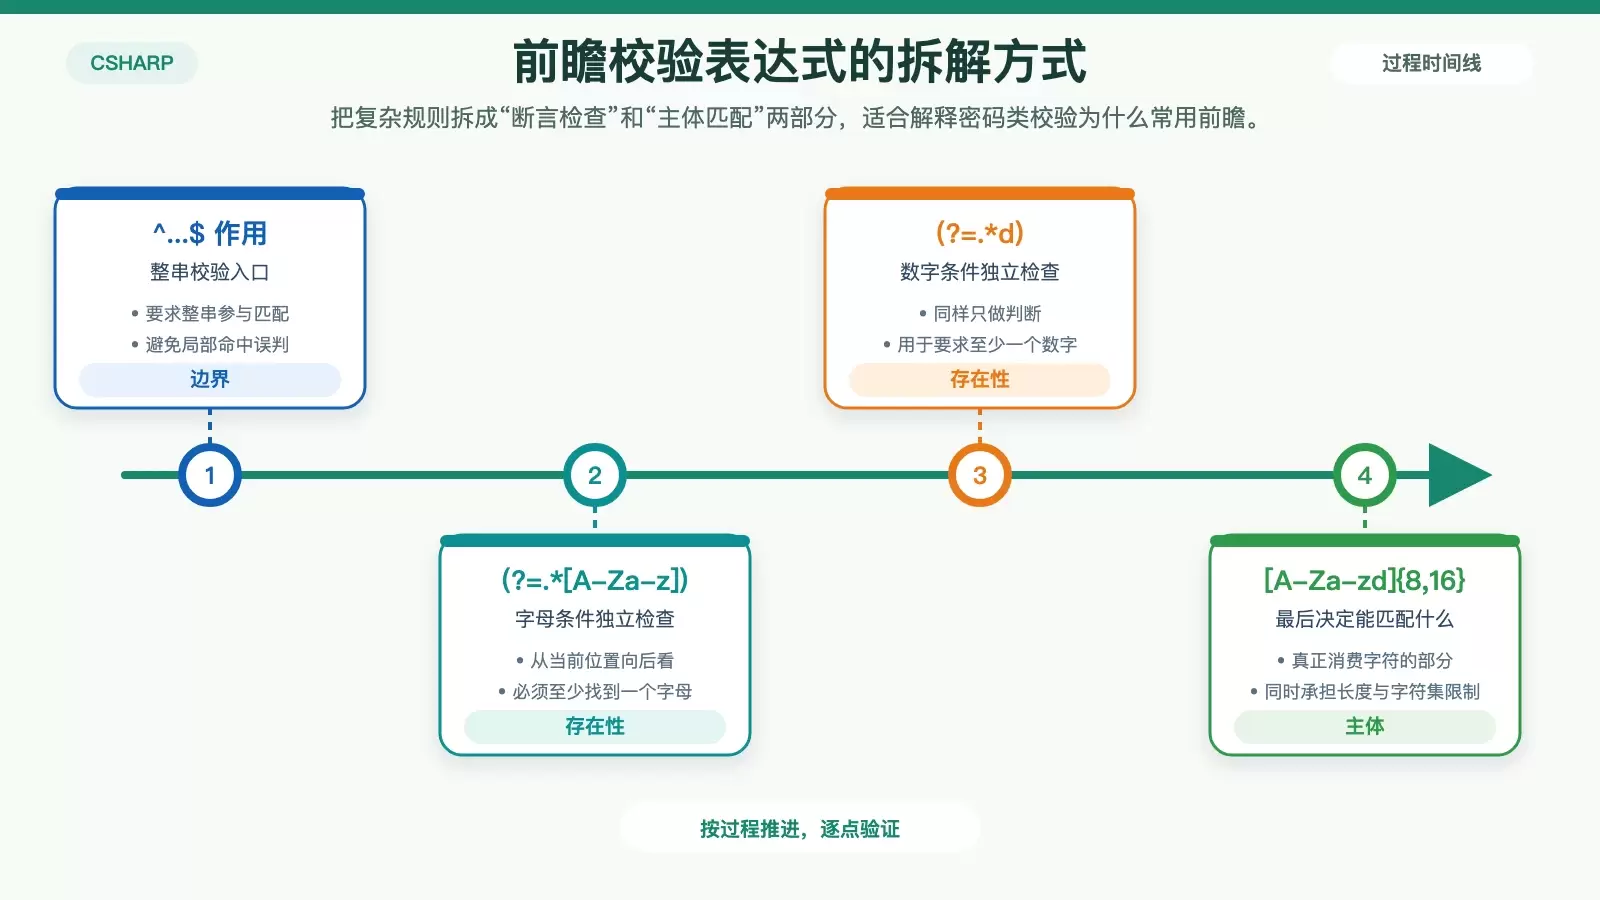
示例:8 到 16 位,且至少包含一个字母和一个数字
需求:
- 总长度 8~16
- 只能字母数字
- 至少 1 个字母
- 至少 1 个数字
正则:
^(?=.*[A-Za-z])(?=.*d)[A-Za-zd]{8,16}$
拆开来看:
^...$:要求整串都参与校验(?=.*[A-Za-z]):从当前位置向后,必须能找到至少一个字母(?=.*d):必须能找到至少一个数字[A-Za-zd]{8,16}:真正被匹配的主体内容,长度限制也在这里生效
C# 示例:
var pattern = @"^(?=.*[A-Za-z])(?=.*d)[A-Za-zd]{8,16}$";
Regex.IsMatch("abc12345", pattern); // True
Regex.IsMatch("abcdefgh", pattern); // False (无数字)
Regex.IsMatch("12345678", pattern); // False (无字母)
这类写法适合“多个条件同时成立”的场景,比如用户名、密码、工号编码等。判断时可以记住一句话:前瞻负责检查是否存在,后面的主体负责决定最终允许哪些字符、允许多长。
负向前瞻适合限制前缀和禁用模式
如果需求不是“必须包含什么”,而是“开头不能是什么”“后面不能接某类内容”,负向前瞻通常更直接。
示例:字符串不能以 admin 开头
Regex.IsMatch("AdminUser", @"^(?!admin)w+$", RegexOptions.IgnoreCase); // False
Regex.IsMatch("user_admin", @"^(?!admin)w+$", RegexOptions.IgnoreCase); // True
这里的关键在于 ^(?!admin):它要求字符串一开始就不能看到 admin。因为示例里带了 RegexOptions.IgnoreCase,所以 AdminUser 也会被判定为不通过。
这一类写法常用于:
- 禁止保留前缀
- 排除特定关键字开头
- 给全局匹配加“不能命中某模式”的限制
后顾为什么适合做精确提取
和前瞻相比,后顾更适合“从标记后面切一段出来”的场景。它的优势是:可以把前面的标记当成判断条件,但不把标记本身放进结果里。
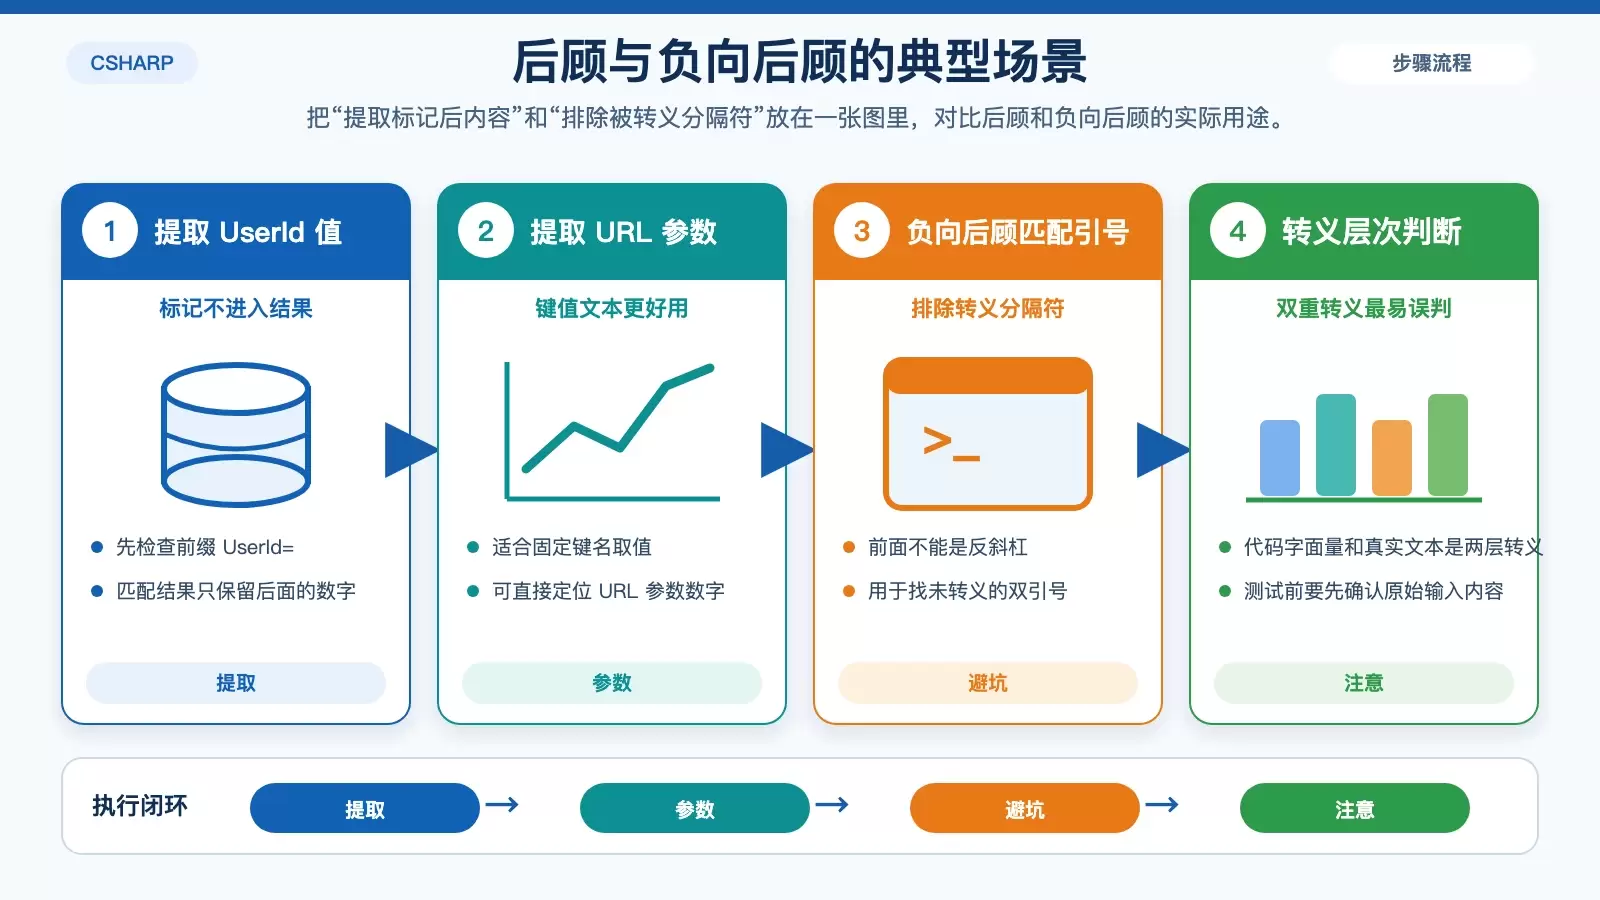
示例:提取 UserId= 后面的数字
文本:
UserId=42 Action=Login
正则:
(?<=UserId=)d+
C#:
var input = "UserId=42 Action=Login";
var m = Regex.Match(input, @"(?<=UserId=)d+");
Console.WriteLine(m.Value); // 42
这里 (?<=UserId=) 只检查当前位置前面是不是 UserId=,真正匹配出来的结果只有后面的数字,因此输出是 42,不会把前缀一起带出来。
示例:提取 URL 参数里的数字值
(?<=bid=)d+
这类写法很适合日志、查询串、配置文本等“有固定键名,想直接拿值”的场景。相比先整体匹配再手动截取,表达会更紧凑。
负向后顾如何识别未转义分隔符
负向后顾常见于“这个符号前面不能是某个转义字符”的需求,例如寻找未被反斜杠转义的引号、分隔符或特殊标记。
示例:匹配未被反斜杠转义的双引号
例如找文本中“不是 \" 的 "”:
(?<!\)"
含义:
(?<!\):前面不是反斜杠":匹配一个双引号
这类模式在处理带引号的配置、脚本片段和分隔文本时很常见,但使用时要特别注意一个问题:C# 字符串字面量中的转义,和实际待匹配文本里的转义,是两层不同的概念。
也就是说,你在代码里看到的 \,未必等同于文本里真正出现的字符数量。只要涉及反斜杠、引号、路径或 JSON 片段,最好先确认“输入字符串的真实内容”再写测试,否则很容易把问题误判成正则写错。
什么时候用前瞻,什么时候用后顾
- 如果你要判断“后面是否存在某条件”,优先考虑前瞻
- 如果你要限制“不能以某内容开头”或“后面不能出现某模式”,用负向前瞻更顺手
- 如果你要提取“某个标记后面的值”,后顾通常比手动截取更直接
- 如果你要识别“前面不能是转义符”的分隔符,负向后顾很常见
把 Lookaround 理解成“只判断、不吞字符”的条件模块,再去看这些表达式,阅读门槛会低很多。









