

深入理解C++的对象模型

C++在支持面向对象程序设计的同时,其底层的对象模型实现直接影响着程序的性能与资源消耗。了解简单模型、表格驱动模型以及现代C++标准的实现机制,对于掌握内存布局和虚函数表(VTABLE)至关重要。
何为C++对象模型
C++对象模型可以概括为两个主要部分:
- 语言中直接支持面向对象程序设计的部分,如类、继承、多态等语法特性。
- 针对上述支持机制的底层实现机制,即编译器如何处理这些语法特性以生成高效的机器码。
第1步:构建测试示例
为了直观地展示不同对象模型的区别,我们定义一个简单的 Point 类。该类包含了构造函数、虚析构函数、普通成员函数、静态成员函数、受保护的虚函数以及非静态和静态数据成员。
class Point {
 public:
  Point(float xval);
  virtual ~Point();

  float x() const;
  static int PointCount();

 protected:
  virtual ostream& print(ostream &os) const;

  float _x;
  static int _point_count;
};
这个类在内存中是如何表示的?下面将分别介绍三种不同的实现方式及其结构特点。
1. 简单对象模型(Simple Object Model)
简单对象模型名副其实,结构简单直观。在这种模型中,一个对象是由一系列 slots(槽位)组成的,每个 slot 相当于一个指针或索引,指向一个成员(member)。
- 映射关系: Members 按照在类中声明的顺序与 slots 一一对应。
- 包含内容: Members 包括数据成员(data members)和成员函数(function members)。
如果将简单对象模型应用在 Point 类上,其内存结构示意图如下:
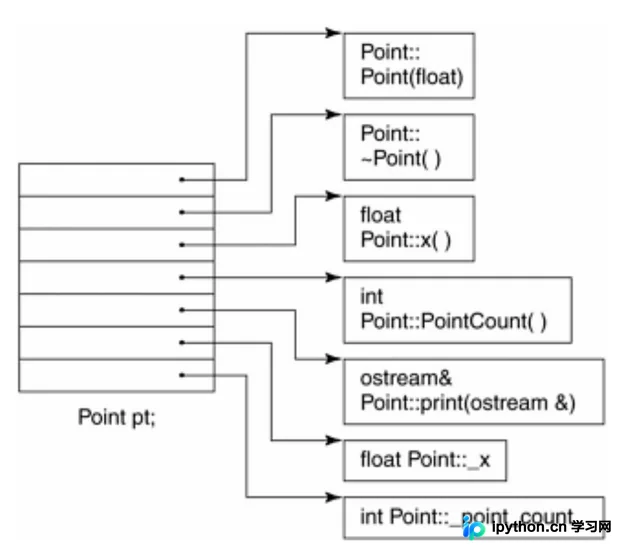
优点: 实现非常简单,极大地降低了编译器设计的复杂度。
缺点: 空间和时间的效率都较低。
- 空间开销: 由于所有 member 都对应一个 slot 指针,每个对象需要额外增加 “成员数量 × 指针大小” 的空间。
- 时间开销: 访问对象的每个 member 都需要经过一次 slot 的额外索引操作。
2. 表格驱动对象模型(Table-Driven Object Model)
表格驱动对象模型采用了更抽象的层级结构。它将成员数据(member data)和成员函数(member function)分别映射成两个独立的表格:member data table 和 function member table。
- 对象结构: 对象本身只存储指向这两个表格的指针。
- 函数表:
function member table由一系列 slot 组成,每个 slot 指向一个具体的成员函数地址。 - 数据表:
member data table直接存储成员数据的值。
将该模型应用于 Point 类时,结构图如下所示:
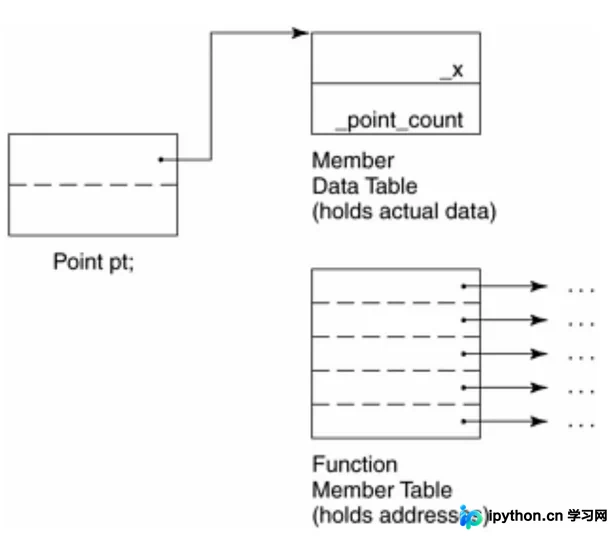
优点: 提供了较好的弹性。当对象的非静态数据成员发生变化而应用程序代码未变时,可能不需要重新编译整个程序,因为间接层提供了隔离。
缺点: 同样存在空间和时间的效率降低问题,原因同简单模型一样,增加了间接寻址的开销。
3. C++ 标准对象模型(Modern C++ Object Model)
Bjarne Stroustrup 早期设计的 C++ 对象模型是在简单模型基础上的改进版,旨在优化内存空间和存取时间。这是目前主流 C++ 编译器所采用的核心思路之一(尽管具体实现细节因编译器而异,但核心思想一致)。
存储策略:
- 非静态数据成员(nonstatic data members): 存储在每一个对象实例中。这意味着每个对象都有自己独立的数据副本。
- 静态数据成员(static data members)及所有成员函数: 被独立存储在对象之外。这实现了代码共享和数据共享,极大减少了单个对象的大小。
对虚函数的支持机制: 为了实现动态多态,C++ 引入了虚函数表(Virtual Table,简称 VTABLE)的概念:
- Virtual Table: 所有包含虚函数或者继承自有虚函数基类的类,都会有一个虚拟函数表。该表存储着一系列指向该类所包含的具体虚函数实现的指针。
- Type Info: 每个类关联的
type_info object也通常由虚拟函数表管理,一般存在于表格的首个 slot,用于支持运行时类型识别(RTTI),如dynamic_cast操作。
在现代 C++ 对象模型下,Point 类的内存结构示意图如下:
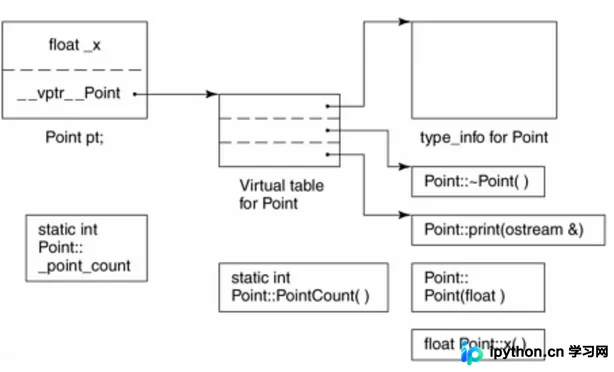
优点: 兼具空间和存取效率。
- 非静态数据成员直接嵌入对象中,无需额外指针,存取速度快。
- 静态成员和函数成员共享存储,不增加单个对象的大小。
缺点: 缺乏灵活性。如果应用程序代码未曾更改,但所用到的类的非静态数据成员有所更改(例如增加或减少成员变量),那么那些代码仍然需要全部重新编译。这与表格驱动模型提供的弹性形成对比,后者通过多层间接性牺牲性能换取了部署的便利性。
继承情况下的对象模型
C++ 支持单继承、多继承和虚继承。在继承体系下,基类实体(Base Class Entity)如何在派生类(Derived Class)中构建是对象模型复杂性的关键体现。
简单模型中的继承处理
在简单对象模型中,可以通过派生类对象中的一个 slot 来存储基类子对象(Base Class Subobject)的地址。通过这个 slot 可以访问基类成员。
- 缺点: 这种间接存储导致了空间和存取时间的额外负担,且间接级数会随着继承深度的增加而叠加。
- 优点: 派生类的物理结构不会因为基类的改变而改变,具有结构稳定性。
表格驱动模型中的继承处理
可以利用一个类似 Base Class Table 的表格来存储所有基类的信息。该表格包含一系列 slot,每个 slot 存储一个基类的偏移量或地址。
- 缺点: 同样面临间接性带来的性能损耗。
- 优点:
- 所有继承的类都有一致的表现形式(都包含一个指向基类表的指针),与基类的大小和数目无关。
- 基类表增加了子类的扩展性。当基类发生改变时,只需调整基类表的内容即可。
C++ 标准模型中的继承处理
C++ 最初采用的继承模型并不采用任何间接性,所有基类的数据直接平铺存储在子类对象中。这样在存储结构和访问效率上是最高效的。
- 代价: 当基类成员有任何改变时,用到此基类或者派生类的对象必须全部重新编译。
- 虚继承(Virtual Base Class):C++ 2.0 引入了虚基类以解决菱形继承问题。为了实现这一点,需要引入一定的间接性机制,通常会导入一个虚基类表(VBTABLE)或者扩展已有的虚函数表(VTABLE)来处理基类地址的动态查找。
总结
C++ 对象模型的设计在开发效率、运行性能和二进制兼容性之间进行了复杂的权衡。简单模型易于理解但性能差;表格驱动模型灵活但缓慢;现代 C++ 标准模型则追求极致的性能,要求开发者在编译期确定大部分结构。理解这些底层机制,特别是虚函数表和继承布局,有助于编写更高效、更稳定的 C++ 程序。以上就是深入理解C++的对象模型的详细内容,更多关于C++内存管理和面向对象设计的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









