

Python读写txt文本文件完整操作指南

本文详细解析Python读写txt文本文件的标准操作流程。涵盖不同访问模式的适用场景、安全打开与显式关闭规范、逐行读取技巧,以及内容查找替换与数据过滤排序的实战代码。掌握这些基础I/O接口配置,即可安全高效地完成纯文本数据的提取与转换。
目标:安全高效地读取与持久化txt文本数据
在数据处理管线中,.txt 因其轻量与广泛兼容性常被用作中间格式。部分 .csv 或 .xlsx 文档也可转换为明文以便快速载入内存。Python 原生提供了基于字节流与字符流的 I/O 接口,配合 list 与 numpy.array 即可完成类似科学计算环境的数据结构映射。
第1步:以只读模式加载并解析文本内容
目的:获取文件句柄并将磁盘数据同步至内存变量。
入口:open() 函数
动作:调用内置方法逐行捕获文本,解析分隔符并存入列表。
重要参数:filename 指定路径,'r' 为默认只读模式,split(sep) 定义字段切分符号。
完成状态:终端无报错,内存中生成对应维度的数值型数组,可直接用于后续算法运算。
import numpy as np

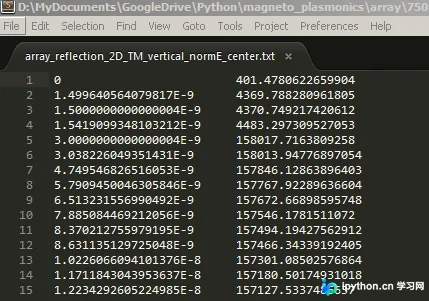
filename = 'array_reflection_2D_TM_vertical_normE_center.txt'
pos = []
Efield = []

with open(filename, 'r', encoding='utf-8') as file_to_read:
    while True:
        lines = file_to_read.readline()
        if not lines:
            break
        p_tmp, E_tmp = [float(i) for i in lines.split()]
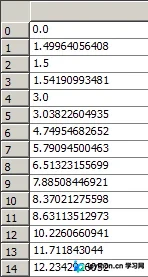
        pos.append(p_tmp)
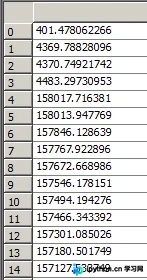
        Efield.append(E_tmp)

pos = np.array(pos)
Efield = np.array(Efield)
第2步:按需切换写入模式并保存结果
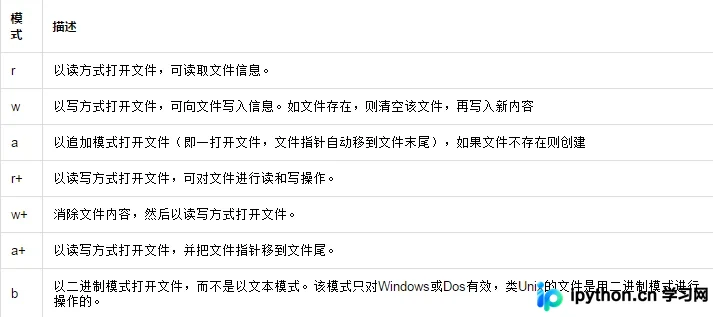
风险提示:'w'(覆盖)与 'r+'(原地修改)模式会直接破坏原文件内容,操作前务必备份或确认目标为空目录。
目的:将计算结果或新采集的日志持久化到磁盘。
入口:open() 函数
动作:指定写权限,调用 .write() 输入字符串,末尾执行 .close() 触发内核缓冲区刷盘。
重要参数:'w' 清空重写,'a' 尾部追加,'r+' 先读后写防覆盖。
完成状态:再次查看目标文件,缓存数据已落盘,原始未被覆盖段落保持完整。
# 强制覆盖写入(谨慎使用)
f1 = open('/tmp/test.txt', 'w', encoding='utf-8')
f1.write('hello boy!\n')
f1.close()

# 安全追加模式(推荐)
f_append = open('/tmp/test.txt', 'a', encoding='utf-8')
f_append.write('\nhello man!\n')
f_append.close()

# 不替换原内容的写入技巧
f_swap = open('/tmp/test.txt', 'r+', encoding='utf-8')
f_swap.read() # 驱动指针移动至文件末尾
f_swap.write('\nhello girl!\n')
f_swap.close()
第3步:精确控制文件指针与批量追加记录
目的:在无外部框架支持下,实现非连续定位读取或免 .close() 实时落盘。
入口:f.seek()、f.flush()、f.tell()
动作:利用位移量重置光标位置;手动清空用户态缓冲;动态监测当前字节偏移。
重要参数:f.seek(offset, whence) 中 whence=0 从头偏移,1 从当前位置偏移,2 从尾端偏移。
完成状态:执行 f.flush() 后无需关闭文件即可在系统终端看到即时更新的内容;f.tell() 返回准确的字节索引。
# 指针跳转与手动落盘示例
f_ctrl = open('/tmp/test.txt', 'r+', encoding='utf-8')
f_ctrl.seek(0, 2)          # 移至末尾
f_ctrl.write('\nappend_line\n')
f_ctrl.flush()              # 强制同步至文件系统
f_ctrl.close()
第4步:执行关键字检索、替换与空白行过滤
目的:自动化清理脏数据、统计特定标识频次,并输出结构化结果。
入口:re模块、迭代器循环、字符串方法
动作:遍历逐行文本,正则匹配计数;或构建过滤器丢弃空字符与注释头,最后统一排序并写盘。
重要参数:re.findall(pattern, string) 返回匹配列表长度;line.strip() 剥离首尾换行与空格;startswith('#') 拦截注释。
完成状态:控制台打印统计总数;生成仅含有效业务文本的 result.txt,各行按字母序排列且无冗余换行。
# 统计与过滤排序综合脚本
import re

def clean_and_sort(src_path, dst_path, target_keyword):
    with open(src_path, 'r', encoding='utf-8') as fp_in:
        lines = fp_in.readlines()

    count = sum(len(re.findall(target_keyword, line)) for line in lines)
    print(f'Search {count} "{target_keyword}"')

    filtered = [line.strip() for line in lines if line.strip() and not line.startswith('#')]
    filtered.sort()

    with open(dst_path, 'w', encoding='utf-8') as fp_out:
        fp_out.write('\n'.join(filtered) + '\n')

clean_and_sort('cdays-4-test.txt', 'cdays-4-result.txt', 'world')
常见异常排查与操作确认
若在调用 .write() 时报错 IOError: File not open for writing,说明文件是以默认的只读模式打开,需显式传入 'w'、'a' 或 'r+'。执行 f.next() 越界时抛出 StopIteration 属于正常现象,建议使用 for line in f: 迭代语法替代旧版显式指针操作以避免内存泄漏。所有打开的文件对象建议在业务块结束后立即调用 .close(),或使用 with 上下文管理器自动回收系统句柄。
总结
以上就是Python读写txt文本文件的详细内容,更多关于Python文件I/O操作与数据清洗的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









