

C#解决生牛问题:从递归到记忆化搜索的优化

解决C#中的生牛数量计算问题时,基础的递归方案存在严重的重复计算缺陷。引入记忆化搜索(Memoization)技术,利用哈希表缓存中间结果,可大幅降低时间复杂度,显著提升大规模数据下的执行效率。
问题分析与初步方案
经典数学问题描述如下:一头刚出生的小牛,4年后生一只小牛,此后每年生一只。现有一头刚出生的小牛,问20年后共有多少只牛?
该问题本质上是一个递推过程,涉及子问题的嵌套,直观上适合采用递归方法求解。首先构建一个直接递归的版本,逻辑如下:
- 初始状态为1头牛。
- 若年份小于等于3,返回1(因为前三年不生育)。
- 从第4年开始,每年的总牛数等于上一年的总数加上当年新出生的牛数。新出生的牛数等于当前年份减去3后所能产生的子牛繁殖数。
对应的C#实现代码如下:
public long Compute1(uint years)
{
  //初始化为1头牛
  long count = 1;
  if (years <= 3)
  {
    return count;
  }
  int i = 4;
  while (i <= years)
  {
    int subYears = i - 3;
    count += Compute1((uint)(subYears));
    i++;
  }
  return (long)count;
}
这种方法的局限性在于存在大量的重复计算。例如,计算第5年时可能需要知道第2年的情况,而计算第6年时又需要再次计算第3年的情况,导致指数级的调用次数。当输入年份达到100时,该方法几乎无法在合理时间内返回结果。
优化思路:记忆化搜索
为了克服上述性能瓶颈,可以观察到不同分支的递归调用中,相同的年份参数会反复出现且结果固定。因此,可以采用记忆化搜索策略:将已经计算过的年份对应的牛的数量存储起来,下次遇到相同年份时直接查表返回,避免重复运算。
具体实现步骤如下:
第1步:初始化缓存容器
使用Hashtable作为缓存对象,用于记录已计算年份的结果。同时保留初始入口函数,负责初始化缓存并在必要时调用核心逻辑。
第2步:实现带缓存的核心算法
在递归或循环过程中,每次计算前先检查Hashtable中是否已包含该年份的结果。如果存在,直接取值累加;如果不存在,则继续递归计算并将结果存入表中。
Hashtable table = new Hashtable();
public long Compute(uint years)
{
  //初始化为1头牛
  long count = 1;
  if (years <= 3)
  {
    return count;
  }
  int i = 4;
  while (i <= years)
  {
    int subYears = i - 3;
    if (table.ContainsKey(subYears))
    {
      count = (long)table[subYears];
    }
    else
    {
      count += Compute((uint)(subYears));
    }
    if (!table.ContainsKey(subYears))
    {
      table.Add(subYears, count);
    }
    i++;
  }
  return (long)count;
}
性能验证与对比
通过编写测试程序对两种方法进行比对,观察在不同年份输入下的表现。
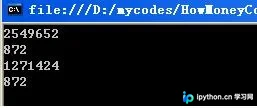
当输入年份较小时(如20年),基础递归法的耗时极短,两种方法的时间差异不明显,基本处于同一数量级。然而,随着年份增加,基础递归法的耗时呈爆炸式增长,而优化后的算法则保持稳定。
小数据量测试(20年)
在20年的场景下,两种算法均能快速得出结果,用户界面上体现为瞬间完成。
大数据量测试(50年)
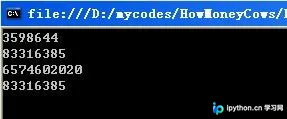
当输入年份提升至50年及以上时,优化算法的优势变得极为显著。基础方法因重复计算过多会导致CPU满载且无响应,而记忆化搜索版本能在毫秒级返回正确结果。测试截图显示,第二种算法在处理大数值时的性能比第一种高出百倍乃至千倍,且年份越高,差距越悬殊。
通过上述分析与实测可知,对于具有重叠子问题特征的递推算法,引入缓存机制是提升性能的关键手段。在实际开发中,可根据具体场景选择适合的动态规划或记忆化搜索实现方式。
以上就是C#算法之大牛生小牛的问题高效解决方法的详细内容,更多关于C#算法优化的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









