

C#递归实现快速排序算法详解与代码

快速排序(Quick Sort)是处理大规模数据时高效的原地排序算法,由 C.A.R. Hoare 发明。它利用“分而治之”的策略,将数据表不断划分为越来越小的子表。本文将结合具体数据案例,逐步拆解 C# 中基于递归的快速排序逻辑,并给出核心代码实现。
快排的核心逻辑与分治思想
与归并排序需要在临时向量中拷贝元素不同,快速排序是一种就地排序(In-place Sort)算法。它的核心目标是在每一次迭代中找到基准元素(Pivot)的最终位置:确保该元素左边的所有值都比它小,右边的所有值都比它大。随后,对左右两个子区间递归地重复这一过程。
操作步骤解析
为了理解具体的执行流程,我们以以下包含 10 个元素的整数向量为例进行演示:
v = {800, 150, 300, 650, 550, 500, 400, 350, 450, 400}假设当前处理的索引范围为 [first, last),即整个数组 [0, 10)。
第1步:选择基准点并完成初次划分
- 确定中心点:取索引范围的中点
mid = (0 + 10) / 2 = 5。此时中心点的值为v[5] = 500。 - 初始交换:首先将中心位置的元素
v[mid]与起始位置v[first](即v[0])进行交换。这一步的目的是将基准值移动到便于双指针操作的最左侧位置。
交换后的数据表状态如下:
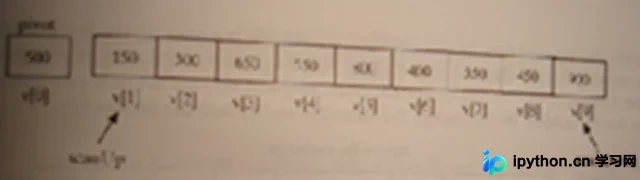
- 当前基准值变为
500,位于索引 0 处。 - 初始化扫描指针:
scanUp指向first + 1(索引 1),scanDown指向last - 1(索引 9)。
第2步:双向扫描与元素交换
接下来,双指针从两端向中间移动,寻找不满足大小关系的元素并交换:
- 左向右扫:
scanUp从左往右查找第一个大于等于基准值 500 的元素。 - 右向左扫:
scanDown从右往左查找第一个小于基准值 500 的元素,同时需防止下标越界(即scanDown > first)。
在本例中,左指针在索引 3 处遇到 650(大于 500),右指针在索引 8 处遇到 450(小于 500)。此时两指针未相遇,将这两个位置的值进行交换:
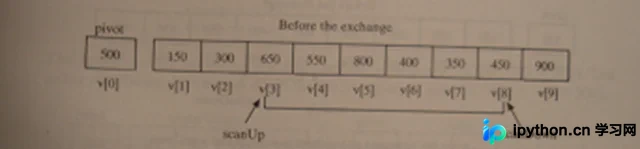
交换后继续移动指针向内扫描:
随着扫描的继续,直到满足 scanUp >= scanDown 条件时停止循环。此时,scanDown 所在的位置即为基准值 500 应该存放的最终位置。最后,将位于最开始的基准值(索引 0)与 scanDown 处的元素交换。
第3步:递归处理子表
第一次划分结束后,基准值 500 的左边是 {400, 150, 300, 450, 350},右边是 {800, 550, 650, 900}。下一步就是对这两个子表分别执行相同的划分逻辑:
- 左子表索引范围
[0, 5),右子表索引范围[6, 10)。 - 当子表长度 <= 1 时,无需处理;长度为 2 时直接比较交换即可终止。
C# 完整实现代码
根据上述步骤,我们将逻辑封装为求枢轴索引的 PivotIndex 函数和负责递归调用的 Sort 函数。在 C# 中,需要注意数组访问的边界控制。
/// <summary>
/// 辅助函数:交换数组中两个索引位置的数值
/// </summary>
private void Swap(int[] v, int index1, int index2)
{
    int temp = v[index1];
    v[index1] = v[index2];
    v[index2] = temp;
}

/// <summary>
/// 将向量 V 中索引 {first, last) 范围内的元素进行划分
/// 返回基准元素最终所在的索引位置
/// </summary>
private int PivotIndex(int[] v, int first, int last)
{
    // 如果只有一个元素或空,直接返回
    if (last == first)
    {
        return last;
    }

    // 如果有两个元素,直接比较大小后决定返回哪个,并在外层处理交换
    if (last - first == 1)
    {
        return first;
    }

    // 选取中间位置作为基准点
    int mid = (first + last) / 2;
    int midVal = v[mid];

    // 将基准点元素交换到序列起始位置,方便后续指针操作
    Swap(v, first, mid);

    // 设置左右扫描指针
    int scanA = first + 1;  // 从左向右寻找偏大的值
    int scanB = last - 1;   // 从右向左寻找偏小的值

    while (true)
    {
        // 左指针向右移,直到找到 >= midVal 的值或越界
        while (scanA <= scanB && v[scanA] < midVal)
        {
            scanA++;
        }
        // 右指针向左移,直到找到 < midVal 的值或越界
        while (scanB > first && midVal <= v[scanB])
        {
            scanB--;
        }

        // 如果两指针相遇或交错,说明划分完成,退出循环
        if (scanA >= scanB)
        {
            break;
        }

        // 交换左指针和右指针找到的错误位置元素
        Swap(v, scanA, scanB);
        scanA++;
        scanB--;
    }

    // 将基准值(原本在 first 位置)放回其最终确定的位置 scanB
    Swap(v, first, scanB);

    return scanB;
}

public void Sort(int[] v, int first, int last)
{
    int length = last - first;

    // 1. 递归终止条件:子表为空
    if (length <= 1)
    {
        return;
    }

    // 2. 子表只有两个元素:直接比较并交换(非必需但能提高微小数据的性能)
    if (length == 2)
    {
        if (v[first] > v[last - 1])
        {
            Swap(v, first, last - 1);
        }
        return;
    }

    // 3. 子表大于两个元素:先划分,再递归
    else
    {
        int pivotIndex = PivotIndex(v, first, last);
        Sort(v, first, pivotIndex);               // 递归处理左半部分
        Sort(v, pivotIndex + 1, last);           // 递归处理右半部分
    }
}
性能特点总结
快速排序的平均时间复杂度同样为 O(n log n),这使其在处理海量数据时具有极高的效率。需要注意的是,对于任何仅基于“比较”操作的排序算法,n log n 是理论上的时间复杂度下限(除非使用非比较类的计数排序等特定场景算法)。
以上就是C#递归实现快速排序算法的详细内容,更多关于C#基础编程的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









