

MySQL子查询实战:从IN查询到标量比较详解

子查询是将一个SELECT语句的查询结果作为中间结果供另一个SQL语句调用。掌握其基本操作,特别是基于IN的多值过滤和标量值的精确比较,能更灵活地处理复杂的数据筛选任务。
基础概念与表结构准备
子查询允许在一个查询语句内部嵌入另一个查询,从而实现对数据的层层筛选。为了直观理解其运作机制,我们设定两个基础数据表用于后续演示:
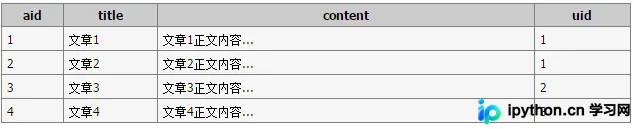
第1步:理解数据源结构
首先查看用于演示的基础数据表结构。以下是article(文章)表的初始数据状态:
第2步:准备关联的用户表数据
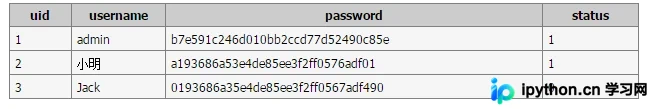
接着查看user(用户)表,该表记录了用户ID及当前状态(status),这是我们需要进行条件判断的核心字段:
使用IN进行多值子查询
当需要根据多个特定条件(如一组用户ID)来过滤外层查询时,可以使用IN配合子查询。这种方法常用于获取具有某类特征的实体。
第3步:编写基于状态的ID筛选
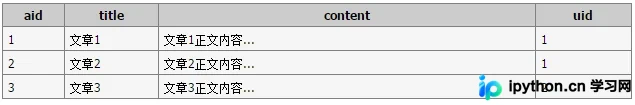
假设我们要找出所有由“状态为1”的用户发表的文章。操作逻辑分为两步:内层先查出符合条件的UID列表,外层再匹配这些ID。
- SQL入口:
SELECT * FROM article - 关键参数:
WHERE uid IN (子查询)
SELECT * FROM article WHERE uid IN(SELECT uid FROM user WHERE status=1)在该例子中,子查询会优先执行,返回类似(1, 2)的结果集。实际执行的逻辑等同于直接指定ID列表:
SELECT * FROM article WHERE uid IN(1,2)执行上述查询后,系统将从文章表中提取出对应的完整记录,返回结果如下所示:
标量子查询与标量比较
如果子查询的返回结果仅包含一个值(一行一列),则称为标量子查询(Scalar Subquery)。它可以像普通变量一样参与=、>、<等比较运算。
第4步:实现单值条件的精确匹配
若需查找由最新状态为1的用户(即ID最大或最后插入的那个)所写的所有文章,可使用标量子查询:
SELECT * FROM article WHERE uid = (SELECT uid FROM user WHERE status=1 ORDER BY uid DESC LIMIT 1)执行逻辑分析:
- 内层查询:
SELECT uid FROM user WHERE status = 1 ORDER BY uid DESC LIMIT 1。该语句按UID降序排列并取第一条,通常返回单一的数值(例如2)。 - 外层查询:将内层结果替换后,等效于
SELECT * FROM article WHERE uid = 2。
第5步:结合聚合函数的比较
除了返回原始列值,标量子查询常结合MAX()、COUNT()等函数使用。此时需注意,使用=、>等比较符的子查询必须保证只返回一个标量值。
示例:查询第二列的最大值等于第一列的行:
SELECT * FROM t1 WHERE column1 = (SELECT MAX(column2) FROM t2)注意:对于这类比较操作,子查询不能返回多行。唯一的例外是=运算符可以与行子查询(Row Subquery)配合使用,但在常规标量场景下需确保唯一性。
特殊场景:子查询替代表连接
虽然许多子查询可以用JOIN重写以提升性能,但在某些涉及统计或存在性检查的场景中,子查询的逻辑更为清晰且不可替代。
第6步:查找满足特定数量的记录
需求:找出那些恰好发表了 2 篇文章的所有文章记录。
这里使用了关联子查询(Correlated Subquery),外层表的别名t会被传入内层查询中进行逐行计数:
SELECT * FROM article AS t WHERE 2 = (SELECT COUNT(*) FROM article WHERE article.uid = t.uid)操作步骤说明:
- 目的:通过计数函数限制返回文章的数量阈值。
- 参数:外层表别名
AS t,内层使用COUNT(*)。 - 完成状态:仅返回用户文章数严格等于2的文章行。
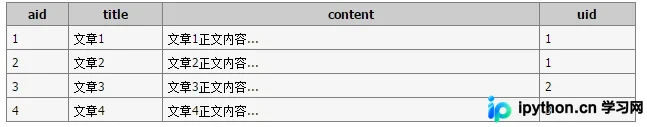
在执行此查询前,同样需要参考数据表的状态。这是此时的文章表视图:
对应的用户表视图:
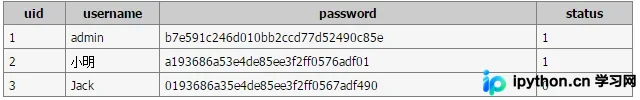
最终的查询返回结果展示了符合该数量条件的文章记录:
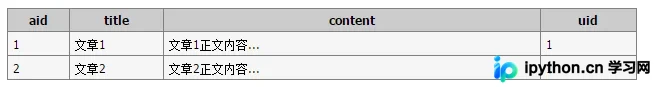
简要总结
MySQL子查询提供了强大的嵌套查询能力。在处理多值集合过滤时推荐使用IN配合子查询;在需要精确匹配某一极值或统计值时,可结合MAX、COUNT使用标量子查询。尽管JOIN在某些情况下性能更优,但子查询在处理特定存在性判断和计数关联时仍具有独特的语法优势。以上就是关于MySQL中使用子查询和标量子查询基本操作的详细内容,更多关于SQL高级查询技巧的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









