

C语言for循环优化入门:代码移动、展开与并行技巧

深入探讨C语言中for循环的结构优化,涵盖代码移动、减少开销、内存访问优化、循环展开及提高并行性等核心技巧,帮助开发者编写更高效的基础代码。
循环优化的核心目标
C语言作为接近硬件的高级语言,其性能瓶颈往往隐藏在基础控制结构中。对于for循环的优化,主要目标是减少不必要的计算重复、降低CPU流水线停顿、增加指令级并行度(ILP),从而显著提升执行速度。以下是五种经过验证的入门级优化方法。
准备条件与基础环境
- 开发语言:C/C++(部分概念适用于类似内存管理的语言)
- 编译器建议:GCC或Clang,启用优化选项(如
-O2或-funroll-loops)以便观察差异 - 关键概念:时间复杂度、函数调用开销、寄存器分配、汇编指令流水
第1步:代码外提(Code Motion)
目的:消除循环体内不依赖迭代变量的冗余计算。
操作说明:
检查循环体内的表达式,若结果在循环期间保持不变,应将其移至循环初始化之前。最常见的是数组长度查询或数学常量计算。
代码对比:
// 优化前:每次循环都重新计算长度,导致 O(n²) 级别开销
void lower1(char *s){
    int i;
    for(i=0; i<strlen(s); ++i)
        if(s[i]>='A' && s[i]<='Z')
            s[i]-=('A'-'a');
}

// 优化后:提前计算一次,复杂度回归 O(n)
void lower2(char *s){
    int i;
    int len=strlen(s);
    for(int i=0; i<len; ++i)
        if(s[i]>='A' && s[i]<='Z')
            s[i]-=('A'-'a');
}完成状态:
通过预计算len,避免了strlen()在每次迭代中的线性扫描,显著减少CPU周期浪费。
第2步:减少函数调用(Function Inlining/Overhead Reduction)
目的:降低栈帧创建、参数传递和返回的上下文切换成本。
操作说明:
若循环内频繁调用获取数据的函数(如get_vec_element),且数据源连续,可改为直接访问内存地址或指针。
代码对比:
// 优化前:每次循环调用函数获取元素
void sum1(vec_ptr v,data_t *dest){
    int i;
    int len=vec_length(v);
    *dest=0;
    for(i=0;i<len;++i){
        data_t val;
        get_vec_element(v,i,&val); // 高开销
        *dest+=val;
    }
}

// 优化后:直接获取基址指针,循环内直接访问内存
void sum2(vec_ptr v,data_t *dest){
    int i;
    int len=vec_length(v);
    data_t *data=get_vec_start(v); // 仅调用一次
    *dest=0;
    for(i=0;i<len;++i)
        *dest+=data[i]; // 直接内存读取
}完成状态:
去除了sum1中的函数调用链,利用缓存局部性直接操作数组,大幅提升吞吐量。
第3步:减少内存访问(Memory Access Optimization)
目的:利用寄存器加速累积计算,避免反复读写主存。
操作说明:
原代码在每次迭代中从dest读取旧值,相加后再写回dest。这种“读-改-写”模式会导致频繁的内存总线事务。引入局部变量acc在寄存器中累加,最后一次性写回内存。
代码对比:
// 优化前:反复读写 dest
*dest += data[i];

// 优化后:使用临时累加器 acc
void sum3(vec_ptr v,data_t *dest){
    int i;
    int len=vec_length(v);
    data_t *data=get_vec_start(v);
    data_t acc=0; // 寄存器缓存
    for(i=0;i<len;++i)
        acc+=data[i];
    *dest=acc; // 最终写入
}汇编视图分析:
优化前的汇编代码会在循环内部包含对dest地址的加载和存储指令(movl),而优化后的版本通常将acc映射到通用寄存器(如%eax或%rax),循环体内仅涉及加法指令,无内存访问。
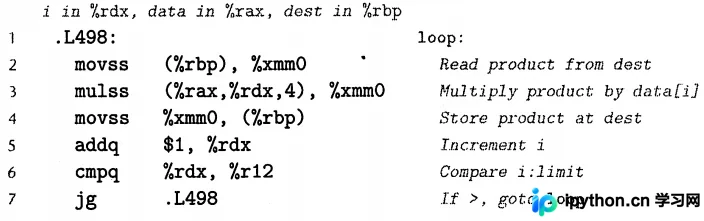
上图示意:显示了优化前汇编中对变量地址的双向读写操作,这是性能瓶颈所在。
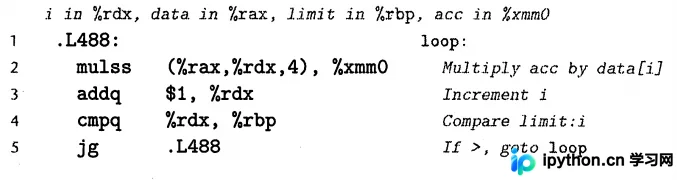
上图示意:显示了优化后汇编中,累加器完全在寄存器内运行,消除了内存往返延迟。
第4步:循环展开(Loop Unrolling)
目的:减少分支预测失败的概率,降低计数器更新的开销,并为CPU超标量执行提供更多并行空间。
操作说明:
将循环体复制多次,使每次迭代处理多个元素。例如,原本每次处理1个元素,现在每次处理4个元素,循环次数变为原来的1/4。
void sum4(vec_ptr v,data_t *dest){
    int i;
    int len=vec_length(v);
    int limit=len-3; // 边界处理
    data_t *data=get_vec_start(v);
    data_t acc=0;
    // 每次处理4个元素
    for(i=0;i<limit;i+=4){
        acc = acc + data[i] + data[i+1];
        acc = acc + data[i+2] + data[i+3];
    }
    // 处理剩余不足4个的元素
    for(;i<len;++i)
        acc+=data[i];
    *dest=acc;
}注意:
现代编译器在开启-funroll-loops时会自动进行此优化。但对于整数运算,显式展开效果显著;对于浮点数,需考虑精度问题。
第5步:提高并行性(Parallelism & Reassociation)
目的:打破数据依赖链,允许CPU同时执行多条加法指令。
方法一:多累加变量:
使用两个独立累加器,交替处理偶数索引和奇数索引,消除迭代间的数据依赖。
void sum5(vec_ptr v,data_t *dest){
    int i;
    int len=vec_length(v);
    int limit=len-1;
    data_t *data=get_vec_start(v);
    data_t acc0=0, acc1=0;
    for(i=0;i<limit;i+=2){
        acc0+=data[i];   // 独立并行
        acc1+=data[i+1]; // 独立并行
    }
    for(;i<len;++i)
        acc0+=data[i];
    *dest = acc0 + acc1;
}方法二:重结合变换(Reassociation):
改变加法结合顺序。例如,将 ((a+b)+c)+d 转为 (a+b)+(c+d)。这在数学上等价,但在浮点运算中可能略有误差,且在整数运算中能更好地触发并行。
void sum6(vec_ptr v,data_t *dest){
    // ... 初始化 ...
    for(i=0;i<limit;i+=4){
        // 先算 pair,再累加到 acc
        acc = acc + (data[i] + data[i+1]);
        acc = acc + (data[i+2] + data[i+3]);
    }
    // ... 收尾 ...
}完成判断:
当代码能够利用CPU的多个ALU单元同时处理不同的加法任务时,即达到了指令级并行优化的效果。
简要总结
C语言循环优化的本质是尊重硬件特性。
1. 外提消除无用功;
2. 去函数化减少开销;
3. 寄存器累积规避内存墙;
4. 展开与并行压榨流水线吞吐。
在实际开发中,建议优先使用编译器的自动优化(-O3),并在必要时通过汇编查看确认编译器是否执行了预期优化。对于关键路径,手动实施上述步骤可带来确定性的性能收益。
以上就是C语言for循环结构优化入门方法的详细内容,更多关于C++高效编程与底层优化的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









