

C语言快速排序与插入排序深度优化实战

掌握快速排序的双向划分逻辑以解决最坏时间复杂度问题,以及遵循《编程珠玑》指导对插入排序进行展开、变量外提等细节优化,是提升C语言数据处理效率的核心技能。本文将通过具体代码实例与性能对比,解析这两类基础排序算法的高级实现。
双向划分快速排序优化
快速排序由 C.A.R. Hoare 于 1962 年提出。其核心思想是将数组划分为两个部分,分别递归排序:小于基准值(key)的元素位于左侧,大于基准值的元素位于右侧。标准的一次性单向扫描在遇到大量重复元素时,可能导致每次划分的基准值都偏袒一侧,从而退化为 O(n²) 的时间复杂度。
为了解决这个问题,双向划分(Two-way Partitioning)成为优化首选。它使用两个指针分别从数组两端向中间扫描,当左边找到大于 key 的元素且右边找到小于 key 的元素时进行交换,直到两指针相遇或交错。
第1步:构建双向划分快速排序模型
目的:通过双向扫描确保即使面对相同元素构成的数组,也能较均匀地分配左右子区间。
操作说明:
- 选取当前待排序区间的第一个元素
A[l]作为 key。 - 设置左指针
i = l,右指针j = u + 1(注意 j 初始值多 1,因为下方先执行 do-while 循环)。如果区间内元素不足2个,直接返回。 - 进入主循环:
- 左侧递增:只要i <= u 且 A[i] < key,则i++。
- 右侧递减:只要A[j] > key,则j--。
- 检查:若i > j,说明指针已交叉,退出循环;否则,执行swap(i, j)。 - 将 key 放置到最终正确位置:由于最后一步是右边的
j停在了比 key 小或等于的位置(或者是初始边界外的安全区),需执行swap(l, j)。 - 递归调用:对
[l, j-1]和[j+1, u]进行快排。
/* l, u 代表待排序部分的下界和上界 */
void qsort(int l, int u)
{
    /* 递归结束条件:待排序部分元素少于2个 */
    if (l >= u) {
        return;
    }

    int key = A[l];
    for (int i = l, j = u + 1; i <= j;) {
        do i++ while (i <= u && A[i] < key);
        do j-- while (A[j] > key);
        if (i > j) {
            break;
        }
        swap(i, j);
    }
    swap(l, j);

    qsort(l, j - 1);
    qsort(j + 1, u);
}
插入排序的性能极限突破
插入排序在最坏情况下的时间复杂度为 O(n²)。然而,当数据集几乎有序时,其表现极为优异。针对基本无序的小规模数据,普通插入排序主要耗时在内层的频繁移动操作上。《编程珠玑》提供了一套极具代表性的三步优化方案,据书中统计可使效率提升高达 70%。
第1步:原始插入排序(Sort1)——基准对照
目的:建立性能比较的基线。
操作说明:外层遍历每个待插入元素,内层通过 `swap` 函数不断与前一个元素比较并交换位置。虽然逻辑简单,但函数的调用开销在密集的内循环中会被放大。
void insertSort(int *array, size_t size)
{
    for (size_t i = 1; i < size; i++) {
        for (int j = i; j > 0 && array[j - 1] > array[j]; j--) {
            swap(array[j - 1], array[j]);
        }
    }
}
第2步:消除Swap函数调用开销(Sort2)
目的:减少函数跳转与参数压栈开销,提升指令级并行度。
操作说明:将内层 `swap` 宏或函数体直接展开为三行赋值语句。这一步避免了潜在的函数调用成本。
void insertSort(int *array, size_t size)
{
    for (size_t i = 1; i < size; i++) {
        for (int j = i; j > 0 && array[j - 1] > array[j]; j--) {
            int t = array[j];
            array[j] = array[j - 1];
            array[j - 1] = t;
        }
    }
}
第3步:提取常量赋值,改用“滑动赋值”(Sort3)
目的:进一步大幅减少写内存(Write Memory)的次数。在 Sort2 中,每轮内循环都要给变量 `t` 赋相同的值,并且多次修改同一位置内存,这些都是不必要的浪费。
操作说明:
- 在进入内层循环前,先将待插入值备份至临时变量
t。 - 内层循环仅负责将比他大的元素依次向后移动(即执行
array[j] = array[j-1])。 - 当循环结束时(
array[j-1] <= t或到达起点),直接将t写入空出的位置array[j]。
void insertSort(int *array, size_t size)
{
    for (size_t i = 1; i < size; i++) {
        int j = i;
        int t = array[j];  // 将待排序元素暂存
        /* 只有前面的元素大于待排序元素时才后移 */
        for (; j > 0 && array[j - 1] > t; j--) {
            array[j] = array[j - 1];
        }
        array[j] = t;  // 将暂存的元素填入正确位置
    }
}
优化效果验证与总结
通过对上述三种插入排序策略进行实测,《编程珠玑》记录了它们在不同规模数据下的运行时间差异。可以看出优化带来的巨大收益:
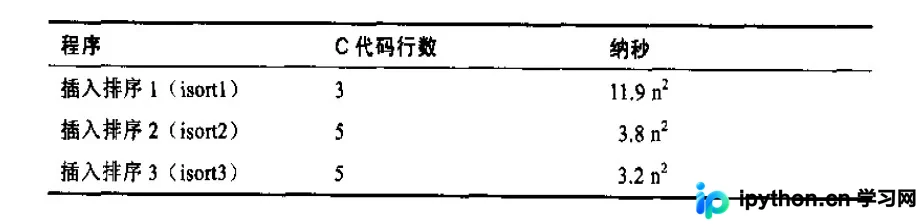
从结果中可以明显看到,经过优化的插入排序在保持代码可读性的前提下,获得了接近翻倍的吞吐量。这证实了“算法本身的结构决定了上限,而微观实现细节决定了实际落地的速度”这一观点。
需要提醒的是,所有的极致优化都需要权衡:过多的预处理逻辑可能会损害代码的可维护性。对于绝大多数场景,标准的库实现(如 C 语言的 qsort)已经足够优秀,但在嵌入式开发、高频交易或对延迟极度敏感的系统中,理解这些底层字节级的优化手段至关重要。
以上就是快速排序和插入排序优化的详细内容,更多关于C语言算法优化的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









