

C语言冒泡排序与堆排序详解:原理、优化与代码实现

本文深入解析C语言中的冒泡排序与堆排序算法。详细阐述冒泡排序的核心思想及其通过交换标记进行的性能优化方法,同时图解大顶堆的构建逻辑与节点调整过程。提供可直接运行的C语言代码实例及复杂度分析,帮助开发者清晰理解并掌握这两种经典排序算法。
一、冒泡排序:原理与优化
第1步:理解冒泡排序核心思想
冒泡排序(Bubble Sort)是一种基础的排序算法。其核心逻辑是“相邻元素两两比较”,若前一个元素大于后一个元素则交换位置。经过一轮遍历,最大或最小的元素会像气泡一样“冒”到序列的一端。虽然效率较低且在实际工程中使用较少,但它作为理解排序逻辑的入门算法极具价值。
算法主要步骤:
- 比较相邻的两个元素。
- 若顺序错误(如要求升序但前大于后),则交换它们。
- 对每一对相邻元素重复上述工作,直到最后一对。
- 针对所有未排序的元素重复以上步骤,直到没有任何一对需要比较。
第2步:执行排序过程演示
以数组 [3, 2, 5, 6, 1, 11] 为例进行排序:
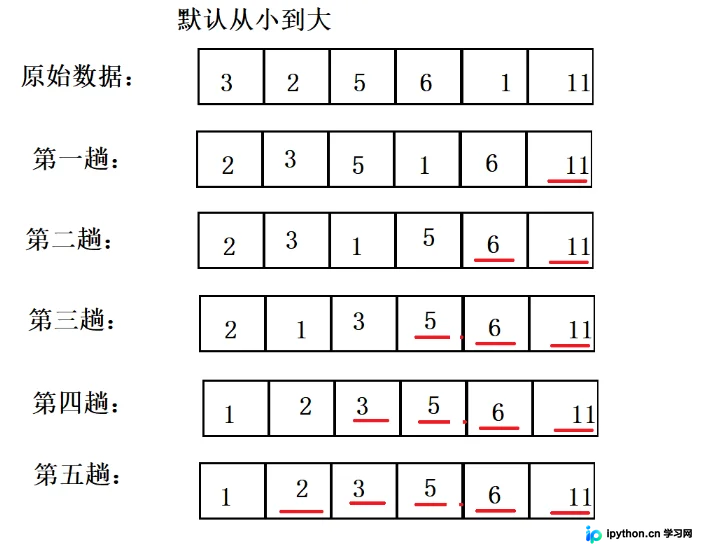
注意事项:
- 图中底部画线的数字表示在该轮次中已经定位到最终位置的元素。
- 对于包含 $n$ 个数据的数组,通常需要运行 $n-1$ 趟比较。
第3步:实施性能优化
观察上述过程,如果在某趟遍历中,所有相邻元素比较均未发生交换,说明数组已经完全有序。此时无需继续后续无意义的遍历,应直接退出循环。为了实现这一判断,我们需要引入一个布尔标记变量(Tag)。
第4步:C语言代码实现与优化
以下代码实现了带终止条件优化的冒泡排序。关键在于在每趟开始前重置标记位,若整趟无交换则标记保持为真,从而触发跳出循环。
void BubbleSort(int* arr, int len)
{
	int count = 0;
	bool tag = true;//标记  首先赋初值为真
	//从头到尾遍历一般,没有交换操作,则可以认定完全有序
	//反过来说:只要有一次交换操作,则不能认定完全有序
	for (int i = 0; i < len - 1; i++)//需要多少趟
	{
		tag = true;//注意:不要忘,每一趟开始的时候,记得将tag重新置为true
		for (int j = 0; j + 1 < len - i; j++)//控制两两比较   j指向两两比较的开始位置
		{
			if (arr[j] > arr[j + 1])
			{
				int tmp = arr[j];
				arr[j] = arr[j + 1];
				arr[j + 1] = tmp;
				tag = false;
			}
		}
		count++;
		if (tag)//如果一趟跑完之后,发现tag没有变,还是真,则代表没有前面大于后面的情况发生,则已经完全有序
		{
			break;
		}
	}
	printf("%d\n", count);
}
第5步:冒泡排序性能分析
- 时间复杂度:
O(n^2) - 空间复杂度:
O(1) - 稳定性:稳定排序
二、堆排序:原理与构建
第1步:认识堆的数据结构
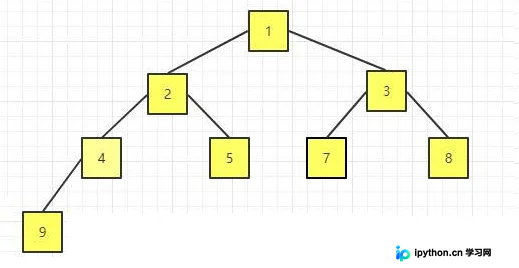
堆(Heap)是一种特殊的完全二叉树结构,分为两种:
- 大顶堆(Max Heap):父节点的值大于或等于左右子节点的值。常用于升序排序。
- 小顶堆(Min Heap):父节点的值小于或等于左右子节点的值。常用于降序排序。
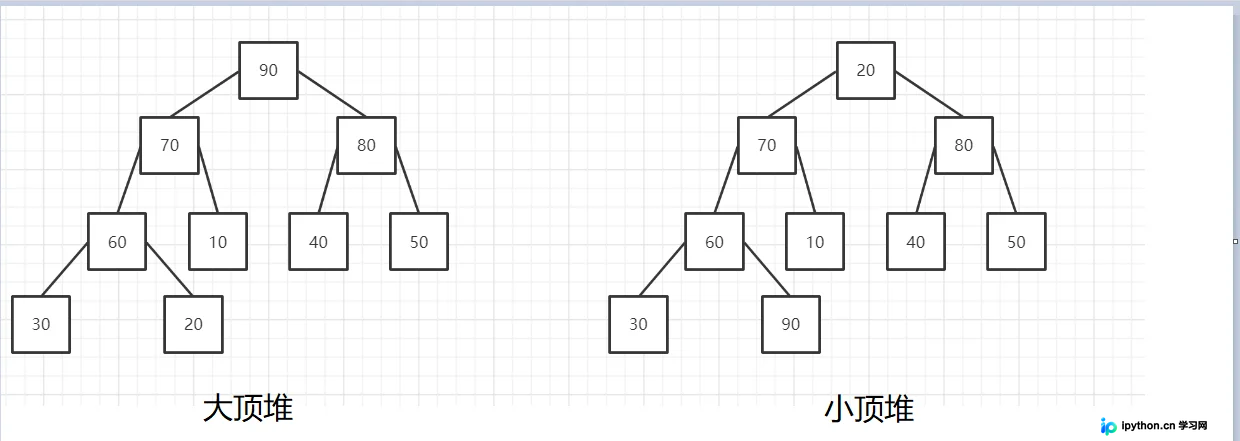
在数组存储模式下,假设当前节点索引为 $i$,则其父子节点索引关系如下:
- 父节点索引:$(i-1)/2$ (向下取整)
- 左孩子索引:$2i + 1$
- 右孩子索引:$2i + 2$
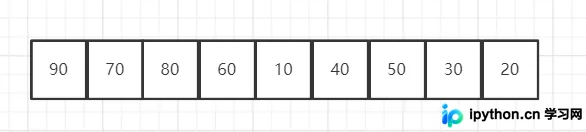
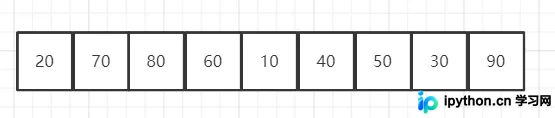
性质推导:
- 大顶堆满足:
arr[i] >= arr[2*i+1] && arr[i] >= arr[2*i+2] - 小顶堆满足:
arr[i] <= arr[2*i+1] && arr[i] <= arr[2*i+2]
第2步:堆排序核心思想与步骤
堆排序利用大顶堆每次获取最大值的特点进行排序。基本流程:
- 将无序数组构造成一个大顶堆,此时根节点即为最大值。
- 将根节点(最大值)与数组末尾元素交换,最大值便归位到末尾。
- 剩余元素不再满足堆性质,需重新调整(仅涉及根节点及其影响范围)以恢复为大顶堆。
- 重复步骤2和3,直至整个数组有序。
第3步:确定初始堆的非叶子节点
构建初始堆时,需要从最后一个非叶子节点开始,自底向上进行调整。对于长度为 $len$ 的数组,最后一个非叶子节点的索引为 (len - 1 - 1) / 2,即 (len - 2) / 2(等价于 $len/2 - 1$)。这是因为叶子节点不需要调整,只有它们的父节点可能需要下移。
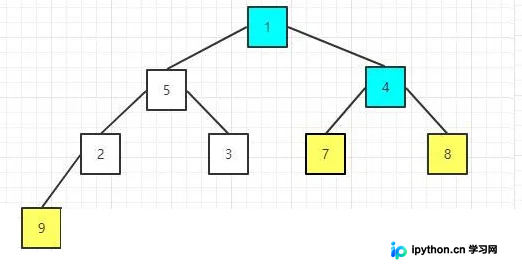
第4步:实例推演(以数组 [4, 5, 8, 2, 3, 9, 7, 1] 为例)
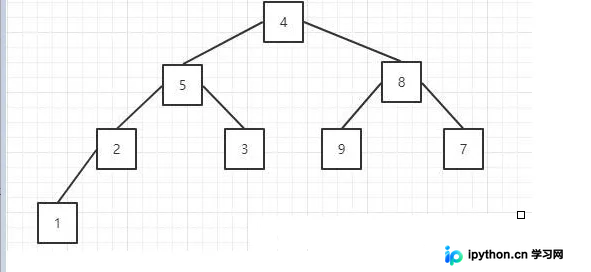
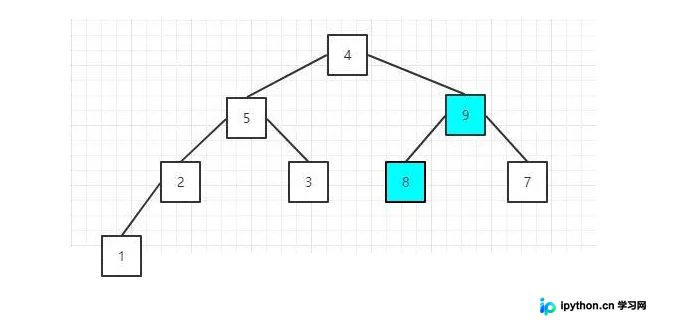
1. 建立初始大顶堆:从最后一个非叶子节点(值为2)开始检查,若无交换需求则跳过;接着处理值为8的节点。由于左孩子9大于8,发生交换。
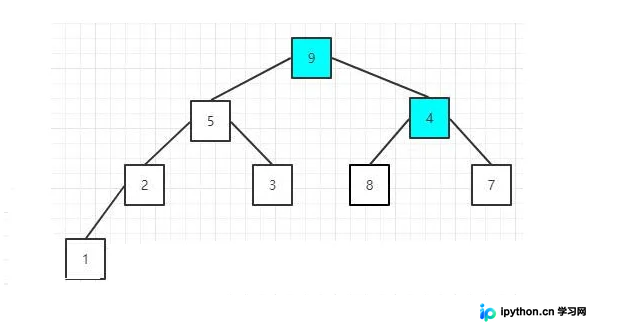
原值为4的根节点因9插入导致不平衡,需再次调整9的位置至根节点。
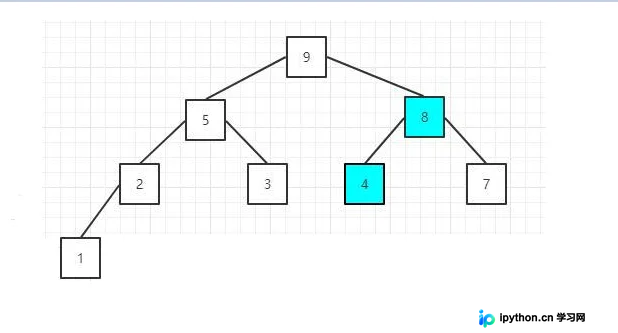
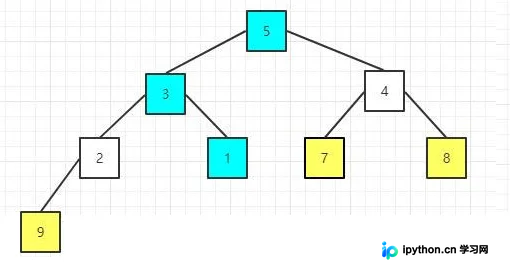
2. 排序阶段(交换与重建):
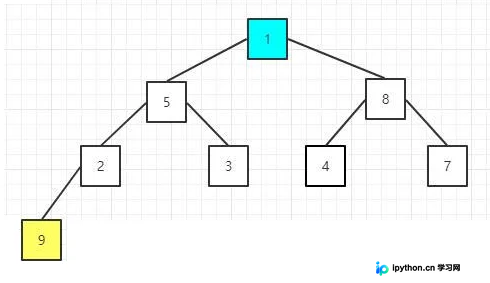
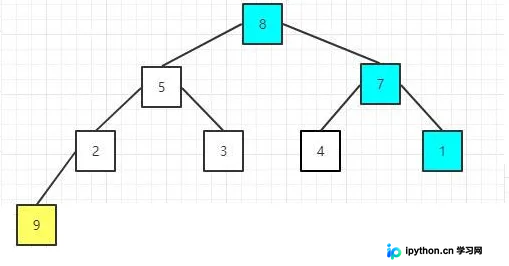
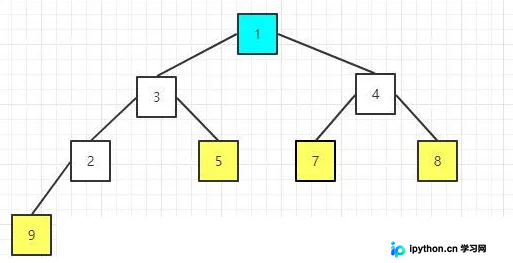
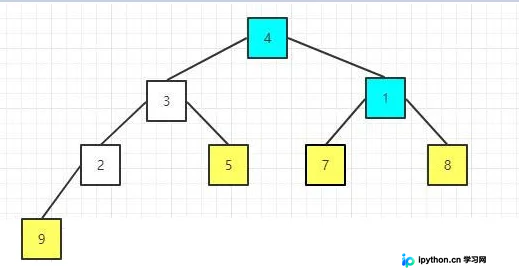
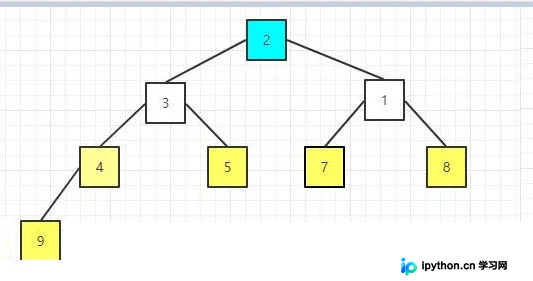
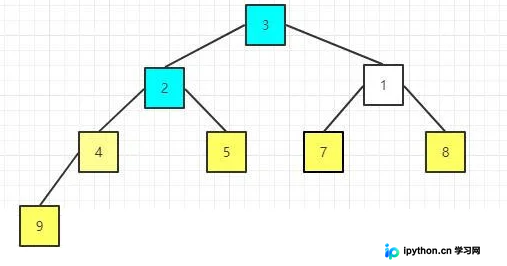
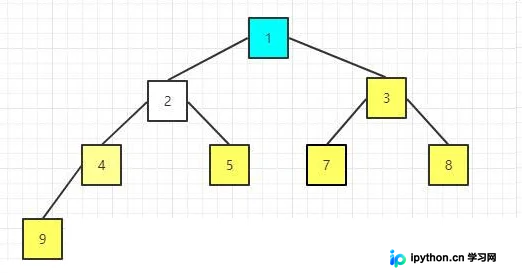
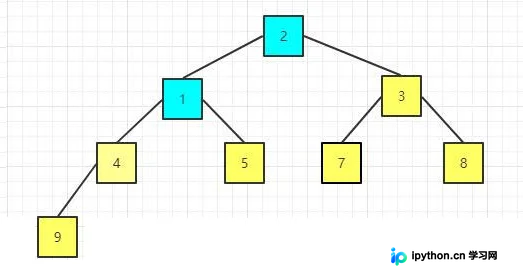
将堆顶8与尾部1交换,然后对剩余长度重新执行堆调整(HeapAdjust):
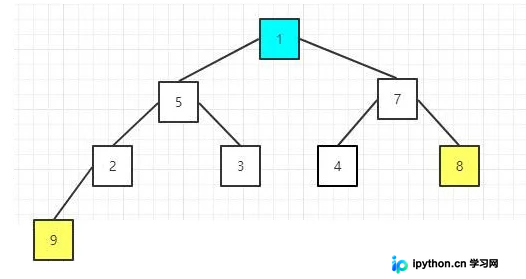
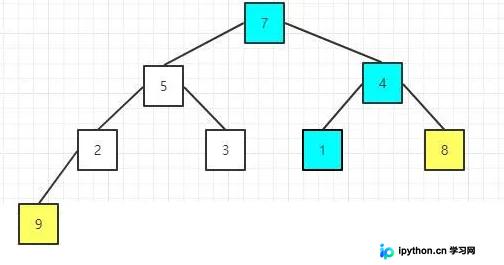
继续交换并将剩余部分视为新的堆进行操作,直到排序完成:
第5步:C语言代码实现
堆排序包含两个关键函数:HeapAdjust 用于单次调整,HeapSort 用于整体调度。
void HeapAdjust(int arr[], int start, int end)
{
	//assert
	int tmp = arr[start];
	for (int i = start * 2 + 1; i <= end; i = start * 2 + 1)//start*2+1 相当于是start这个节点的左孩子
	{                     //i<end  退出for循环  触发的是情况1
		if (i<end && arr[i + 1] > arr[i])//i<end 代表存在右孩子,且右孩子的值还大于左孩子
		{
			i++;//则此时,让i指向右孩子
		}
		//此时i肯定已经指向较大的那个孩子
		if (arr[i] > tmp)//子大于父
		{
			arr[start] = arr[i];
			start = i;
		}
		else
		{
			break;//退出for循环,触发情况2
		}
	}
	arr[start] = tmp;
}
void HeapSort(int* arr, int len)
{
	//1.整体从最后一个非叶子节点开始由内到外调整一次
	//首先需要知道最后一个非叶子节点的下标
	for (int i = (len - 1 - 1) / 2; i >= 0; i--)//因为最后一个非叶子节点肯定是 最后一个叶子节点的父节点
	{
		HeapAdjust(arr, i, len - 1);//调用我们一次调整函数  //这里第三个值比较特殊,没有规律可言,则直接给最大值len-1
	}
	//此时,已经调整为大顶堆了
	//接下来,根节点的值和当前最后一个节点的值进行交换,然后将尾结点剔除掉
	for (int i = 0; i < len - 1; i++)
	{
		int tmp = arr[0];
		arr[0] = arr[len - 1 - i];//len-1-i 是我们当前的尾结点下标
		arr[len - 1 - i] = tmp;
		HeapAdjust(arr, 0, (len - 1 - i) - 1);//len-1-i 是我们当前的尾结点下标,然后再给其-1则相当于将其剔除出我们的循环
	}
}
第6步:堆排序性能分析
- 时间复杂度:最好和最坏情况均为
O(n log n)。建堆耗时O(n),随后的 n-1 次调整每次耗时O(log n)。 - 空间复杂度:
O(1),原地排序。 - 稳定性:不稳定。因为在交换堆顶与末尾元素以及后续下沉过程中,相等元素的相对位置可能改变。
以上就是C语言冒泡排序与堆排序的详细原理、图解分析与代码实现,更多关于C语言算法与数据结构的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









