

SQL DISTINCT 语法详解与常见误区

在SQL数据库中,表数据可能包含重复项。当需要获取唯一的记录列表时,需要使用 DISTINCT 关键字。本文将演示如何使用它进行单列或多列的去重操作,并纠正常见的语法误区。
DISTINCT 基本用法与结果呈现
DISTINCT 用于从查询结果中提取唯一的值组合。为了便于理解,假设存在如下数据表结构(表A):
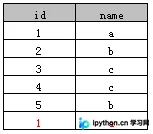
第一步:单字段去重
目的:筛选表中某个字段不重复的记录。
操作:
SELECT DISTINCT name FROM A;
结果说明:系统将移除 name 字段中相同的行,仅保留唯一的名称列表。

第二步:多字段组合去重
目的:根据多个字段的组合结果来排除完全相同的记录行。
操作:
SELECT DISTINCT name, id FROM A;
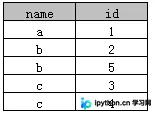
原理解析:此时去重的依据是 name 和 id 的组合值。只有当这两个字段的值同时与其他行的对应字段都不同时,才会被保留。这种用法广泛支持于 SQL Server 等主流数据库系统中。
统计功能的使用限制
DISTINCT 常与聚合函数 COUNT 配合使用以计算唯一值的数量,但不同数据库对多列处理的支持存在差异:
- 标准写法:
SELECT COUNT(DISTINCT name) FROM A;
这将返回去重后的name数量。在 SQL Server 中支持此写法;在部分旧版 Access 环境中可能存在兼容性问题。 - 多列统计:
SELECT COUNT(DISTINCT name, id) FROM A;
需要注意的是,许多常见数据库系统(包括早期的 Access 和部分版本的 SQL Server)并不原生支持这种直接对多列进行 distinct 计数的方式,执行可能会报错。
关键约束与常见错误排查
错误示范:位置摆放不当
现象:SELECT id, DISTINCT name FROM A; 会提示语法错误。
原因:DISTINCT 必须紧跟在 SELECT 关键字之后,作为第一个修饰符出现,不能放在字段中间。
扩展性限制:无法直接关联未去重字段
DISTINCT 的核心逻辑是“去重”,因此其 SELECT 子句中列出的字段,必须是参与去重判定的字段。例如,如果表 A 还有“备注”列,当你只想查看去重后的 name 及其对应的“备注”内容时,直接使用 SELECT DISTINCT name, note FROM A 会导致原本因为 name 相同应合并的行,因 note 不同而无法去重,这通常不是你想要的效果。
如果需要将多行内容拼接显示或进行复杂的数据清洗,建议结合子查询或窗口函数等其他 SQL 技术来解决,而非单纯依赖 DISTINCT。
以上就是SQL DISTINCT语法的详细内容,更多关于SQL去重技巧的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









