

PostgreSQL函数与操作符:逻辑、数学、字符串及位串详解

本文详解PostgreSQL的核心数据处理工具,从基础逻辑、数学与字符串运算到高级位串操作,提供清晰的参数说明与实操示例,助力开发者精准操控数据。
一、 逻辑与比较操作的基础应用
在处理查询条件时,逻辑操作符是最基础的筛选工具。PostgreSQL中的 AND、OR 和 NOT 语义与主流编程语言保持一致,用于组合多个布尔条件。
除了基本的布尔逻辑,数据库提供了丰富的比较操作符(如等于、大于、小于等)。正如下文所示:
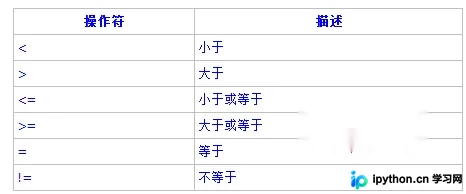
这些操作符作用于所有可比较的数据类型,均为双目操作符且返回布尔值(boolean)。为了简化范围判断,可以使用以下等效语句:
a BETWEEN x AND y:等效于a >= x AND a <= y,用于包含边界的区间判断。a NOT BETWEEN x AND y:等效于a < x OR a > y,用于排除中间区间的判断。
二、 数值运算与常用数学函数
在数值处理方面,PostgreSQL区分了标准算术与按位运算。标准的四则运算适用于所有数值类型,而按位操作符(如位与、位或等)仅支持整数、位串(bit/bit varying)等特定类型。基础操作符列表如下:
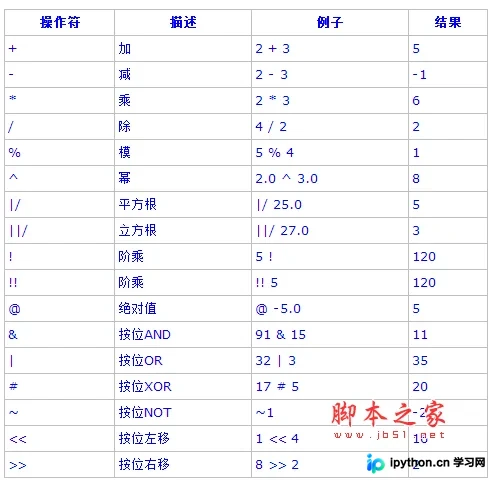
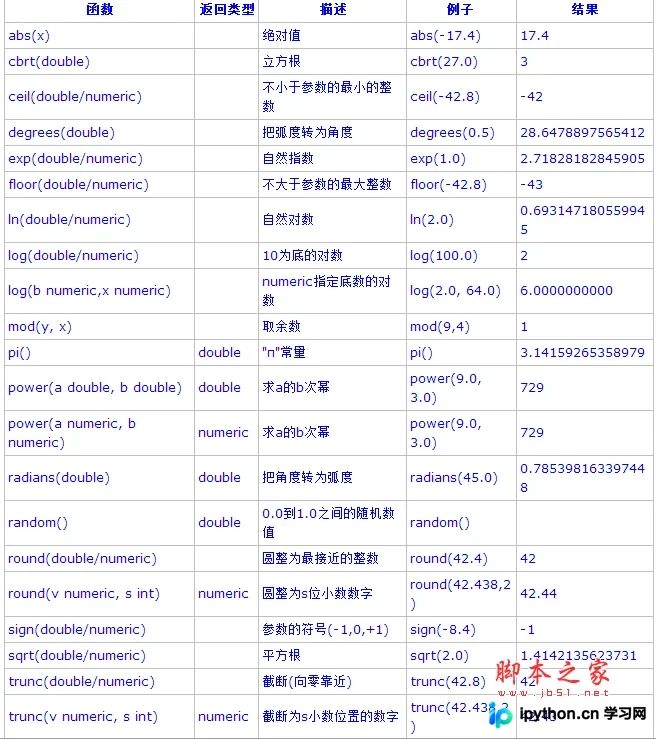
当需要进行更复杂的计算时,可以调用内置的数学函数(包括绝对值、取整、幂运算等)。需要注意的是,绝大多数同名函数的不同变体仅在参数数据类型上有所区别,其返回值类型通常与输入参数的类型保持一致(除非另有明确说明)。具体函数列表如下:
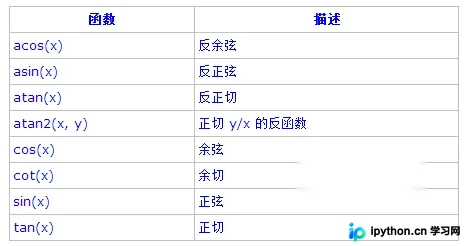
针对几何或坐标计算场景,三角函数也是不可或缺的辅助工具,包括但不限于正弦(sin)、余弦(cos)等,完整列表见下图:
三、 字符串函数的全面运用
文本处理是日常开发的高频需求。PostgreSQL提供了众多操作符和函数来实现字串的拼接、长度统计、编码转换及字符替换。以下是核心字符串函数及其实际应用的梳理:
| 函数/操作符 | 返回类型 | 描述 | 例子 | 结果 |
| string || string | text | 字串连接 | 'Post' || 'greSQL' | PostgreSQL |
| bit_length(string) | int | 字串里二进制位的个数 | bit_length('jose') | 32 |
| char_length(string) | int | 字串中的字符个数 | char_length('jose') | 4 |
| convert(string using conversion_name) | text | 使用指定的转换名字改变编码。 | convert('PostgreSQL' using iso_8859_1_to_utf8) | 'PostgreSQL' |
| lower(string) | text | 把字串转化为小写 | lower('TOM') | tom |
| octet_length(string) | int | 字串中的字节数 | octet_length('jose') | 4 |
| overlay(string placing string from int [for int]) | text | 替换子字串 | overlay('Txxxxas' placing 'hom' from 2 for 4) | Thomas |
| position(substring in string) | int | 指定的子字串的位置 | position('om' in 'Thomas') | 3 |
| substring(string [from int] [for int]) | text | 抽取子字串 | substring('Thomas' from 2 for 3) | hom |
| substring(string from pattern) | text | 抽取匹配 POSIX 正则表达式的子字串 | substring('Thomas' from '...$') | mas |
| substring(string from pattern for escape) | text | 抽取匹配SQL正则表达式的子字串 | substring('Thomas' from '%#"o_a#"_' for '#') | oma |
| trim([leading | trailing | both] [characters] from string) | text | 从字串string的开头/结尾/两边/ 删除只包含characters(缺省是一个空白)的最长的字串 | trim(both 'x' from 'xTomxx') | Tom |
| upper(string) | text | 把字串转化为大写。 | upper('tom') | TOM |
| ascii(text) | int | 参数第一个字符的ASCII码 | ascii('x') | 120 |
| btrim(string text [, characters text]) | text | 从string开头和结尾删除只包含在characters里(缺省是空白)的字符的最长字串 | btrim('xyxtrimyyx','xy') | trim |
| chr(int) | text | 给出ASCII码的字符 | chr(65) | A |
| convert(string text, [src_encoding name,] dest_encoding name) | text | 把字串转换为dest_encoding | convert( 'text_in_utf8', 'UTF8', 'LATIN1') | 以ISO 8859-1编码表示的text_in_utf8 |
| initcap(text) | text | 把每个单词的第一个子母转为大写,其它的保留小写。单词是一系列字母数字组成的字符,用非字母数字分隔。 | initcap('hi thomas') | Hi Thomas |
| length(string text) | int | string中字符的数目 | length('jose') | 4 |
| lpad(string text, length int [, fill text]) | text | 通过填充字符fill(缺省时为空白),把string填充为长度length。 如果string已经比length长则将其截断(在右边)。 | lpad('hi', 5, 'xy') | xyxhi |
| ltrim(string text [, characters text]) | text | 从字串string的开头删除只包含characters(缺省是一个空白)的最长的字串。 | ltrim('zzzytrim','xyz') | trim |
| md5(string text) | text | 计算给出string的MD5散列,以十六进制返回结果。 | md5('abc') | |
| repeat(string text, number int) | text | 重复string number次。 | repeat('Pg', 4) | PgPgPgPg |
| replace(string text, from text, to text) | text | 把字串string里出现地所有子字串from替换成子字串to。 | replace('abcdefabcdef', 'cd', 'XX') | abXXefabXXef |
| rpad(string text, length int [, fill text]) | text | 通过填充字符fill(缺省时为空白),把string填充为长度length。如果string已经比length长则将其截断。 | rpad('hi', 5, 'xy') | hixyx |
| rtrim(string text [, character text]) | text | 从字串string的结尾删除只包含character(缺省是个空白)的最长的字 | rtrim('trimxxxx','x') | trim |
| split_part(string text, delimiter text, field int) | text | 根据delimiter分隔string返回生成的第field个子字串(1 Base)。 | split_part('abc~@~def~@~ghi', '~@~', 2) | def |
| strpos(string, substring) | text | 声明的子字串的位置。 | strpos('high','ig') | 2 |
| substr(string, from [, count]) | text | 抽取子字串。 | substr('alphabet', 3, 2) | ph |
| to_ascii(text [, encoding]) | text | 把text从其它编码转换为ASCII。 | to_ascii('Karel') | Karel |
| to_hex(number int/bigint) | text | 把number转换成其对应地十六进制表现形式。 | to_hex(9223372036854775807) | 7fffffffffffffff |
| translate(string text, from text, to text) | text | 把在string中包含的任何匹配from中的字符的字符转化为对应的在to中的字符。 | translate('12345', '14', 'ax') | a23x5 |
四、 位串(Bit String)的特殊处理
对于位串类型(即 bit 和 bit varying),除了上述通用的字符串处理函数外,PostgreSQL还专门提供了一批位运算函数和操作符。使用时需注意两点:
1. 参与 &(与)、|(或)和 #(异或)操作的位串必须长度一致。
2. 在进行移位运算时,系统会保留原始位串的长度,不会因位移而导致数据丢失或自动补零溢出。
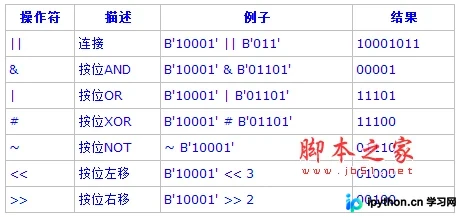
第一步:准备整数与位串的转换环境
在实际开发中,经常需要在整型(integer/bigtint)与位串之间进行双向转换,以进行底层的校验或状态掩码处理。这要求我们在输入时显式指定目标位串的长度(例如 bit(10)),否则系统将默认转换为 bit(1),导致高位数据被截断。请在数据库中执行以下命令进行测试与验证:
-- 将整数44转换为10位的二进制表示

MyTest=# SELECT 44::bit(10);

 bit

 ------------

  0000101100

 (1 row)


-- 注意位宽限制:如果目标位宽不足,会被截断

MyTest=# SELECT 44::bit(3);

 bit

 -----r />  100

 (1 row)


-- 负数的处理:将 -44 转换为12位的二进制表示

MyTest=# SELECT cast(-44 as bit(12));

     bit

 --------------

  111111010100

 (1 row)


-- 逆向转换:将位串 '1110' 转换为十进制整数

MyTest=# SELECT '1110'::bit(4)::integer;

 int4

 ------

    14

 (1 row)
特别提醒:若未显式声明位宽直接转换为 "bit" 类型(默认为 bit(1)),最终获取的将仅仅是原整数最低位(Least Significant Bit)的二进制值,这在逻辑判断中极易引发偏差,务必留意。
以上就是PostgreSQL逻辑、数学、字符串及位串相关函数与操作符的详细内容,更多关于数据库优化的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









