


很多团队第一次考虑物化视图,往往是因为一条统计 SQL 已经慢到影响接口或报表体验,但又不值得为此单独维护一套缓存系统。真正需要先判断的,不是“能不能建”,而是查询是否足够重、业务是否接受延迟,以及后续刷新和口径维护能不能长期稳定。
这篇文章把物化视图最常见的适用场景和踩坑点拆开来说:哪些查询适合提前算好并落盘,哪些场景更适合继续用普通视图、索引或缓存,以及 PostgreSQL、KingbaseES 在刷新和改写上的关键限制分别是什么。
什么场景最适合用物化视图
物化视图适合这样一类问题:查询会被反复执行,实时计算代价很高,但业务可以接受几分钟到几小时的数据延迟。与普通视图不同,它会把查询结果真正存储下来,因此不需要在每次访问时重新做大表扫描、聚合和多表关联。
如果只是偶发慢查询,或者业务必须读取秒级实时数据,物化视图通常不是最佳选择;但如果查询本身长期稳定、访问频率高,又能接受“快照式结果”,它就可能比继续堆索引更直接。
历史报表和留存统计:慢查询换成快照读取
最典型的使用场景,是 BI 报表、GMV 汇总、游戏次留统计这类历史分析型查询。它们往往需要扫描亿级事实表,JOIN 5 张以上的表,还包含 SUM、GROUP BY 和窗口函数,单次执行时间常见在 2 到 5 分钟。
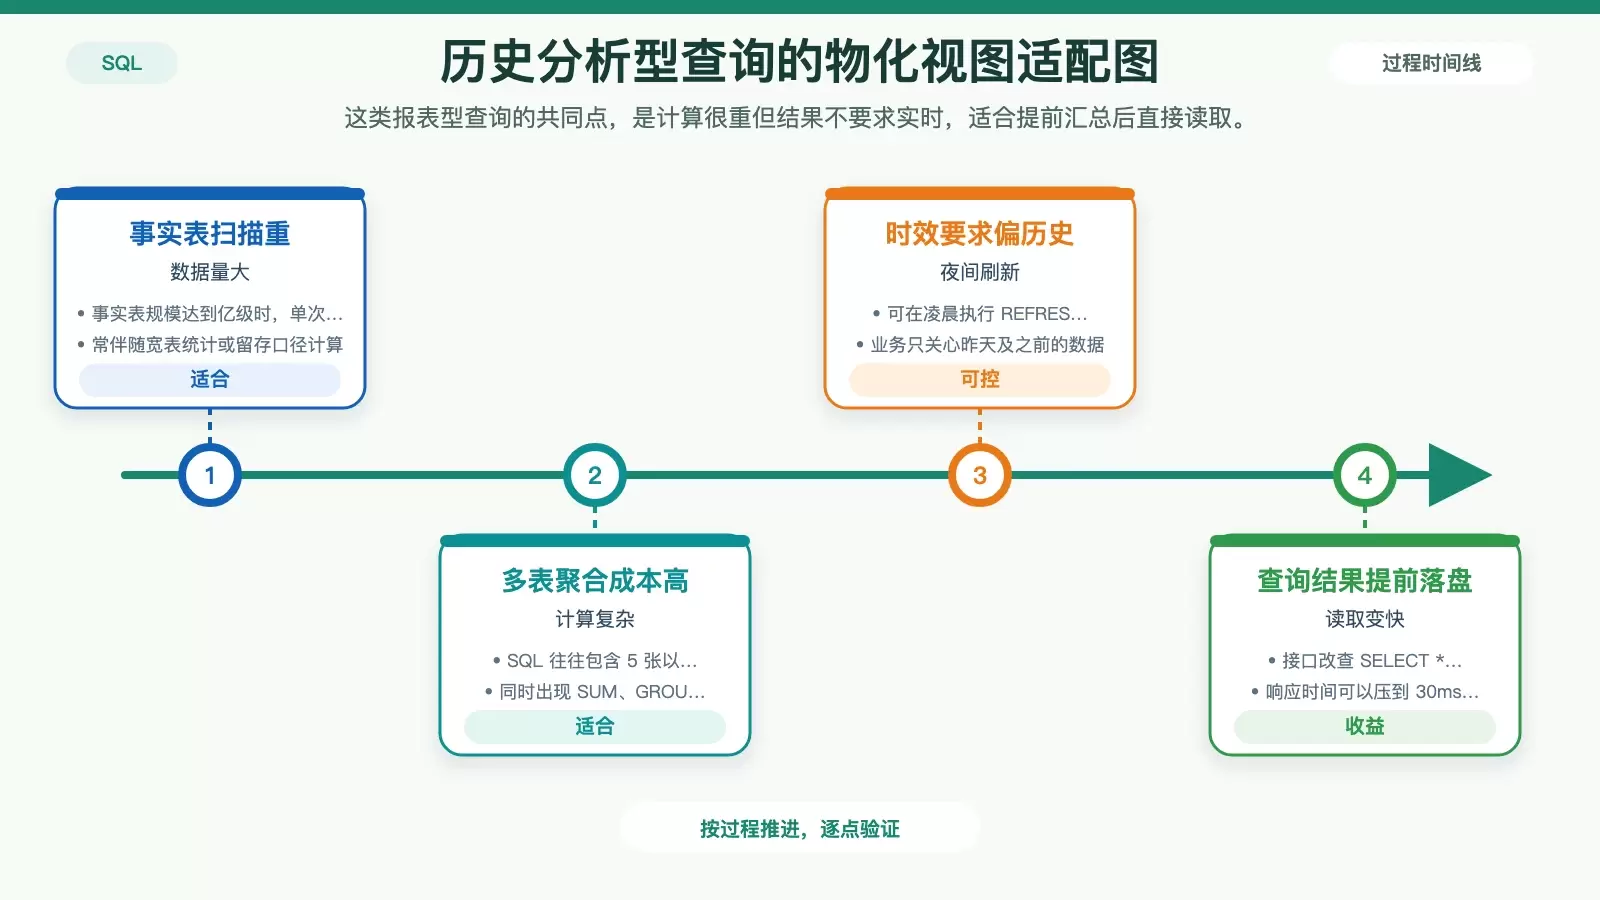
这类查询之所以适合物化视图,不在于 SQL 写得复杂,而在于业务只关心“昨天及之前”的数据,并不要求实时结果。把每天固定口径的聚合结果提前算好,接口只查物化视图即可。
- 凌晨执行一次
REFRESH MATERIALIZED VIEW CONCURRENTLY全量刷新,接口侧直接查询SELECT * FROM mv_gmv_daily,响应可压到 30ms 内。 - 字段和分组口径必须稳定。如果今天按天汇总、明天又要按小时统计,原先的物化逻辑就会失效。
- 上游基表更适合只读或 insert-only 场景,例如 CDC 同步库。若频繁出现
UPDATE或DELETE,增量刷新更容易出问题。
判断依据
如果一条分析 SQL 同时满足“执行很慢”“访问很多”“结果不要求实时”“统计口径相对稳定”,那它通常就是物化视图的优先候选对象。
高频统计接口:不想维护 Redis 时的折中方案
另一类常见场景,是后端服务反复调用重型统计接口,例如库存汇总、用户活跃宽表,每分钟都要查一次,但业务层面允许 5–10 分钟延迟。
这种情况下,物化视图往往比额外引入 Redis 更轻。原因不是它一定更快,而是工程维护成本更低:不用单独写定时任务,不需要处理 JSON 序列化和反序列化,查询仍然走标准 SQL,也能继续使用数据库索引与事务一致性能力。
- 开发侧可以继续写普通查询语句,不必因为缓存层而改造一整套读写逻辑。
- DBA 可以通过
last_refresh字段直接监控数据时效,比散落在业务代码里的缓存更新逻辑更容易统一管理。 - 如果基表变化很快,例如每秒上百次
INSERT,全量刷新可能反过来拖慢系统,这时要考虑分区增量刷新,或者增加grace_period。
它和 Redis 的区别在哪
Redis 更适合低延迟、灵活失效和应用层自定义缓存;物化视图更适合以 SQL 为中心的统计结果固化。前者强调通用缓存能力,后者强调把复杂查询结果以数据库对象形式托管起来。
多方共用数据时,用物化视图统一权限和脱敏
物化视图不只是为性能服务,也适合做统一的数据访问出口。多个业务方共用同一套底层数据时,经常会遇到权限和脱敏规则不一致的问题:财务只能看脱敏身份证,运营需要拼接组织架构,风控还要叠加行级过滤。
这时可以把通用过滤、脱敏表达式和多表 JOIN 一起封进物化视图,再分别给不同账号授 SELECT 权限。这样既减少应用层重复实现,也更容易把敏感字段访问控制集中在数据库侧。
- 例如可把脱敏逻辑写成
substr(id_card, 1, 6) || '****' || substr(id_card, -4),并与其他过滤规则一起固化到视图定义中。 - 权限逻辑统一由 DBA 维护,能减少不同系统各自拼装 SQL 时带来的口径和安全风险。
MATERIALIZED VIEW本质上是只读快照,不支持INSERT/DELETE/ALTER,不能把它当普通表使用。
刷新策略配不对,物化视图很容易白建
物化视图最容易被低估的部分,不是创建语法,而是刷新策略和基表变化之间的联动。只要这部分没有设计好,再快的首次查询也难以长期成立。
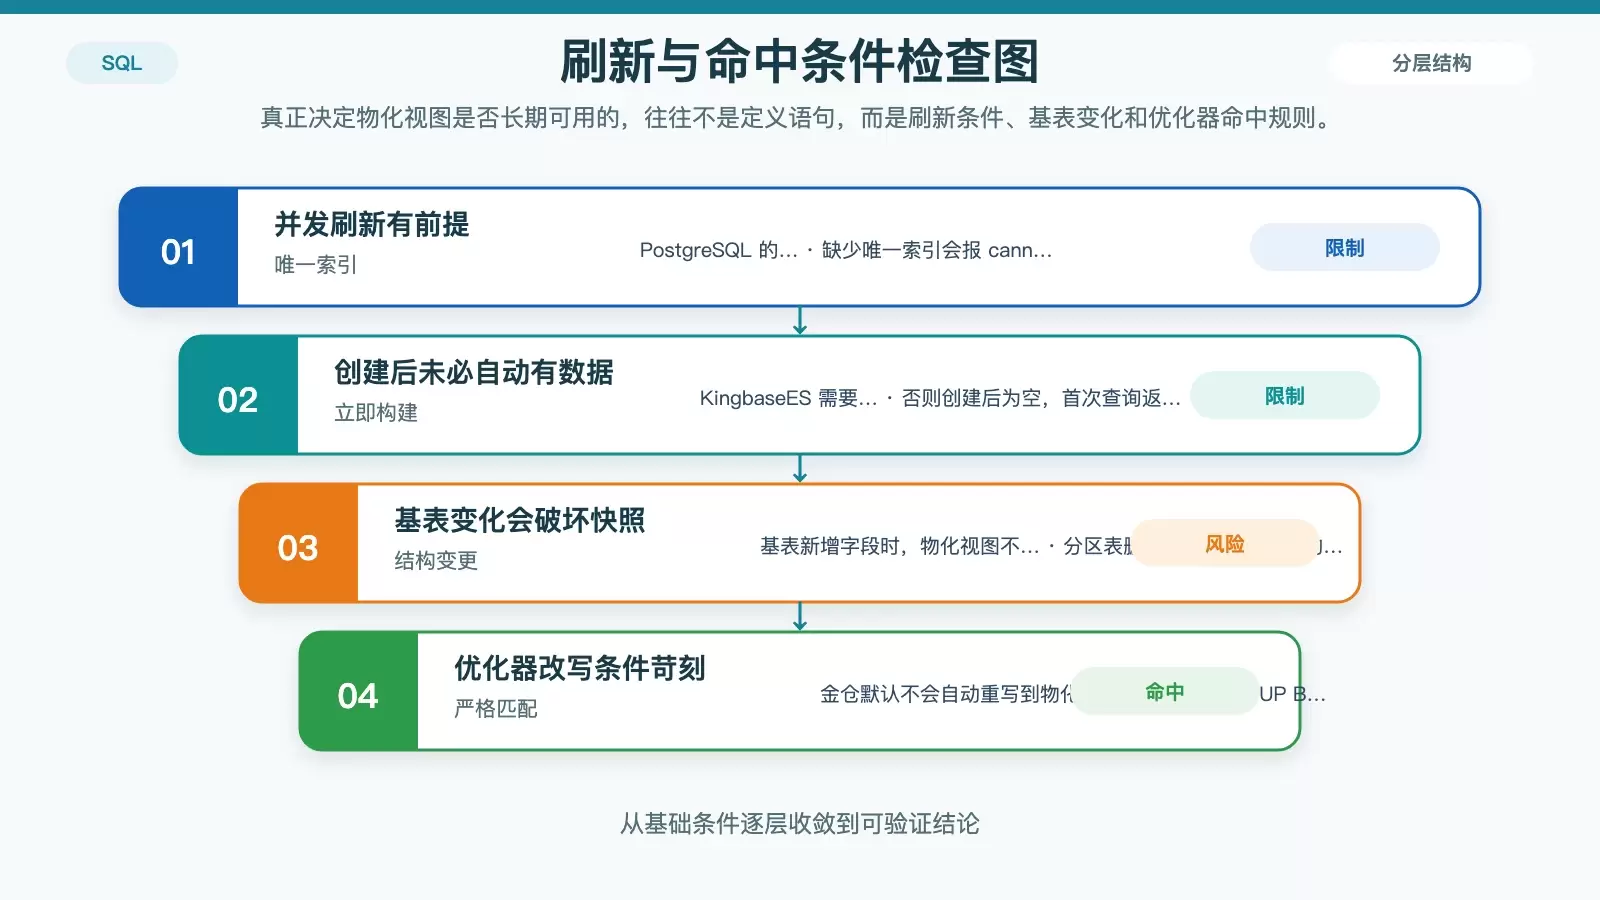
例如基表新增字段后,物化视图不会自动同步;分区表删除旧分区后,对应的物化视图分区也可能失效。更麻烦的是,某些数据库即使支持物化视图,优化器也未必会自动改写到它,结果仍可能退化成直接查询基表。
- 在 PostgreSQL 中,
REFRESH CONCURRENTLY要求源表存在唯一索引,否则会报错cannot refresh concurrently without a unique index。 - 在 KingbaseES 中,创建时必须显式指定
BUILD IMMEDIATE,否则建完后内容为空,首次查询会返回 0 行。 - 金仓默认不会自动重写 SQL,必须让
WHERE条件、GROUP BY字段、聚合函数与物化视图定义完全一致,包括别名和函数写法。
上线前至少确认这几件事
一是刷新频率是否与业务时效要求匹配,二是基表是否具备支撑并发刷新或增量刷新的条件,三是查询口径是否足够稳定,四是数据库优化器是否真的能命中物化视图。缺少其中任何一项,物化视图都可能只是在账面上看起来合理。
结论:它适合“重查询 + 可延迟 + 稳口径”的组合
什么时候该用 SQL 物化视图,核心判断可以收敛为三个条件:查询重、调用频繁、业务接受延迟。再往下看,若统计字段和分组口径长期稳定、基表更新模式可控、刷新机制有明确方案,那么物化视图通常能把分钟级查询压缩到毫秒级读取。
反过来说,如果数据要求强实时、查询口径经常变化、基表结构和分区频繁调整,或者数据库本身难以稳定命中物化视图,那它就不一定比普通索引、分区设计或 Redis 缓存更划算。









