


在 Linux 上跑 Node.js,真正难的往往不是把服务启动起来,而是出了问题后能不能第一时间看清问题出在哪一层。CPU 飙高、内存上涨、请求变慢、服务反复重启,这些现象背后需要的监控手段并不一样。本文按常见使用场景把几类工具拆开说明:先看能快速救火的基础命令,再看适合日常运维的进程管理工具,最后再看日志平台、APM 和 Node.js 自带分析能力分别适合处理什么问题。
为什么 Node.js 监控不能只靠一种工具
Node.js 应用的运行状态,至少涉及几个层面:进程是否存活、CPU 和内存是否异常、日志里有没有错误、请求链路是否变慢、数据库调用是否拖垮整体响应。单一工具通常只能解决其中一部分问题。
因此更实用的做法不是追求“万能方案”,而是按场景组合:
- 临时排查,先看
top或htop。 - 日常托管与实例状态查看,用 PM2。
- 开发期自动重启与存活反馈,用
nodemon。 - 深入看性能瓶颈,用 Node.js 内置 Profiler 或 APM。
- 长期追踪错误与上下文,靠日志和 ELK。
先用 top 和 htop 快速确认进程状态
如果你只是想立刻知道某个 Node.js 进程当前占了多少 CPU、吃了多少内存,top 依然是 Linux 下最直接的入口。它不需要额外安装,适合线上机器的第一时间检查。
htop 可以看作是更易读的升级版。界面更直观,支持鼠标操作,进程排序和筛选也更方便。遇到突发性能问题时,这类工具的价值很明确:先确认是不是资源打满,再决定后续要不要进入日志、Profiler 或 APM 层面继续追。
这类工具的局限也很明显。它们能告诉你“哪一个进程很忙”,但不能直接解释“为什么它很忙”。所以它们更适合作为第一道观察窗口,而不是完整的监控体系。
日常运维和开发环境,PM2 与 nodemon 各负责什么
PM2:进程管理和基础监控一起做
PM2 在 Node.js 生态里很常见,核心价值首先是进程管理,其次才是监控。对于单机部署、小中型服务或希望快速建立基本运维能力的团队来说,PM2 的门槛很低。
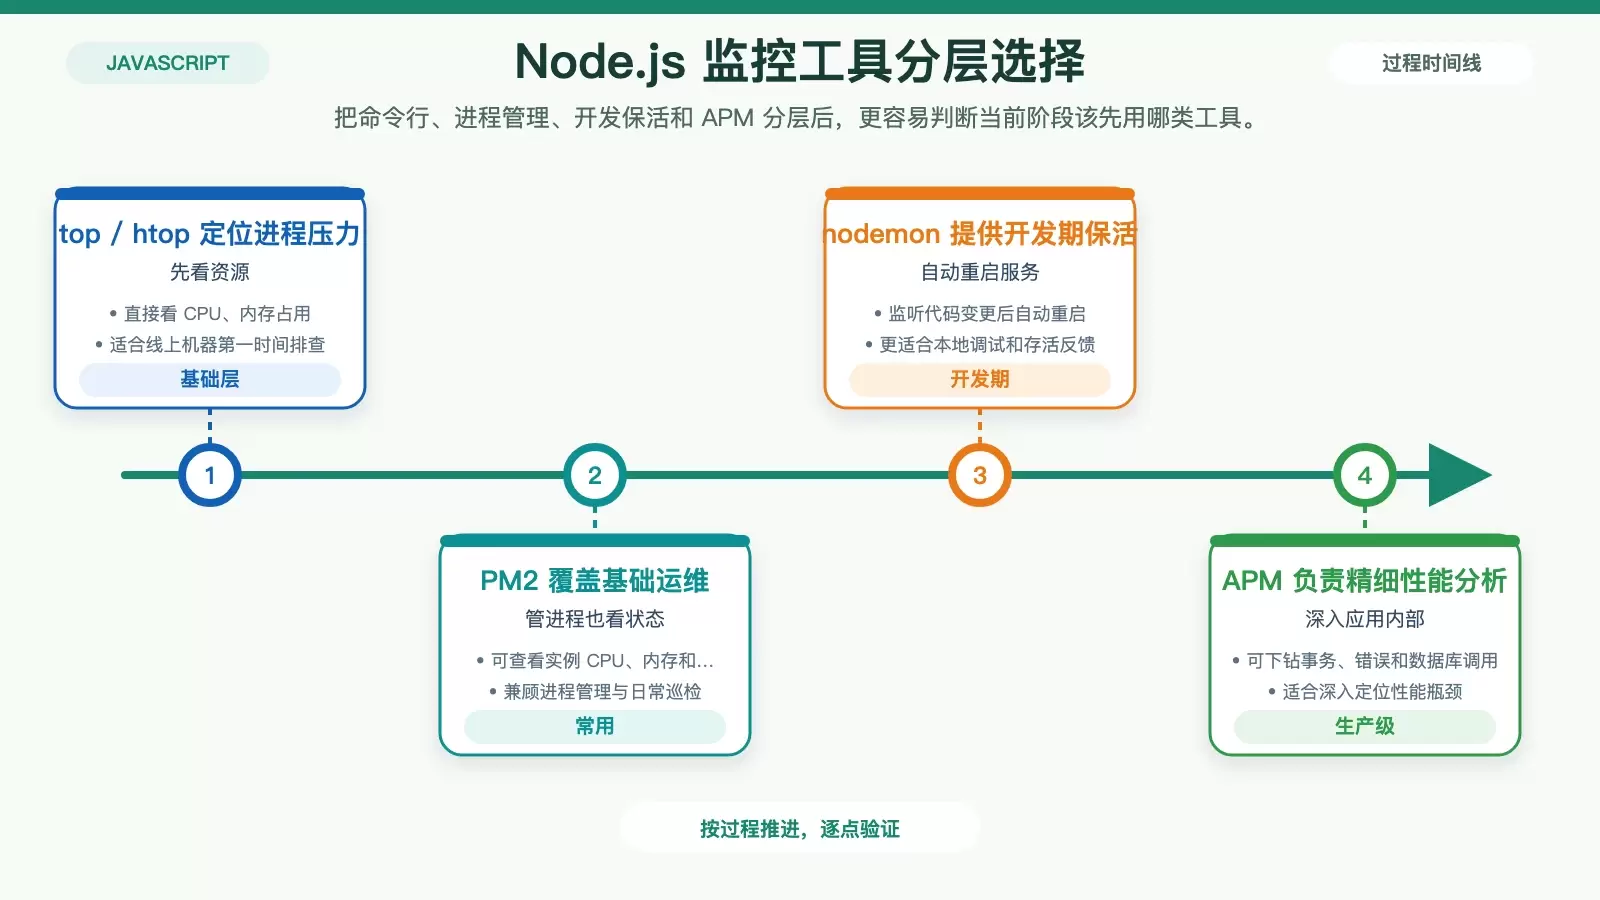
通过 pm2 monit,可以直接查看每个应用实例的 CPU、内存和日志输出。它不一定能替代专业监控平台,但对日常巡检、快速定位实例异常已经很实用。
安装方式:
npm install pm2 -g启动应用:
pm2 start app.js进入监控面板:
pm2 monit如果你的目标是“把服务稳定跑起来,并且顺手看到基本指标”,PM2 往往是性价比很高的第一步。
nodemon:它不是性能监控,但适合开发期保活
nodemon 的主要职责并不是性能分析,而是监听代码变更后自动重启服务。不过在开发环境里,这种能力本身就能提供一种很基础的运行状态反馈:应用是否正常启动、修改后是否立即生效、崩溃后是否快速重启。
因此,nodemon 更适合本地开发和调试阶段,而不是线上性能监控工具。
安装:
npm install nodemon -g使用:
nodemon app.js进入生产环境后,什么时候该上 APM 平台
New Relic:更偏应用内部性能细节
如果应用已经进入生产环境,而且你需要的不只是“进程还活着”,而是想知道某个事务为什么慢、哪类数据库查询最耗时、错误集中在哪个调用路径,那么 New Relic 这类 APM 工具就开始显出价值。
它的重点在于深入应用内部,收集事务耗时、数据库查询、错误追踪等指标,再通过可视化仪表板展示出来。相比基础命令行工具,这类平台更适合定位真正的性能瓶颈。
Datadog:更适合基础设施更复杂的团队
Datadog 和 New Relic 同样属于成熟监控平台,但侧重点更偏全栈统一视图。除了 Node.js 应用本身,它还能把服务器、数据库、容器和日志一起纳入同一个监控体系。
如果你的环境已经不是单机或单服务,而是涉及多台主机、多个依赖组件,甚至容器化部署,那么 Datadog 的整合能力通常更有优势。它适合回答的不只是“这个 Node.js 接口慢不慢”,而是“整条链路里到底是哪一层出了问题”。
日志文件和 ELK,负责把问题上下文补完整
日志仍然是最后一道防线
无论监控平台多完善,日志都不应该被省略。很多问题在指标上只表现为 CPU 升高、响应变慢,但真正能解释原因的,往往还是错误栈、请求参数、重试记录和关键业务节点日志。
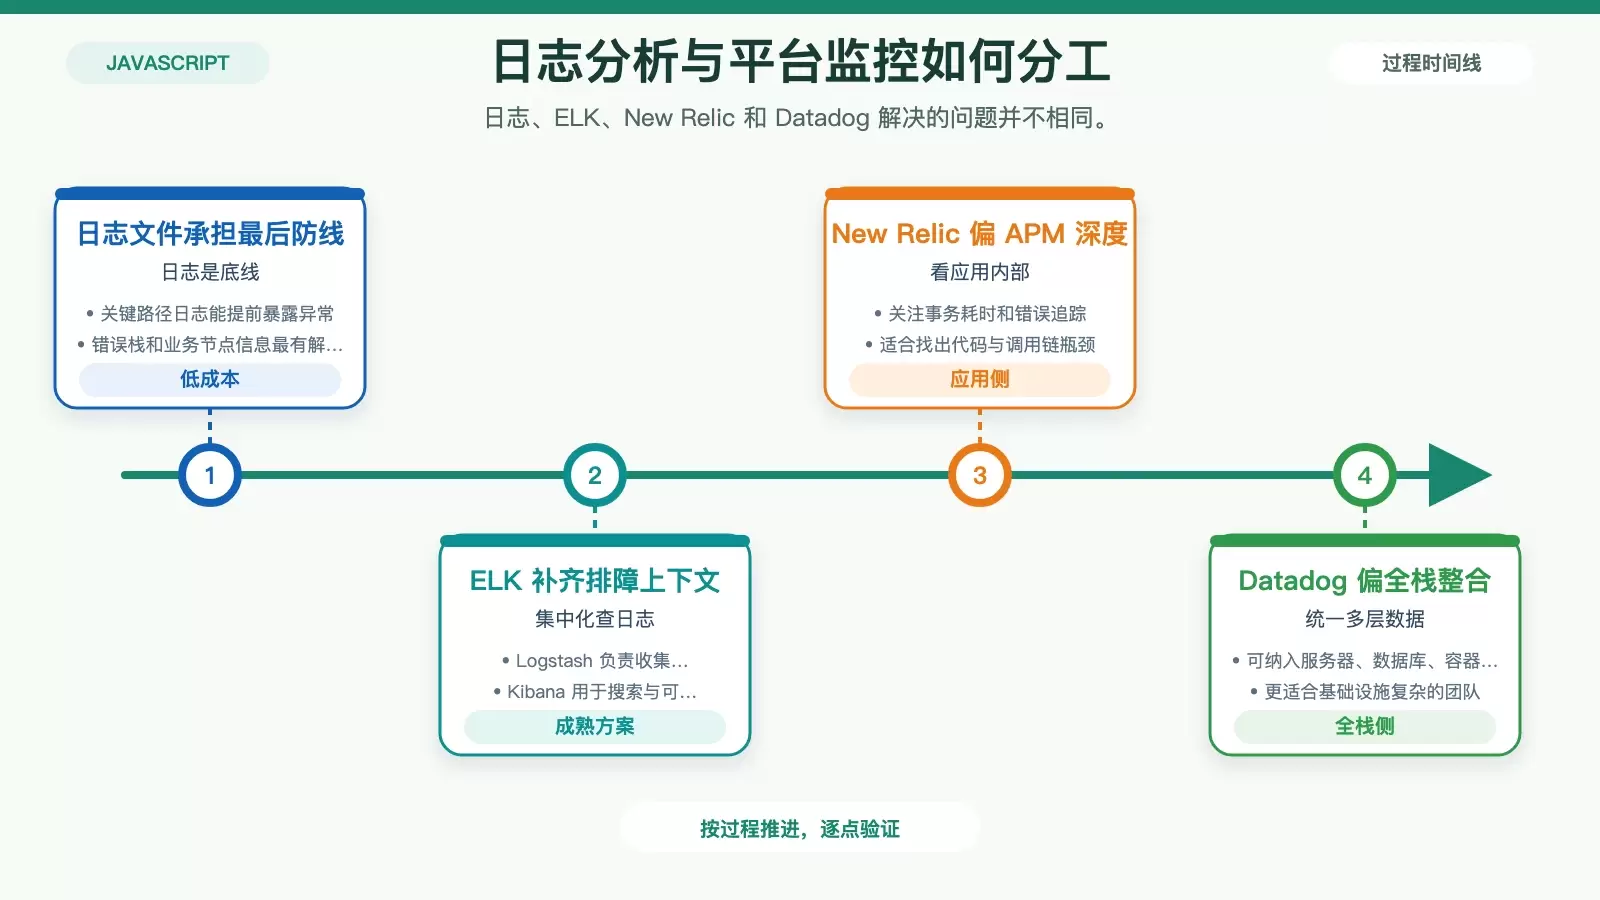
在关键路径上保留清晰日志,定期检查日志文件,往往能在问题扩大之前发现苗头。这也是成本最低、覆盖面最广的一层监控手段。
ELK Stack:适合做集中化日志分析
当应用实例变多、日志量变大,单纯翻文本文件就不够用了。ELK 也就是 Elasticsearch、Logstash、Kibana 的组合,正是为这种场景准备的。
你可以用 Logstash 收集 Node.js 应用日志,再通过 Kibana 做搜索、过滤和可视化分析。对于排查难以复现的 Bug、追踪慢请求上下文、比对某段时间内的异常日志,ELK 仍然是相当成熟的方案。
需要深挖性能瓶颈时,可以直接用 Node.js 内置 Profiler
如果你已经确认问题出在应用内部,并且需要进一步看函数调用频率、内存分配等更底层的数据,那么 Node.js 自带的 Profiler 值得用起来。
Node.js 提供了 --inspect 和 --prof 这类命令行标志,可以在不依赖外部平台的情况下采集性能分析信息。这类工具的优势是轻量、贴近运行时本身,适合做深度性能调优。
不过它对使用者的分析能力要求更高。换句话说,它更像精密诊断工具,而不是面向日常巡检的可视化面板。
怎么选:按项目阶段搭配,比追求万能平台更实际
如果只是个人开发或小项目,top、htop 加日志文件,通常已经能覆盖最常见的问题排查。
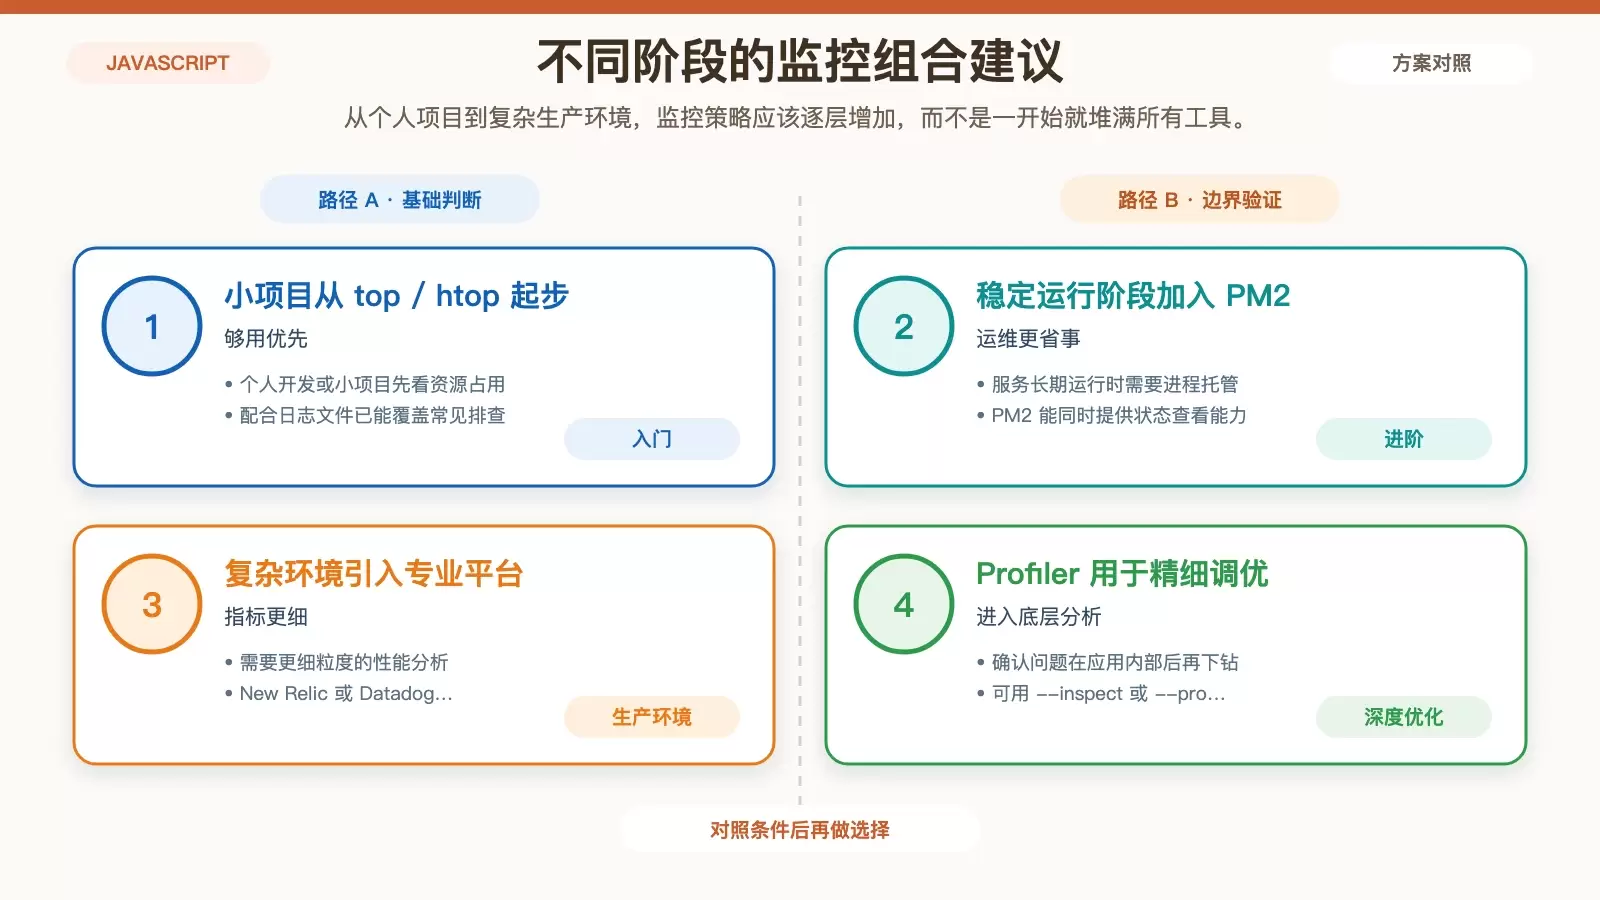
如果服务进入长期运行阶段,需要顺手管理进程、查看实例状态,PM2 会比纯命令行更省事。
如果已经进入生产环境,且需要更细粒度的性能分析,New Relic 或 Datadog 这类专业平台会更合适。前者更偏应用性能洞察,后者更适合复杂基础设施的一体化监控。
至于日志管理,ELK 依然是成熟且可靠的选择;而当你要真正做深度性能优化时,Node.js 自带的 --inspect、--prof 也不该被忽略。
结论很简单:没有绝对最好的 Node.js 监控工具,只有和当前阶段匹配的组合。先解决“看得见”,再逐步补齐“看得深”和“看得全”,通常才是 Linux 环境下更稳妥的路线。









