

C# XmlReader读取XML:流式处理与内存优化详解

在处理大型XML文档时,传统的 XmlDocument 和 XElement 会将整个文档加载到内存中,导致资源消耗过大。相比之下,XmlReader 采用流式处理方式,能显著节省内存。本文通过 C# 代码示例,详细演示如何利用 XmlReader 的 Read() 方法逐节点扫描 XML,并解析节点名、属性及文本内容,帮助您掌握高效且低耗的 XML 解析方案。
为什么选择 XmlReader
XmlDocument 和 XElement 虽然操作简便,但需要将整个 XML 文档树构建在内存中。对于结构复杂或体积庞大的文件,这种方式极易引发内存溢出。当场景要求尽可能节省内存时,XmlReader 和 XmlWriter 是更优的选择。它们以向前只读流的方式工作,仅读取当前节点的信息而不缓存整篇文档。
操作步骤:使用 XmlReader 解析 XML
第1步:准备环境并初始化 XmlReader
首先,需要引入 System.Xml 命名空间。创建一个包含 XML 内容的字符串(或通过文件/流输入),并使用 StringReader 作为参数,调用 XmlReader.Create() 静态方法创建 XmlReader 实例。建议使用 using 语句确保资源被正确释放。
using System;
using System.IO;
using System.Xml;

namespace UseXmlReader
{
    class Program
    {
        static void Main(string[] args)
        {
            // 声明StringReader传入Xml文本,作为XmlReader.Create的参数
            using (StringReader strRdr = new StringReader(@"<?xml version=""1.0"" encoding=""utf-8"" ?>
<root>
    <cat color=""white">I'm a Cat</cat>
    <dog color=""yellow""/>
</root>"))
            {
                // 通过XmlReader.Create静态方法创建XmlReader实例
                using (XmlReader rdr = XmlReader.Create(strRdr))
                {
                    // 后续解析逻辑在此处展开
                }
            }
        }
    }
}
第2步:循环读取节点并判断类型
核心逻辑在于调用 rdr.Read() 方法。该方法每执行一次,阅读器便前进到下一个节点,直到文档结束返回 false。在循环中,通过 rdr.NodeType 判断当前节点类型(如元素开始、元素结束、文本等)。
- 开始节点 (
XmlNodeType.Element):可通过rdr.Name获取标签名。若需获取属性值(如color="white"),可直接使用中括号索引器rdr["attributeName"]。 - 结束节点 (
XmlNodeType.EndElement):同样可通过rdr.Name获取闭合标签的名称。
第3步:提取节点内容与属性
当识别出目标元素(如 cat)的开始标签后,若要获取其内部的文本内容(如 "I'm a Cat"),需要再次调用 rdr.Read() 移动到文本节点,此时通过 rdr.Value 即可读取文本数据。注意空元素(如 <dog />)可能没有内部文本节点,需根据实际 XML 结构调整读取逻辑。
// 循环Read方法直到文档结束
while (rdr.Read())
{
    Console.WriteLine("rdr.NodeType = " + rdr.NodeType);

    // 如果是开始节点
    if (rdr.NodeType == XmlNodeType.Element) {
        string elementName = rdr.Name;
        Console.WriteLine(elementName + " element start");

        if (elementName == "cat")
        {
            // 可以通过中括号获得属性值
            string colorVal = rdr["color"];
            Console.WriteLine("\tcat's color is " + colorVal);

            // 读取到节点内文本内容
            if(rdr.Read()) {
                // 通过rdr.Value获得文本内容
                Console.WriteLine("\t cat said:" + rdr.Value);
            }
        }
    }
    else if (rdr.NodeType == XmlNodeType.EndElement)
    {
        // 在节点结束时也可以通过rdr.Name获得节点名字
        string elementName = rdr.Name;
        Console.WriteLine(elementName + " element end");
    }
}
XmlReader 读取顺序分析
XmlReader 严格按照 XML 文档的物理结构逐次扫描。以下通过图示说明了针对上述示例 XML 的读取流程:
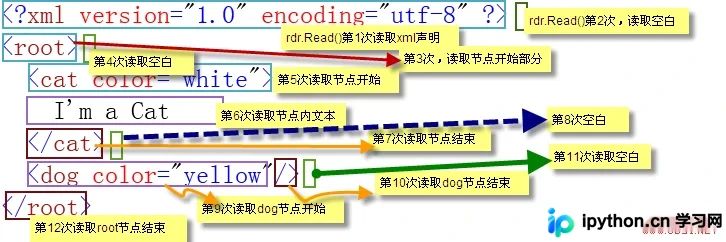
从图中可以清晰地看到每次 Read() 调用的具体行为:
- 第1次 Read():读取 XML 文档声明部分(
<?xml ... ?>)。 - 第2次 Read():读取声明后的空白字符。
- 第3次 Read():读取根节点
root的开始标签。 - 第4次 Read():读取根节点开始后的空白字符。
- 第5次 Read():读取
cat节点的开始部分(包括标签名及所有属性)。 - 第6次 Read():读取
cat节点内的文本内容。 - 第7次 Read():读取
cat节点的结束标签。 - 第8次 Read():读取
cat结束标签后的空白字符。 - 第9次 Read():读取
dog节点的开始部分(自左尖括号至结束斜杠前)。 - 第10次 Read():读取
dog标签的自闭合结束符/>。 - 第11次 Read():读取
dog标签结束后的空白字符。 - 第12次 Read():读取根节点
root的结束标签。
理解这一顺序有助于准确判断何时该获取属性、何时该获取文本,避免逻辑错位。
总结
XmlReader 提供了对 XML 流的细粒度控制能力,特别适合处理大文件或仅需提取部分数据的场景。虽然相比 DOM 解析代码量稍多,但其带来的内存效率提升是显著的。以上就是基于C#中XmlReader读取Xml的详细流程与原理,更多关于C#高级编程的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









