

SQL 中使用 ROW_NUMBER() 分组获取每组第一条记录的详解

在处理关系型数据库时,经常需要从不同组别中提取特定条件的单条记录(如每人的最高工资、每个城市的第一条员工信息)。本文将演示如何结合 ROW_NUMBER() 窗口函数与子查询,利用 PARTITION BY 分组和 ORDER BY 排序,优雅地获取分组后的第一条数据。
问题背景与解决方案概述
在使用标准 SQL(如 MySQL 8.0+、PostgreSQL、SQL Server、Oracle 等支持窗口函数的数据库)时,直接按组过滤首条记录较为复杂。传统的做法通常涉及自连接或子查询配合聚合函数。现代 SQL 提供了更直观的窗口函数 ROW_NUMBER(),它可以为分区内的每一行分配一个唯一的顺序号,从而实现高效的数据抽取。
准备条件与环境
为了清晰展示效果,我们将使用经典的 Northwind 示例数据库中的 Employees 表。该表中包含员工的基本信息,其中 City 字段仅有少量不同的城市值,非常适合作为分组依据进行演示。
操作步骤
第1步:查看原始数据分布
首先,我们需要了解 Employees 表的数据情况,特别是 City 字段的取值范围。这将帮助我们理解后续分组的效果。
操作结果:
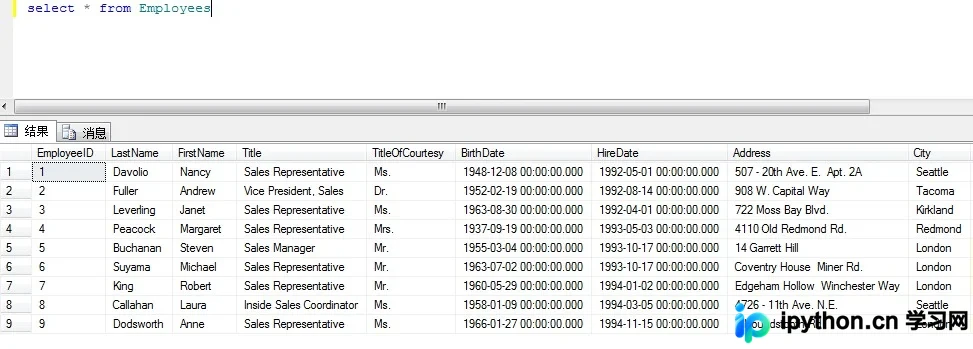
从上图可见,City 列仅包含有限的几个城市名称,这意味着后续的分组数量不会太多,便于观察。
第2步:使用 ROW_NUMBER() 生成分组序号
这是核心步骤。我们需要使用窗口函数 ROW_NUMBER() OVER (PARTITION BY ... ORDER BY ...)。
- PARTITION BY City:指定按照
City列进行分组。同一城市的记录会被划分到同一个“窗口”中。 - ORDER BY EmployeeID:在每个城市内部,按照
EmployeeID(员工ID)升序排列。这决定了谁排在第一位。
该函数会为每条记录计算出一个序列号,表示其在当前分组内排序后的位置。组内的序列号是连续且唯一的。
SQL 语句如下:
SELECT
    EmployeeID,
    LastName,
    FirstName,
    Title,
    TitleOfCourtesy,
    City,
    ROW_NUMBER() OVER(PARTITION BY City ORDER BY EmployeeID) AS new_index
FROM Employees;
执行结果示意:
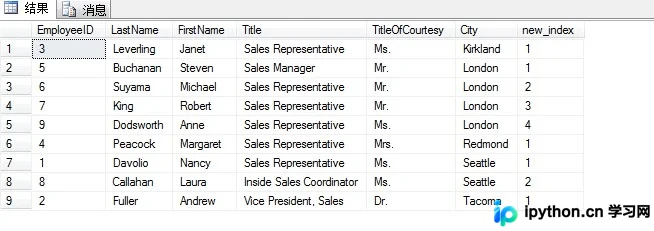
执行后可以看到,结果集中增加了一列 new_index。系统已经按照 City 进行了分组,并在组内根据 EmployeeID 的大小进行了排序编号。
第3步:筛选每组的第一条记录
既然我们已经有了组内序号,只需筛选出 new_index = 1 的记录,即可获得每个城市下 EmployeeID 最小的那一位员工的完整信息。
注意: 由于窗口函数不能直接在 WHERE 子句中引用,我们需要将上一步的查询作为子查询(派生表)包裹起来,然后在外部进行过滤。
SQL 语句如下:
SELECT * FROM (
    SELECT
        EmployeeID,
        LastName,
        FirstName,
        Title,
        TitleOfCourtesy,
        City,
        ROW_NUMBER() OVER(PARTITION BY City ORDER BY EmployeeID) AS new_index
    FROM Employees
) a WHERE a.new_index = 1;
最终执行结果:
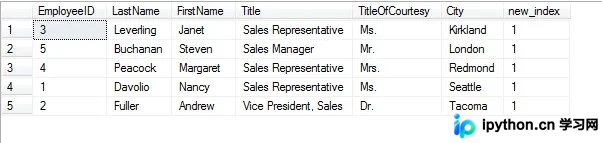
如上所示,返回的结果中,每个城市仅保留了一条记录,且是该组内按 EmployeeID 排序后的第一条。
总结与扩展
通过上述步骤,我们成功实现了“分组获取第一条记录”的需求。这种方法的优势在于逻辑清晰,且适用于大多数主流关系型数据库。
- 改变排序逻辑:如果目的是获取每个城市的最新一条记录(假设有一列
HireDate),只需修改ORDER BY部分为ORDER BY HireDate DESC即可。 - 替代方案:在不支持窗口函数的旧版数据库中,通常需要使用
GROUP BY配合子查询查找最大/最小 ID,写法较为繁琐且性能可能不如窗口函数优化得好。
以上就是 SQL 语句分组获取记录的第一条数据的详细内容,更多关于 SQL 窗口函数优化的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









